


В реальной жизни люди иногда говорят на смеси языков, например — русского и английского, а порой и переключаются между разными языками во время диалога. Особенно это характерно для международных компаний, у которых сотрудники, клиенты и партнёры могут быть из разных стран. Для систем преобразования речи в текст (ASR) переключение между языками представляет сложность. Они определяют язык диалога по первым репликам и фиксируют его кодовое обозначение, а при смене языка начинают вести себя непредсказуемо. Одни модели заменяют иностранные слова латиницей, другие — подбирают похожие по звучанию (но неверные по смыслу) слова из русского языка, третьи — просто игнорируют нераспознанные фрагменты.
Существенных успехов в решении этой проблемы добились специалисты по обработке аудиоданных из лаборатории искусственного интеллекта российской ИТ-компании «Криптонит». Они разработали методику дообучения моделей транскрибирования речи, устойчивую к переключению языка собеседников. Она позволяет добавить поддержку смены языка (code-switch) в Whisper, GigaAM и другие модели ASR.
Эта разработка может применяться в любых системах обработки речи. Например, для транскрибации совещаний, обработки диалогов технической поддержки, в универсальных приложениях для голосового ввода, для анализа больших массивов речевых аудиоданных, словом — везде, где требуется качественное распознавание аудиозаписей на смеси языков.
Как дорабатывали модель
Исследование проводилось на кластере следующей конфигурации: 2 процессора AMD EPYC 9334, 756 ГБ оперативной памяти, 4 ускорителя NVIDIA L40S (по 48 ГБ GDDR6), NVMe SSD 2 ТБ.
Исходной моделью стала GigaAM Multilingual от Сбера с лицензией MIT (позволяет изменять и использовать модель в коммерческих целях). Для оценки качества использовались как собственные, так и открытые бенчмарки. Отдельно проводился контроль на монолингвальной речи (проверка отсутствия деградации модели после дообучения).
Команда подготовила собственные синтетические данные для дообучения модели. Они создавались из наборов аудиозаписей с реальной монолингвальной частью, датасетов YODAS (ESPnet Team), Sova (Virtual Assistant, LLC) и других. В работе использовались два типа синтетических данных: склеек фрагментов на двух языках и TTS-синтеза с частичным переводом предложений. Общий объём составил около 10 000 часов речевых аудиозаписей.
Акустическая модель ASR обрабатывает аудиопризнаки и предсказывает вероятности токенов — единиц словаря модели, которые не обязательно совпадают со словами. На этапе декодирования система совместно использует акустическую и языковую модели: первая оценивает, насколько аудио соответствует гипотезе о произношении, а вторая — насколько правдоподобна получающаяся последовательность токенов. В результате декодер рассматривает несколько гипотез и выбирает наиболее вероятную.
Одним из классических способов языкового моделирования считается n-граммная модель, в которой вероятность токена зависит от нескольких предыдущих (например, в 4-граммной модели — от трёх предыдущих). Для эффективной работы с такими моделями Кеннетом Хифилдом была создана открытая библиотека KenLM, оптимизирующая хранение и скорость запросов к n-граммным языковым моделям. Сейчас она широко применяется NVIDIA и другими разработчиками ASR, поэтому в данной работе она тоже была задействована.
Результаты
В исследовательской работе были экспериментально подтверждены следующие гипотезы:
· даже наборы речевых данных на одном языке (моноязычные корпуса) повышают качество распознавания после дообучения открытой модели;
· обучение на моноязычных корпусах с использованием синтетических данных улучшает WER, но недостаточно для достижения оптимального качества;
· библиотека KenLM уменьшила процент ошибочного смешивания алфавитов в рамках одного слова.
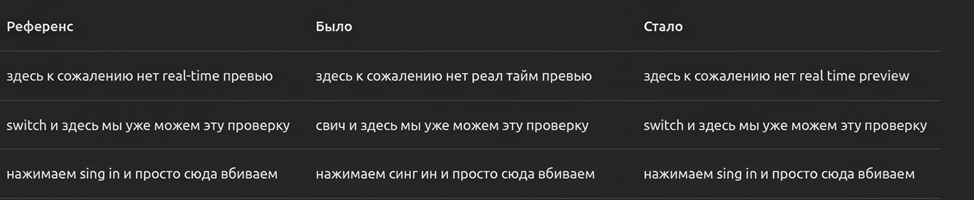
Ключевая метрика для оценки качества систем распознавания речи обозначается WER (Word Error Rate). Она показывает процент слов, которые модель распознала неправильно. В ходе эксперимента на CS-бенчмарках WER в среднем был уменьшен на 13,6%. То есть, после дообучения модель стала значительно точнее распознавать слова на смеси языков в одном диалоге.
Выводы
В рамках проекта была создана модель распознавания речи, которая работает в режиме Code Switch и демонстрирует WER лучше, чем у исходной открытой модели. Разработанная методика позволяет дообучить модель так, чтобы она качественно распознавала смену языков во время разговора. Эксперимент проводился для пары русский и английский язык, но сам рецепт — универсальный. На имеющемся оборудовании процесс дообучения занимает от 1 до 3 недель в зависимости от объёма данных.
Авторы планируют исследовать методы Language Diarization — автоматического разделения аудиозаписи на сегменты, соответствующие разным языкам. Это позволит существенно улучшить качество системы распознавания речи для смеси языков за счёт маршрутизации (без дообучения ASR моделей). Также в планах исследователей обучить модель на базе Whisper V3 Large с поддержкой переключения между множеством языков.
Автор: AI-SHA

