


Открытый плагин для Claude Code / OpenCode с solve-task — от задачи до реализации без ручного сбора контекста.
Работаю с AI-ассистентами в реальной разработке уже достаточно давно, чтобы понимать: главная проблема не в качестве модели. Главная проблема — контекст.
LLM хорошо рассуждает о коде, когда у неё перед глазами правильный код. Но «правильный код» в реальном проекте — это не один файл. Это конкретный символ, его вызывающие, его тесты, смежные PR, существующий паттерн в репозитории, который не стоит ломать.
Получить этот контекст автоматически — задача нетривиальная. Вручную — это каждый раз воспроизводить знание, которое у тебя уже есть, и оплачивать его токенами.
Откуда берётся проблема
Когда работаю с Claude Code через superpowers-скиллы brainstorming, writing-plans, subagent-driven-development), качество результата напрямую зависит от того, насколько точно введена модель в курс дела перед началом.
Для небольших изолированных задач это работает нормально. Но когда задача затрагивает несколько модулей, связана с историей нескольких предыдущих PR или требует понимания конкретного инварианта — нужно либо:
-
Вручную собрать релевантный контекст (файлы, символы, связанные задачи, предыдущие реализации) и передать его в промпт — дорого по токенам, утомительно;
-
Запустить модель без контекста и получить код, который технически корректен, но не встраивается в проект без правок — время уходит на итерации вместо реализации.
Оба варианта — компромисс. Хотелось третий.
Что я нашёл
Репозиторий mimfort/rag_for_git — агент ревью PR на основе RAG + граф кода + Claude Code плагин. Про ревью — потом. Сначала зацепил скилл reviewer_solve-task*.
Идея: вместо того чтобы передавать контекст руками, заранее построить индекс репозитория — векторный + граф вызовов — и отдавать модели именно то, что релевантно конкретной задаче. Автоматически, структурировано, дёшево.
Звучит разумно. Посмотрел реализацию — оказалось, что это не обёртка над grep и не простая семантическая база, а достаточно продуманная система с несколькими уровнями.
Как устроен стек
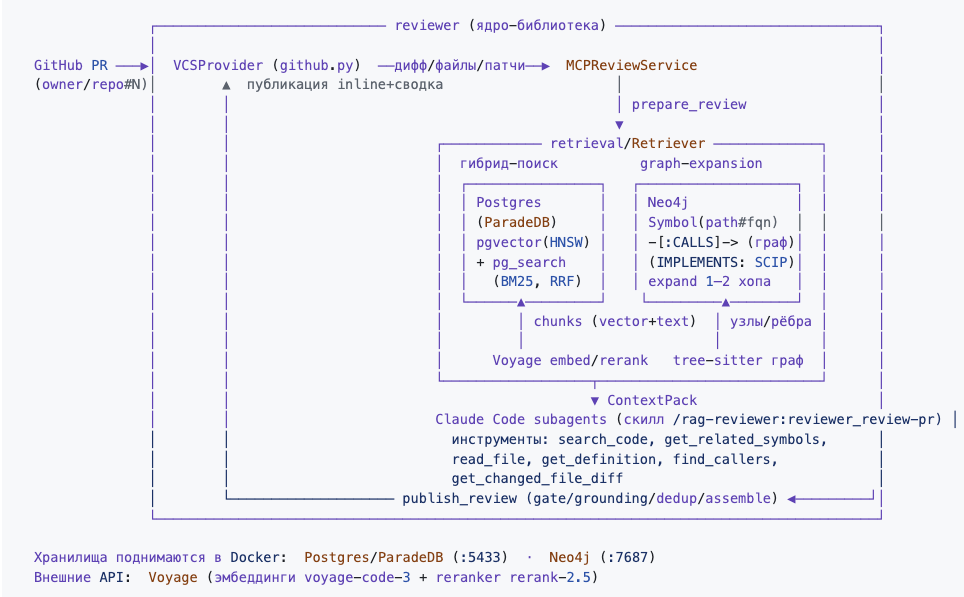
Инфраструктура поднимается в Docker двумя контейнерами:
-
ParadeDB (PostgreSQL + pgvector + pg_search) — хранит векторные эмбеддинги чанков кода и задач. Гибридный поиск: ANN по векторам + BM25 по тексту, слияние через RRF (Reciprocal Rank Fusion).
-
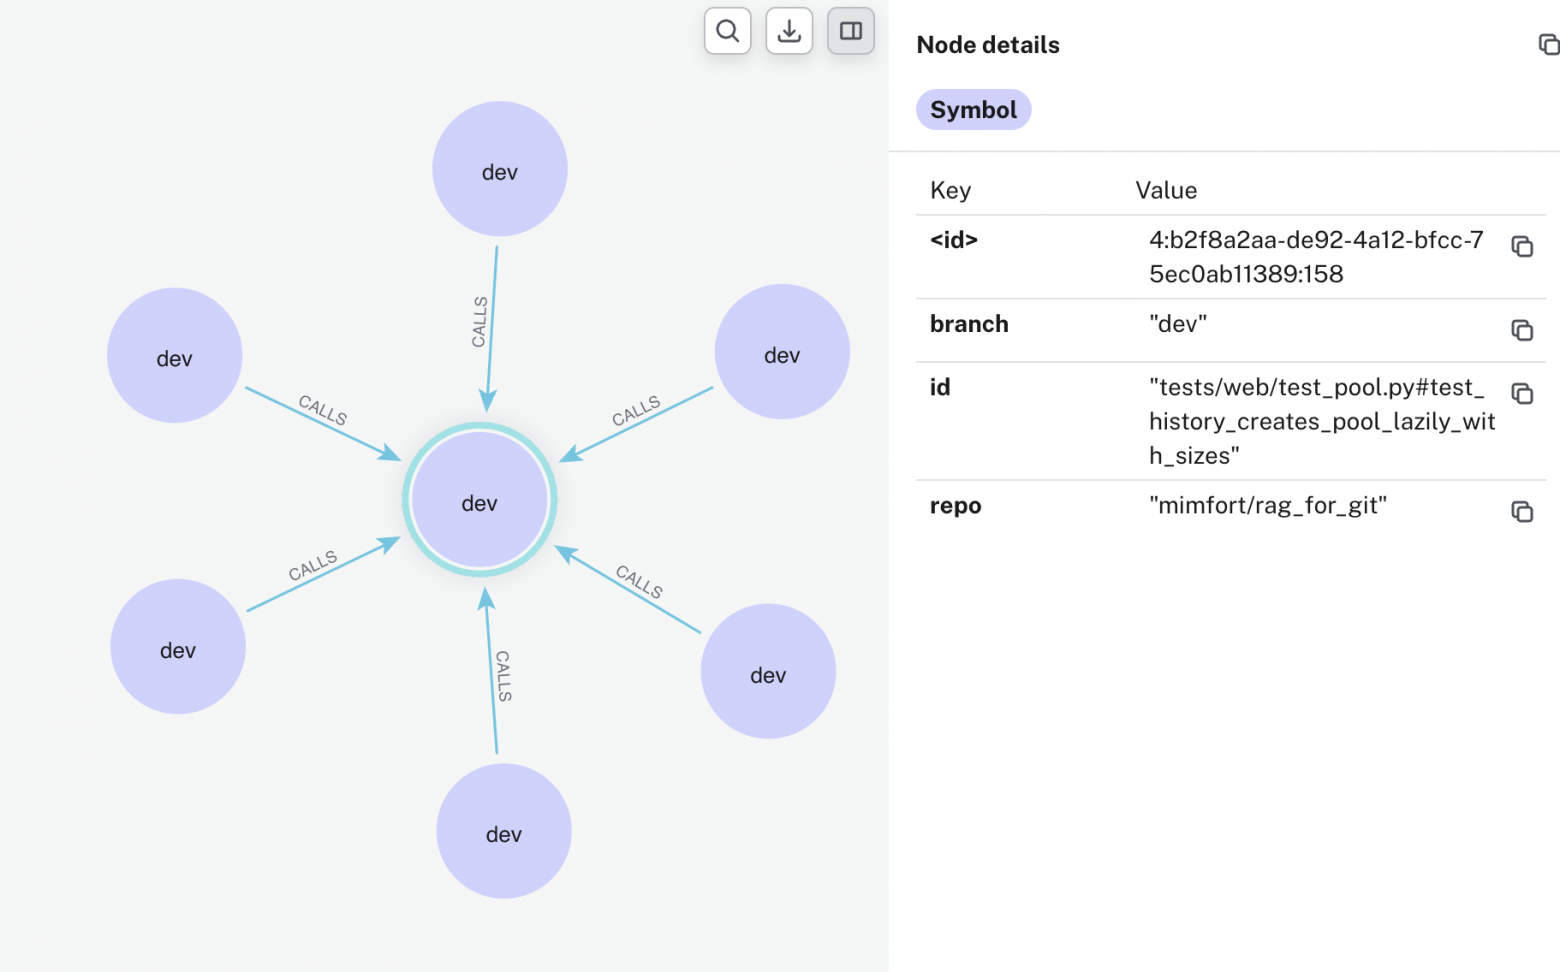
Neo4j — граф кода: узлы :Symbol path#fqn), рёбра CALLS и IMPLEMENTS (последнее — при SCIP-бэкенде через scip-python).
Единый ключ связи между RAG и графом — node_id = “path#fqn” (например, reviewer/api/process.py#validate_input). Один и тот же ключ в чанке Postgres и в узле Neo4j — без маппинг-таблиц.
Индекс строится один раз:
reviewer index /path/to/repo --ref main --repo owner/name
После работает инкрементально: при каждом prepare_review сверяется SHA индекса с HEAD ветки и досинхронизируются только изменившиеся файлы.
Задачи в индексе — без токенов
Отдельная часть — индексирование задач из трекера. Это сделано через server-side ETL: скилл reviewer_sync-tasks вызывает один MCP-тул sync_board, и дальше сервер сам ходит на доску по REST, нормализует задачи в TaskBrief и индексирует батчем через Voyage.
LLM не перечисляет доску, не передаёт текст задач — всё это Python на стороне reviewer-mcp. Стоимость болк-синка — O(1) токенов Claude независимо от размера доски.
Инкрементальность через timestamp-watermark: повторный синк трогает только новые/изменённые задачи.
Что делает solve-task
Скилл — не просто поиск по индексу. Это дисциплинированный пайплайн сбора контекста с несколькими шагами.
Preflight. Проверяет свежесть индекса reviewer status), запускает инкрементальный синк задач, проверяет наличие сводок подсистем (GraphRAG-приор для архитектурного контекста).
Идентификация задачи. Если передан ключ (например PRI-42), сначала ищет в локальном сторе — preflight уже синхронизировал доску. При промахе — фолбэк на board-MCP.
Сбор контекста (fail-open):
-
get_subsystem_summaries — архитектурный приор: какие подсистемы релевантны запросу
-
get_task_context — граф задачи: линкованные задачи, их PR, затронутый код
-
search_tasks — семантически похожие задачи из истории
-
search_codebase — гибридный поиск по базе: релевантные файлы и символы
-
Опционально: get_pr_diff для похожих исторических задач, related_symbols / callers из графа для центральных символов
Фильтрация. Жёсткий cap: ≤3 задачи, ≤5 файлов/символов. Включаются только те, что непосредственно нужны для реализации. Остальное — в (dropped N: причина).
Бриф → разработка. Компактный структурированный markdown, который идёт в superpowers:brainstorming — и дальше полный superpowers-цикл: brainstorming → writing-plans → subagent-driven-development → executing-plans.
Как это выглядит на практике
/rag-reviewer:reviewer_solve-task PRI-154
Получаю примерно такой бриф:
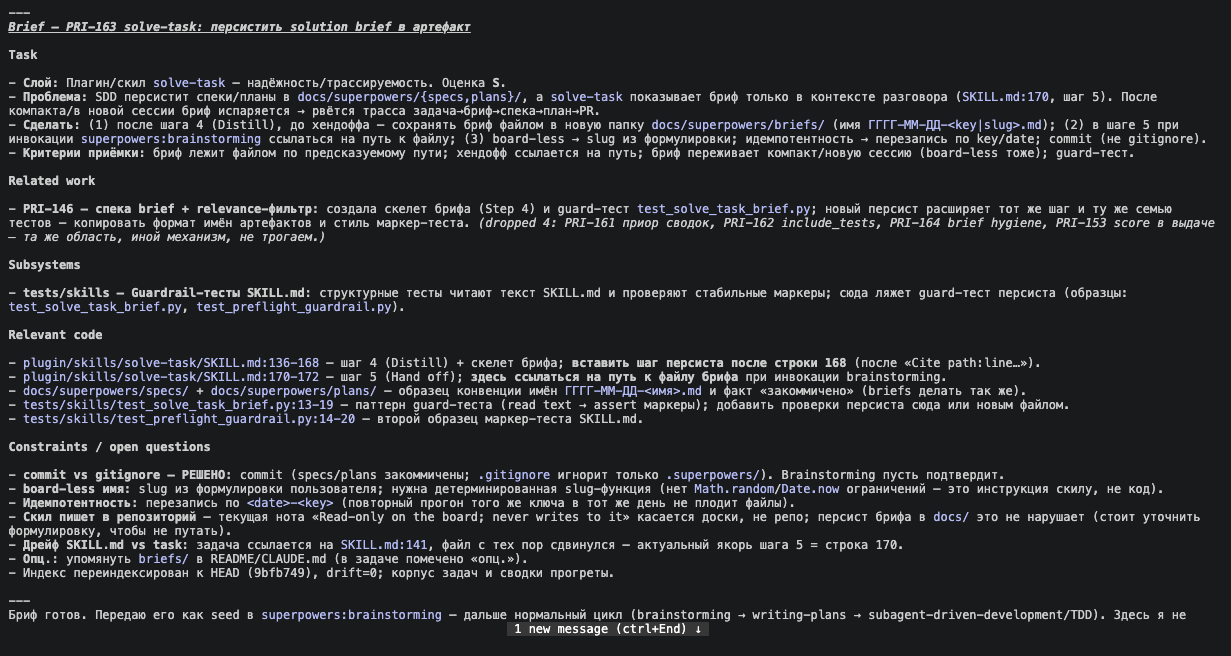
# Brief — PRI-154 Добавить валидацию параметров


## Task

Реализовать валидацию входящих параметров для /api/v1/process.

Критерии: 400 при отсутствии required-поля; логировать невалидный запрос.


## Related work

PRI-120 — валидация в /api/v1/ingest, паттерн с Pydantic можно повторить

PRI-98 — добавление логирования: использовали structured_log()


## Relevant code

reviewer/api/ingest.py:45 — существующий пример валидации, паттерн для копирования

reviewer/tools/base.py:12 — базовый класс, который нужно расширить

(dropped 3: утилиты общего назначения, задача их не затрагивает)


## Constraints

Индекс отстаёт на 2 коммита — предупреждение показано, работаю на stale-базе
После этого скилл входит в brainstorming — и дальше обычный цикл, но уже с правильным контекстом внутри.
Разница: модель видит конкретный path:line, знает существующий паттерн и историю похожих задач — не строит с нуля.
Про стоимость
Voyage AI — внешний сервис эмбеддингов. Но у него есть бесплатный пул, который покрывает реальное использование:
-
Полная индексация среднего Python-репозитория — в бесплатном тире
-
Query-эмбеддинги при поиске — мизер
-
Болк-синк задач — ноль токенов Claude, всё Python на стороне сервера
Что стоит денег — токены Claude при анализе в brainstorming и subagent-driven-development. Но это уже осмысленная работа, а не «холостые» токены на объяснение архитектуры.
Эмбеддинги переиспользуются между ветками по content_hash — если код не изменился, Voyage не дёргается.
Установка
# CLI (один раз, глобально)

uv tool install rag-reviewer


# Инфраструктура

curl -O https://raw.githubusercontent.com/mimfort/rag_for_git/main/docker-compose.yml

docker compose up -d   # ParadeDB :5433 + Neo4j :7687


# Ключи — интерактивный wizard

reviewer init   # спросит VOYAGE_API_KEY, GITHUB_TOKEN и опциональные группы


# Прописать MCP-сервер в редакторы

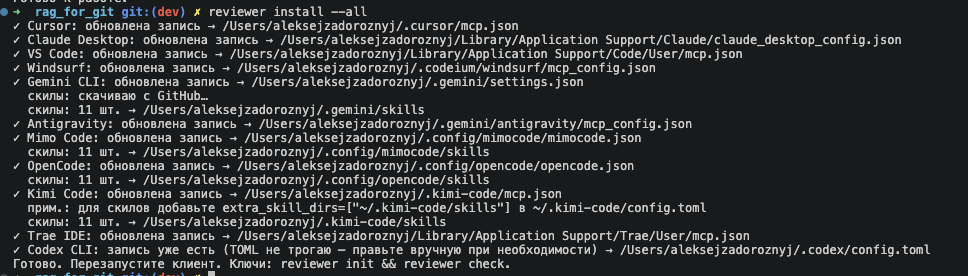
reviewer install --all   # авто-определяет установленных клиентов


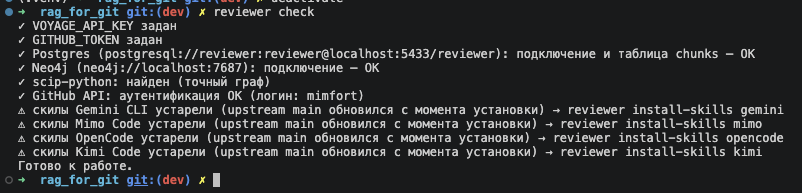
# Проверить

reviewer check
После — построить индекс:
reviewer index /path/to/repo --ref main --repo owner/name
Синхронизировать задачи:
# В Claude Code / OpenCode:

/rag-reviewer:reviewer_sync-tasks
Граф кода — полезен сам по себе
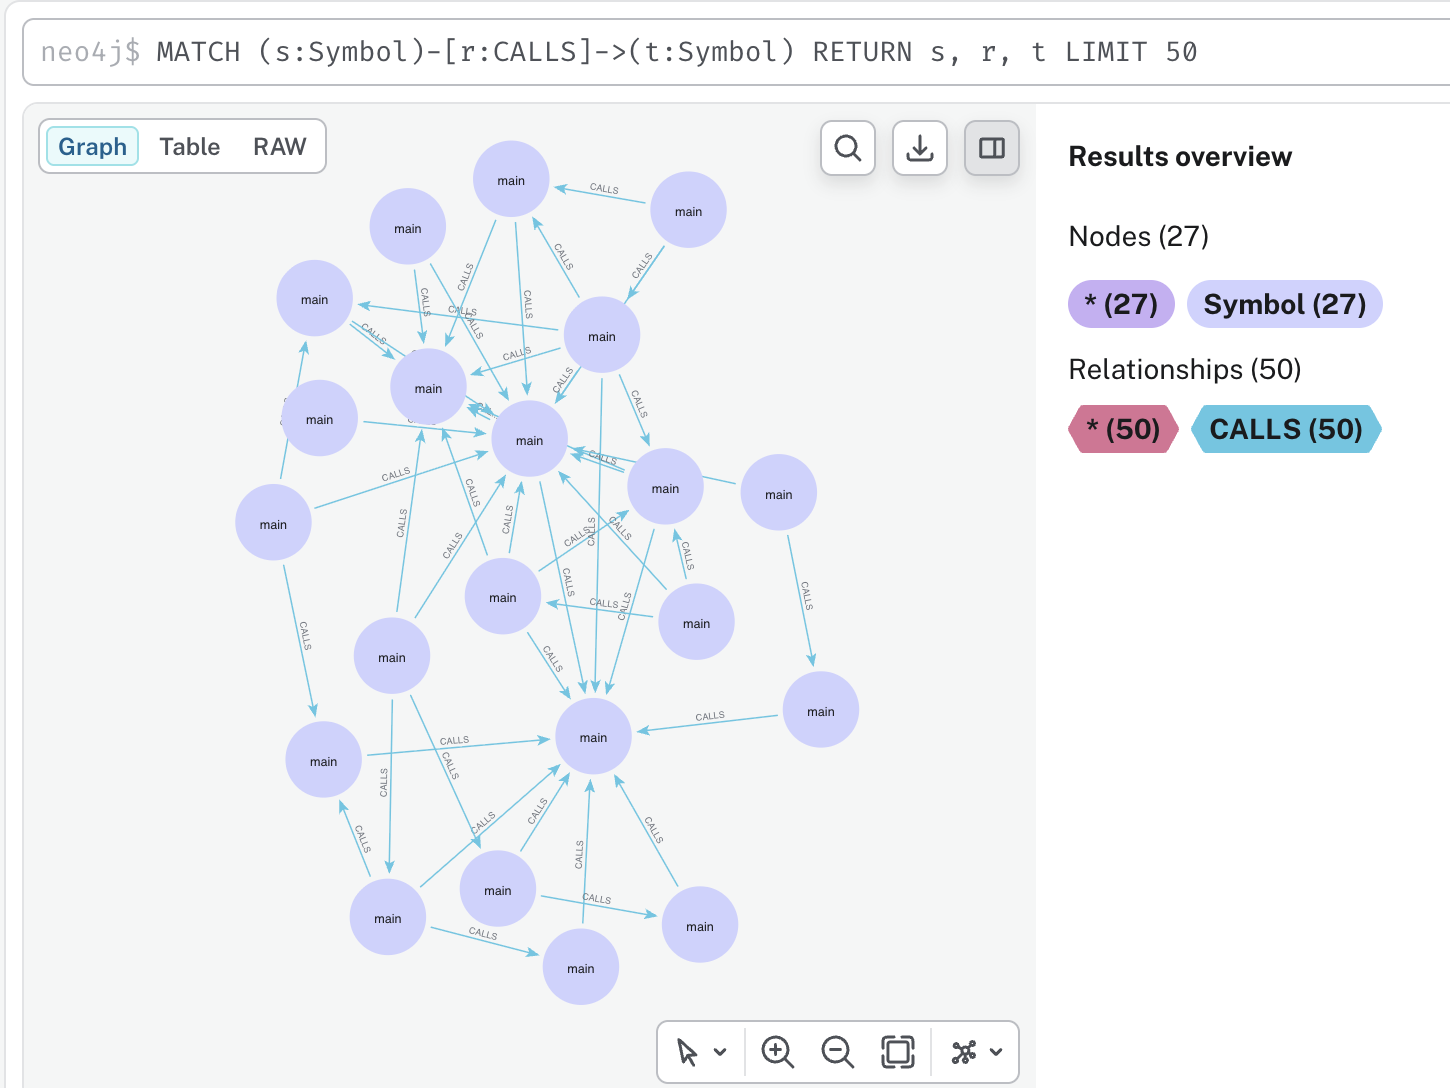
Несколько запросов, которые показывают суть:
-- Входящие вызовы конкретного символа (blast-radius)

MATCH (caller:Symbol)-[:CALLS]->(target:Symbol

  {id: "reviewer/api/process.py#validate_input"})

RETURN caller.id, target.id


-- Граф задачи: что менялось при реализации

MATCH (t:Task {key: "PRI-154"})-[:IMPLEMENTED_BY]->(p:PR)-[:TOUCHES]->(s:Symbol)

RETURN t.title, p.number, s.id


-- Сводки подсистем (после summarize-subsystems)

MATCH (s:SubsystemSummary {repo: "owner/name"})

RETURN s.cluster_key, s.title ORDER BY s.cluster_key
Claude Code и OpenCode
Использую плагин с обоими. Для Claude Code — через marketplace:
/plugin marketplace add mimfort/rag_for_git

/plugin install rag-reviewer@rag-reviewer-marketplace
Для OpenCode и других — через reviewer install. Поддерживаются: Claude Code, OpenCode, Cursor, Windsurf, Gemini CLI, VS Code, Kimi Code, Mimo Code, Codex CLI, Trae IDE, Claude Desktop.
Что ещё в плагине
solve-task — не единственная точка входа. Тот же индекс используется для:
-
reviewer_review-pr* — автоматическое ревью PR: inline-комментарии на строки диффа + сводка. Находит баги с контекстом «кто ещё сломается» (граф blast-radius), отсекает галлюцинации через verify-проход.
-
reviewer_ask* — обоснованный Q&A по коду с цитатами path:line; ответ строится на реальном поиске по индексу, а не на параметрическом знании модели.
-
reviewer_pr-walkthrough* — человекочитаемый гид по PR для живого ревьюера: что меняет каждый файл, на что влияет.
-
reviewer_summarize-subsystems* — GraphRAG-сводки по подсистемам; высокоуровневый архитектурный приор, который потом используется в solve-task и ask.
Итого
Проблема не в том, что LLM плохо пишет код. Проблема в том, что ей нужен контекст — правильный, компактный и бесплатный по токенам. solve-task решает именно это: структурированный сбор контекста по задаче с дешёвым хранилищем под капотом.
Репозиторий: github.com/mimfort/rag_for_git
PyPI: uv tool install rag-reviewer
Если пробовали с другими трекерами (Jira, YouTrack, Linear) или другими AI-клиентами — интересно услышать в комментариях.
Автор: mimfort074

