


Привет! Я Саша Сыч, руководитель отдела тестирования в группе компаний «Синтека». Мы разрабатываем софт для строительной отрасли. В начале года инвестор предложил всем в компании внедрять ИИ — вплоть до уборщицы на этаже. Доклад об этом на нашей внутренней конференции я назвал «СдохнИИ или умрИИ»: примерно с таким настроением нам поставили задачу. Эта статья — по мотивам доклада.
Компания разделилась на два лагеря. Первый поддерживал хайп: главное начать, разберёмся потом, смотрите, как ИИ за выходные пилит приложения и рисует красивые графики. Второй стоял на инженерной реальности: чудес не будет, будет много дополнительной работы, и вообще посмотрите, какую ерунду ваш ИИ отвечает. Я успел побывать в обоих лагерях и решил не внедрять ИИ куда попало, а сначала посмотреть, как это делают другие компании: что у них завелось, а что только красиво выглядит. Из этого выбрал задачи, которые стоило проверить у нас.
Куда целились сначала
В других компаниях чаще всего рассказывали об успешном применении ИИ в следующих четырех задачах — мы решили попробовать все:
-
Генерация тест-кейсов. ИИ может готовить черновики проверок для задач и багов.
-
Помощь с автотестами. ИИ может набрасывать кейсы для автотестов и подсказывать по коду тестов.
-
Помощь техподдержке. На второй линии у нас дежурят сами тестировщики, и часть их работы можно отдать ИИ.
-
Ведение документации. ИИ может помочь поддерживать нашу вики в актуальном состоянии, чтобы она не отставала от продукта.
Мы попробовали все четыре. Здесь расскажу только про первую: она ближе всех к внедрению, а её реализация неожиданно завела в куда более интересную задачу.
Зачем нам вообще генерировать тест-кейсы
Сначала о том, как у нас появляются тест-кейсы и где в этом процессе мы решили подключить ИИ. Каждую неделю тестировщики собираются, чтобы обсудить и оценить новые задачи от аналитиков. Перед встречей по каждой задаче делается разбор в виде майндмапы: что именно проверять, какие части продукта затрагивает задача, какие роли участвуют. От того, насколько хорошо составлен этот план, зависит, насколько качественно задачу потом протестируют.
Затем тестировщик несёт майндмапу на встречу с командой. Там все спорят, дополняют карту и в итоге ставят задаче оценку. Самая долгая часть процесса — как раз подготовка майндмапы. Идея была простая: пусть карту рисует ИИ, а мы проверяем её глазами и дополняем, вместо того чтобы каждый раз с нуля ломать голову.
Почему получалась ерунда
Думаю, многие тестировщики начинали так же, как мы: брали описание задачи, отдавали его модели и просили нарисовать майндмапу или составить план проверок. Техники тест-дизайна вроде бы применены, всё чётко, но на выходе получалась ерунда.
Например, у «Синтеки» есть площадка «Продавай», где поставщики выставляют счета. Для модели «продавай» — просто глагол. Не знает она и о наших ролях и регламентах, не понимает, что такое комплект и подразделы бюджета. Теорию тестирования модель знает, а «Синтеку» — нет. И вместо честного «не знаю» начинает выдумывать, а это ещё хуже.
Многие на этом и остановились: получилась фигня, а разбираться некогда — релиз на носу, спринт горит. У меня, в отличие от ребят в спринте, было время копнуть глубже. Оказалось, что модель спотыкается не об ум, а об наш внутренний контекст.
Оставалось понять, как эти знания передать ИИ.
Как передать ИИ наши знания
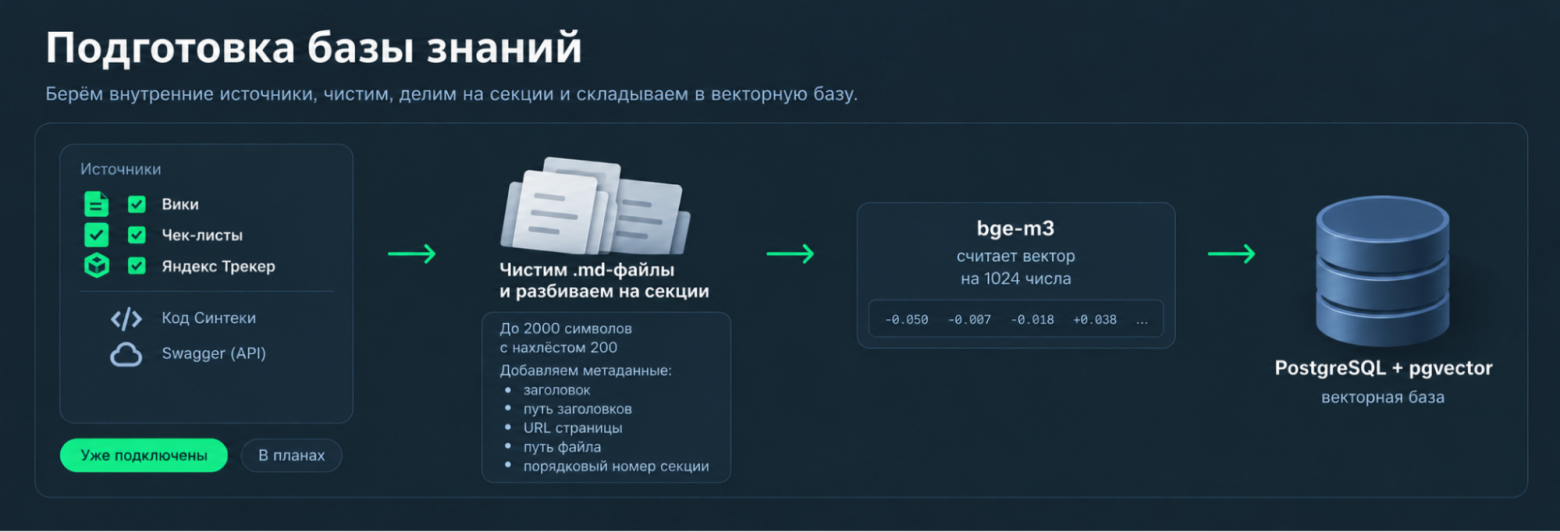
Для начала я выписал шесть источников знаний, которые описывают, как работает «Синтека»: код, вики, регрессионные чек-листы, Яндекс Трекер, Swagger с описанием нашего API и Омнидеск. До дела пока дошли три: вики, чек-листы и Трекер.
Начал с вики и честно перебрал всё, что советуют в интернете:
-
Дал модели ссылку на вики.
-
Потом скачал файлы вики и закинул их в чат.
-
Собрал проект в Claude и положил в него файл-оглавление: если вопрос про счета — смотри такой-то раздел, если про заявки — другой.
Каждый вариант работал чуть лучше предыдущего, и каждый упирался в одно и то же: медленно, дорого, качество так себе. А главная проблема никуда не делась: если ответа в вики не было, модель всё равно сочиняла. Даже когда ей это прямо запретили.
Сработал четвёртый вариант — RAG (Retrieval-Augmented Generation, генерация с опорой на поиск). На каждый вопрос система сама достаёт из наших документов подходящие куски, и модель отвечает строго по ним. Если ничего не нашлось, она так и говорит.
Вики у нас лежит в markdown-файлах. Мы чистим их от служебной разметки и режем по заголовкам на куски до 2000 символов с нахлёстом в 200, чтобы мысль не рвалась на границе. К каждому куску добавляем метаданные: заголовок, путь заголовков, адрес страницы. Дальше каждый кусок переводится в вектор — набор из 1024 чисел, которые описывают его смысл. Это делает bge-m3, открытая модель эмбеддингов: она работает локально на нашем железе и ничего не стоит. Векторы складываем в обычный PostgreSQL с расширением pgvector.
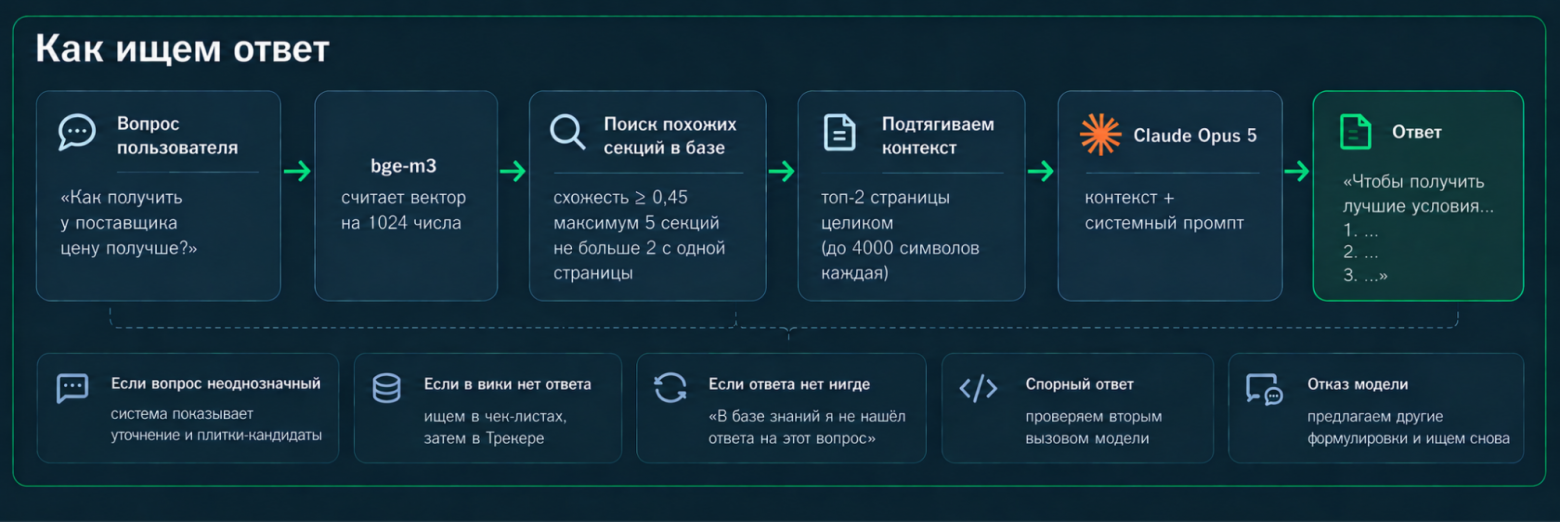
Например, мы задаём вопрос «как получить у поставщика цену получше». Вопрос той же моделью переводится в вектор, и база ищет близкие по смыслу куски. Прежде всего по смыслу, а не по словам: ни «торга», ни «счёта» в вопросе нет, а нужная статья находится.
Для заголовков мы добавили и обычный поиск по словам, он выручает на точных названиях. Из найденного берём не больше пяти кусков со схожестью не ниже 0,45 и не больше двух с одной страницы, иначе одна длинная статья вытесняет остальные. Две лучшие страницы подтягиваем целиком, до 4000 символов каждая, чтобы модель видела связный текст, а не обрывки, и вместе с системным промптом отдаём в Claude Opus 5. Если вопрос неоднозначный, система не гадает: показывает уточнение и плитки-кандидаты, а после выбора отвечает уже в выбранном контексте.
Честное «не нашёл» держится не на пороге схожести. Порог отсекает только совсем чужие вопросы: если ни один кусок его не набрал, модель даже не зовём. Но я взял шесть вопросов, ответов на которые в вики заведомо нет, и порог отсёк только два. По остальным четырём куски нашлись — похожие по словам, но не по делу. При этом система на все шесть честно сказала «не нашёл». Сработало то, что дальше.
Системный промпт запрещает добавлять что-либо сверх найденного, а если ответ есть только на часть вопроса, требует ответить частично и прямо назвать пробел. Готовый ответ проверяется машинно: это ответ или отказ; спорные случаи уходят на второй вызов модели. Отказ схлопывается в одну каноническую фразу, а не в вольную формулировку, иначе «не нашёл» каждый раз звучит по-разному и его не поймать. И после отказа система сама предлагает другие формулировки вопроса и ищет по ним заново, но ответ всегда собирает по исходному вопросу.
Дальше надо было понять, работает ли это вообще.
Как мы проверяем качество ответов
Если каждый ответ проверять вручную, можно сойти с ума. Поэтому я собрал регресс: набор эталонных вопросов и ответов по вики. Вопросы разделил на три группы:
-
Обычные вопросы, ответы на которые точно есть в вики — например, «Как скачать заявку?».
-
Вопросы-обманки: звучат как наши, но ответа на них в вики нет. Например, «Какие роли нужны, чтобы удалить доставку?». Здесь система должна либо честно отказаться, либо переспросить.
-
Вопросы не из нашей вики, вроде «Как испечь шарлотку с яблоками?». Тут единственный правильный ответ: «В базе не нашёл».
Этот набор прогоняется после каждого изменения. Если ответ разошёлся с эталоном, значит, что-то сломали — новый источник, правка в вики — и надо разбираться. Сверяет ответ с эталоном не человек, а модель-судья. Генерирует ответы Claude Opus 5, а судит Claude Sonnet 4.6, и судью мы не меняем принципиально: сменишь линейку, и прошлые замеры станет не с чем сравнить.
По такому же принципу я подключил регрессионные чек-листы, по которым тестировщики проходят перед каждым релизом, а затем закрытые задачи из Яндекс Трекера. Точнее, не задачи целиком, а итоговый комментарий тестировщика с пометкой #RESOLVED: мы много лет пишем его по шаблону, и в нём уже отфильтровано, что в итоге сделали и как проверили.
Почему источники начали мешать друг другу
Я ожидал, что с тремя источниками ответы станут полнее. Вместо этого источники начали мешать друг другу.
Замера «до и после» я не делал: каскад родился из конкретных случаев. В каждом источнике была информация про одни и те же сущности. Про создание заявки что-то написано в вики, что-то в чек-листах, что-то в Трекере. Формулировки и детали расходились, и модель смешивала их в один ответ.
Заодно выросло время ответа: три источника — это три поиска и больше текста в контексте модели.
Решение — опрашивать источники каскадом. Первой идёт вики: она больше всего похожа на продуктовую документацию, с неё начинался RAG, и остальные подключались уже к ней. Если ответа в вики нет, идём в регрессионные чек-листы, а затем в Трекер.
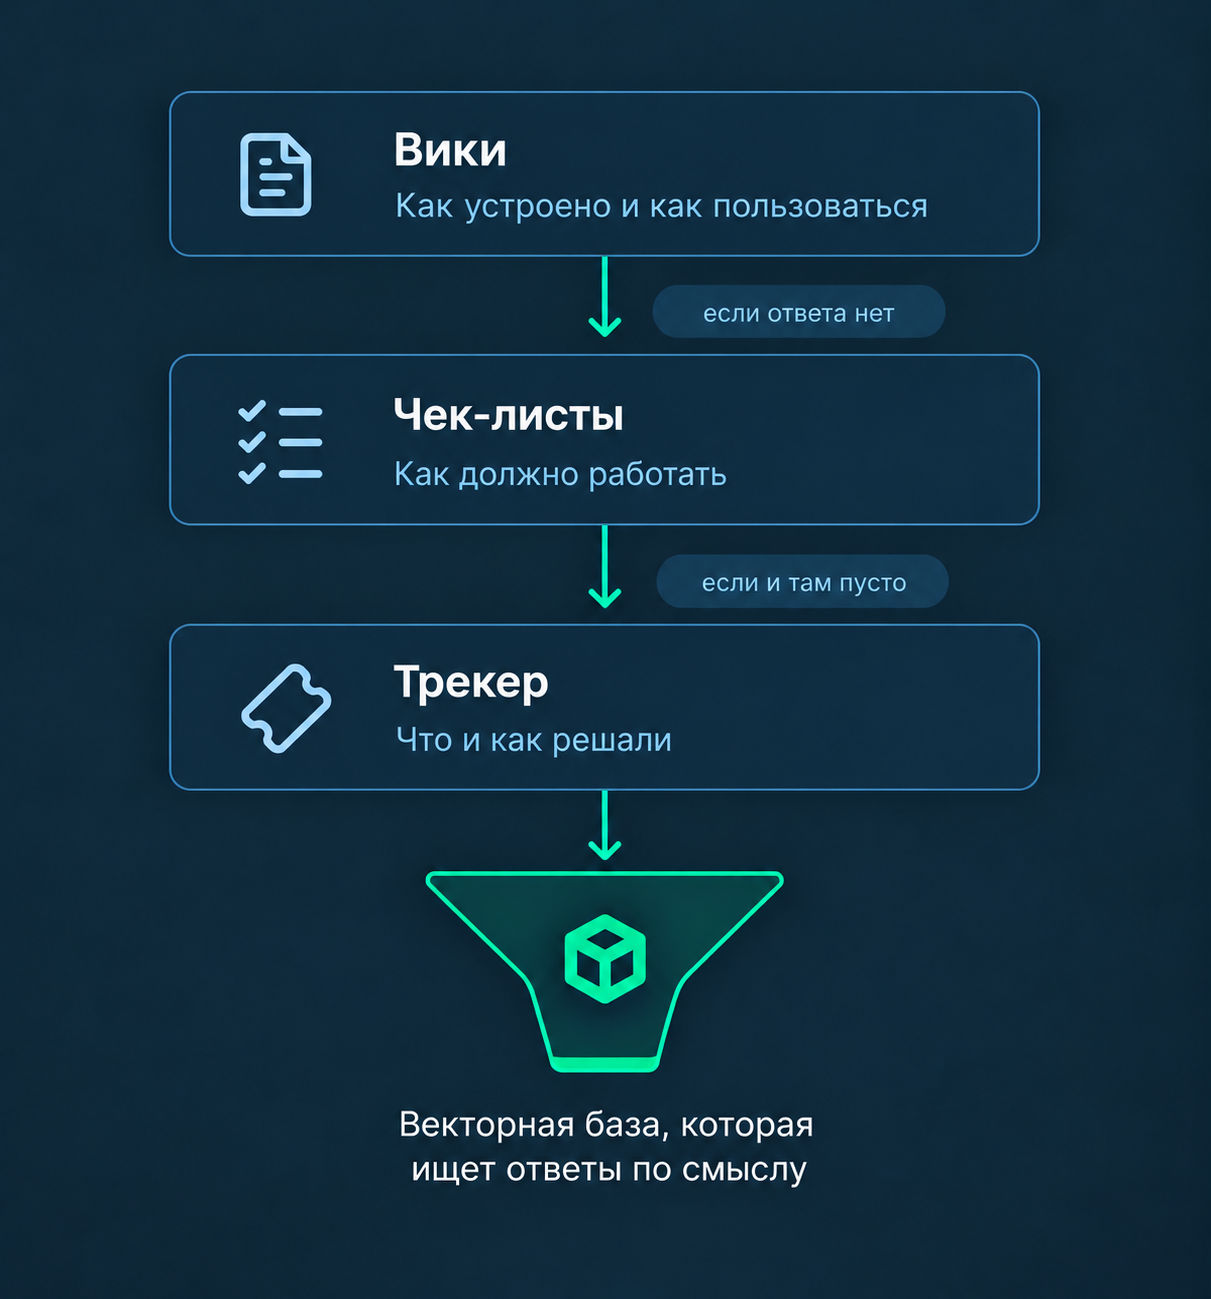
Это же решило проблему со скоростью. Источники опрашиваются по очереди, а не разом: если ответ нашёлся в вики, чек-листы и Трекер не трогаем. В типичном случае работает одна ступень из трёх.
Большинство вопросов закрываются на уровне вики за 10–15 секунд. Самые долгие занимали у меня две-три минуты: это вопросы, которые пришлось переформулировать несколько раз, а ответ нашёлся только в Трекере.
Запретный плод: почему модель не слушалась промпта
Был смешной случай. Модель упорно упоминала в разборах задач площадку «Продавай», даже когда в самой задаче про неё не было ни слова.
Я сделал то, чему учат все руководства: добавил в промпт правило «не упоминай площадку «Продавай», если её нет во входных данных». Запускаю замер — модель уверенно пишет про «Продавай». Начинаю перечитывать промпт, описание задачи и вообще всё, что мы отдаём модели. Слово «Продавай» встречается ровно в одном месте. В моём запрете.
Получилось как с «не думайте о белой обезьяне»: стоит сказать — и вы уже думаете. Конкретный запрет я убрал и сформулировал правило абстрактнее: не упоминай сущности, у которых нет реальной связи с задачей, даже ради строки «не затронуто». Это сработало: лишние упоминания ушли и на следующих замерах не возвращались.
|
Мораль: ИИ читает всё, что вы ему дали. Особенно ваши запреты. |
Из генератора майндмап — в пояс знаний
В какой-то момент стало понятно, что мы собираем уже не просто инструмент для генерации майндмап. Получился целый пояс знаний по «Синтеке», который можно использовать и для других задач.
Сейчас в нем пока три источника: вики рассказывает, как устроена система и как ей пользоваться, чек-листы — как она должна работать, а в Трекере лежат закрытые задачи и разобранные нами случаи.
Для проверки поиска знаний я собрал небольшое веб-окно на нашем корпоративном сервере: пишешь вопрос обычными словами, как написал бы коллеге, и получаешь ответ по базе знаний со ссылками на источники. Под ответом — кнопки оценки и поле для обратной связи.
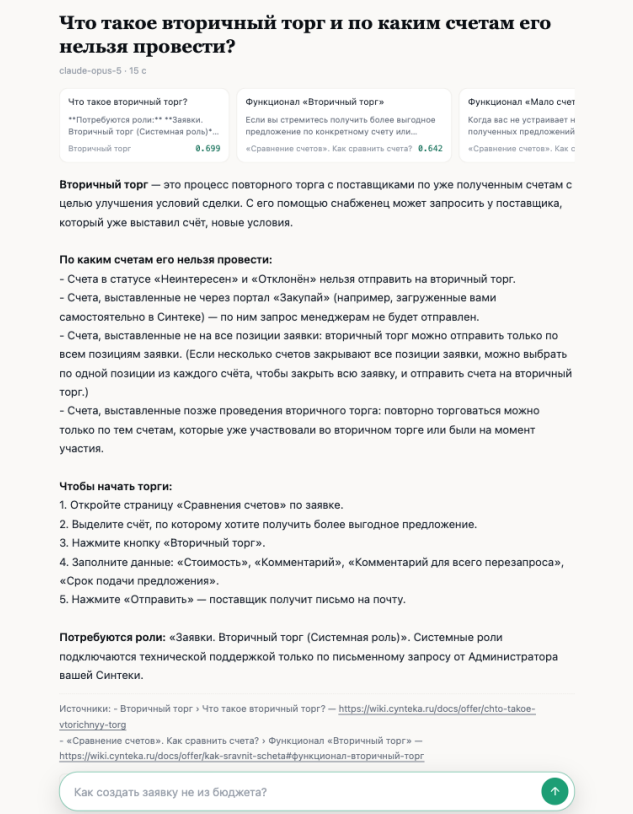
Пока система в бете: доступ даю постепенно и собираю обратную связь. Дальше пояс будет пополняться. Один коллега делает RAG, где источник знаний — код: сейчас с кодом можно работать только через склонированный репозиторий, а это медленно, неточно и с выдумками. Эти два инструмента я рассчитываю потом скомбинировать. Другой коллега строит ИИ-агента внутри самого продукта и уже использует наш поиск по вики.
Снаружи всё это выглядит как MCP-сервер из трёх инструментов: ask_wiki, ask_checklists и ask_tracker. Его можно подключить к любому ИИ-агенту или редактору с поддержкой MCP — Claude Code, Cursor, Cline, IntelliJ. Коллеги приходят за доступом и подключают пояс знаний к своему агенту.
Кому это может пригодиться
Пояс знаний годится не только для первоначальной задачи:
-
Тестировщикам — разбор задачи и майндмапа по номеру из Трекера, заготовки кейсов для автотестов. Первые карты уже строятся, годность оценим по обратной связи.
-
Поддержке — разбор обращений: вместо раскопок по десятку задач в Трекере задать вопрос системе и получить ответ со ссылками.
-
Аналитикам — быстро вспомнить, как работает функционал, с которым давно не сталкивались.
Любую задачу, для которой нужен внутренний контекст «Синтеки», можно пропустить через пояс.
Чего пока нет
Чтобы не выглядело, будто всё работает идеально — перечислю, что не сделано.
-
Дедупликации нет. Одинаковые куски из разных источников не склеиваются. Вместо неё работает каскад: отвечает всегда один источник, конфликтовать им негде. Плюс лимит два куска с одной страницы, иначе одна длинная статья занимает все пять мест.
-
Противоречия не разрешаются автоматически. У каждого куска есть метаданные: заголовок, путь заголовков, ссылка на страницу. Они уезжают в блок «Источники» под ответом. Если два источника расходятся, это видно: открываешь обе ссылки и разбираешься сам.
-
Приоритет по свежести есть только у Трекера. Если две задачи одинаково подходят по смыслу, вперёд идёт закрытая позже. Набор найденного не меняется, только порядок.
-
Обновление по кнопке. Вики обновляется из git, Трекер дозаписывается только новыми и изменёнными задачами, чек-листы не обновляются — они почти не меняются. Автоматики «раз в сутки» нет.
-
Замера «до и после» каскада не было. Каскад придумывался по конкретным случаям, когда источники мешали друг другу, а не по метрике.
-
Годность майндмап не оценена. Карты уже строятся по номеру задачи, но насколько они помогают тестировщику, покажет обратная связь: доступ раздаю только сейчас.
Вместо заключения
Качество ответов напрямую зависит от качества источников. Поэтому вместе с поясом знаний нам нужно приводить в порядок вики и аккуратнее вести задачи в Трекере: документация становится критически важной для любого внедрения ИИ.
Ответственность всё равно остается на человеке. Всё, что сделано с помощью ИИ, нужно проверять — и заодно внимательно читать собственные промпты. Особенно то, что вы модели запрещаете.
Полгода назад выбор звучал как «сдохни или умри». Оказалось, что он ложный: есть третий вариант — сесть и разобраться. Он дольше и скучнее, зато на выходе получается инструмент, а не разочарование.
Автор: trosto4ke

