


В третьей части обзора посмотрим на что способна Tesla V100 в работе с современными локальными моделями ИИ. Сравним ее с более современными серверными ускорителями и видеокартами по вычислительной мощности. Проверим какие модели ИИ она способна запустить в LM Studio и протестируем их.
Сравнение производительности Tesla V100 с современными серверными ускорителями и видеокартами
NVIDIA Tesla V100 стала первым массовым серверным ускорителем с интегрированными тензорными ядрами, что в 2017 году ознаменовало революцию в сфере обучения нейронных сетей. Данный ускоритель стал стандартом для индустрии и активно использовался при разработке прорывных моделей того времени, таких как GPT-2 (хотя финальная версия этой модели обучалась на TPU). Рост сложности моделей ИИ и объемов данных со временем требовал увеличения мощности и объема быстрой памяти, что напрямую стимулировало прогресс в разработке аппаратных ускорителей. Ниже приведена таблица для сравнения вычислительной мощности Tesla V100 с более современными серверными ускорителями и видеокартами NVIDIA.
|
Модель |
Год |
Пиковая вычислительная мощность в зависимости от формата представления чисел с плавающей запятой (Floating Point), TFLOPS |
Тип и объем памяти, Гб |
|||||
|
FP64 |
FP32 |
TF32 Tensor |
FP16/BF16 Tensor |
FP8 Tensor |
FP4 Tensor Dense |
|||
|---|---|---|---|---|---|---|---|---|
|
V100 |
2017 |
7.8 |
15.7 |
— |
125 |
— |
— |
16/32 HBM2 |
|
A100 |
2020 |
9.7 |
19.5 |
312 |
624 |
— |
— |
40/80 HBM2/HBM2e |
|
H100 |
2022 |
34 |
67 |
989 |
1979 |
3958 |
— |
80/96 HBM2e/HBM3 |
|
H200 |
2024 |
34 |
67 |
989 |
1979 |
3958 |
— |
141 HBM3e |
|
B200 |
2025 |
37 |
75 |
2200 |
4500 |
9000 |
9000 |
180/192 HBM3e |
|
B300 |
2025 |
1.2 |
75 |
2200 |
4500 |
9000 |
15000 |
288 HBM3e |
|
RTX 4070 |
2023 |
— |
29 |
— |
117 |
233 |
— |
12 GDDR6X |
|
RTX 4080 |
2022 |
— |
49 |
— |
195 |
390 |
— |
16 GDDR6X |
|
RTX 4090 |
2022 |
— |
83 |
— |
330 |
660 |
— |
24 GDDR6X |
|
RTX 5070 |
2025 |
— |
31 |
— |
123 |
247 |
494 |
12 GDDR7 |
|
RTX 5080 |
2025 |
— |
56 |
— |
225 |
450 |
900 |
16 GDDR7 |
|
RTX 5090 |
2025 |
— |
105 |
— |
419 |
838 |
1676 |
32 GDDR7 |
Из-за отсутствия поддержки современных форматов (FP8/FP4), прямое сравнение по мощности с современными картами возможно лишь в форматах FP16 и FP32. Если взять наиболее универсальный формат данных для LLM – FP16, то более современные серверные ускорители существенно опережают Tesla V100 по вычислительной мощности, а ее главные конкуренты – видеокарты RTX 4070 и RTX 5070. Однако близкие показатели TFLOPS не всегда означают одинаковую скорость вычислений. Tesla V100 использует старые тензорные ядра 1-го поколения, в то время как RTX 4070 и RTX 5070 имеют гораздо более эффективные ядра 4-го и 5-го поколений. Они выполняют операции над матрицами значительно быстрее. Однако в задачах, ограниченных памятью, Tesla V100 выигрывает за счёт высокой пропускной способности HBM2 ~900 ГБ/с, тогда как у RTX 4070 пропускная способность GDDR6X ~504 ГБ/с, а у RTX 5070 ~672 ГБ/с.
Для оценки средней вычислительной мощности CUDA и тензорных ядер я запустил скрипт, написанный на Python с использованием библиотеки PyTorch, который измеряет производительность матричного умножения (GEMM).
Этот тест напрямую нагружает ядра GPU: в режиме FP32 работают CUDA-ядра, а в режиме FP16 – тензорные ядра.
Результат теста:
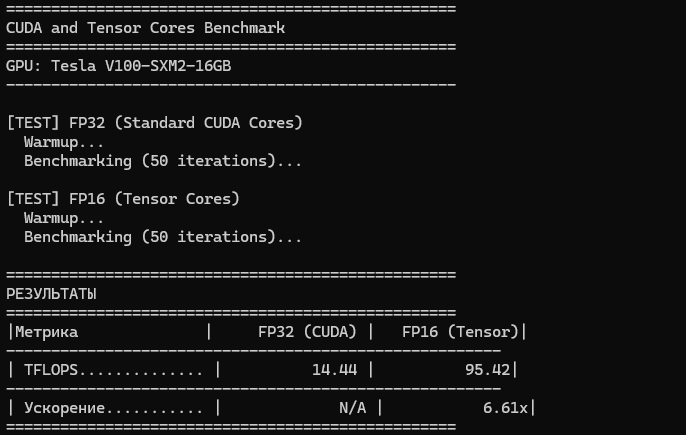
Реальная средняя вычислительная мощность Tesla V100 в форматах FP32 и FP16 несколько ниже пиковых значений из вышеприведенной таблицы – 15.7 и 125 TFLOPS.
LM Studio: запуск, тестирование и варианты использования локальных моделей ИИ
Запуск и тестирование локальных моделей ИИ
Для запуска LLM я использовал программу LM Studio. Список выбранных моделей приведен в таблице ниже:
|
Полное название модели |
Издатель |
Параметры, млрд |
Тип квантования |
Размер, Гб |
|
Qwen3.6-35b-a3b |
unsloth |
35 для обучения, 3 активных |
Q2_K_XL |
13,11 |
|
Qwen3.6-35b-a3b-mtp |
unsloth |
35 для обучения, 3 активных |
Q2_K_XL |
13,37 |
|
Qwen3.6-35b-a3b |
qwen |
35 для обучения, 3 активных |
Q4_K_M |
20,55 |
|
GPT-OSS-20B |
openai |
20 |
MXFP4 |
11,28 |
|
Gemma-4-e4b |
|
4 эффективных |
Q8_0 |
8,4 |
Все представленные модели ИИ в формате GGUF. GGUF (GPT-Generated Unified Format) – это современный бинарный формат файлов для хранения и эффективного запуска больших языковых моделей (LLM) на центральных процессорах (CPU) и видеокартах (GPU). Он разработан специально для llama.cpp и совместим с Tesla V100.
В список я добавил две модели Qwen3.6-35b-a3b с одинаковым квантованием Q2_K_XL, но одна из них поддерживает спекулятивное декодирование MTP. MTP (Multi-Token Prediction) – это метод ускорения генерации текста языковыми моделями, позволяющий модели предсказывать сразу несколько следующих токенов за один проход, вместо одного. MTP позволяет генерировать текст в 1.5–2 раза быстрее без потери качества ответов. В LM Studio перед загрузкой модели MTP в память GPU нужно обязательно активировать опцию MTP Speculative Decoding в расширенных настройках.
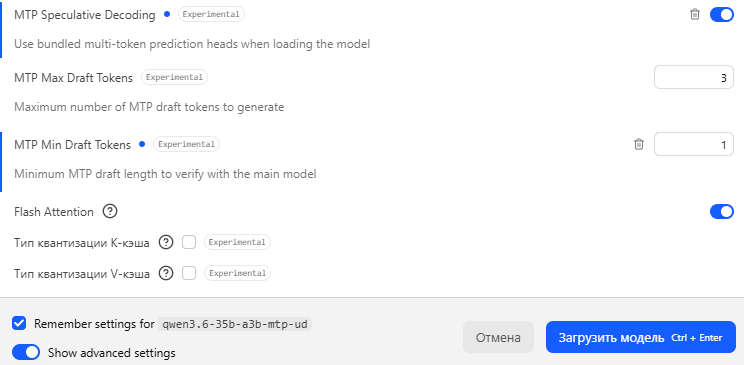
Перед началом тестирования, привожу список основных компонентов и параметров своего ПК:
-
Материнская плата: ASRock A520M Phantom Gaming 4
-
Процессор: AMD Ryzen 7 5700GE
-
Оперативная память: 64 Гб (2x Patriot Viper Steel 32 Гб DDR4 3600 МГц)
-
Основной накопитель: SSD NVMe Kingston KC3000 1 Тб
-
Блок питания: FSP Vita GM 750 Вт
-
Операционная система: Windows 11 Pro
-
Драйвер NVIDIA: 553.74 (серверный grid драйвер от Google)
-
LM Studio: v.0.4.14 (Build 2), CUDA llama.cpp v.2.15, Vulkan llama.cpp v.2.15
Проверим скорость работы LLM. Каждой модели я отправил один и тот же запрос: “Напиши короткую фантастическую историю о приключениях путешественника во времени”.
Настройки каждой модели – “по умолчанию”, системный ptompt – отсутствует, режим размышлений – включен.
Результаты теста приведены в таблице ниже:
|
Полное название модели |
Тип квантования |
Размер, Гб |
Скорость генерации, токены/сек. |
|
Qwen3.6-35b-a3b |
Q2_K_XL |
13,11 |
38,24 |
|
Qwen3.6-35b-a3b-mtp |
Q2_K_XL |
13,2 |
77,35 |
|
Qwen3.6-35b-a3b |
Q4_K_M |
20,55 |
19,21 |
|
GPT-OSS-20B |
MXFP4 |
11,28 |
109,11 |
|
Gemma-4-e4b |
Q8_0 |
8,4 |
67,87 |
Самой быстрой моделью оказалась GPT-OSS-20B, а самой медленной – Qwen3.6-35b-a3b с квантованием Q4_K_M. Низкая скорость работы последней (19,21 т/с) обусловлена тем, что она не помещается целиком в быструю память GPU: часть слоев выгружается в более медленную оперативную память DDR4. Для сравнения: версия Qwen3.6 с квантованием Q2_K_XL, которая полностью поместилась в VRAM Tesla V100, работает вдвое быстрее (38,24 т/с), а модель с поддержкой MTP – в четыре раза быстрее (77,35 т/с). По моему мнению для большинства задач в работе с локальными LLM достаточно 35-40 токенов в секунду. В связи с этим стоит выбирать модели ИИ, которые полностью помещаются в память GPU. Далее я не буду использовать модель Qwen3.6-35b-a3b Q4_K_M из-за ее низкой скорости работы на моем ПК.
Так же стоит отметить, что модель Qwen3.6-35b-a3b-mtp работает нестабильно с движком CUDA llama.cpp v.2.15. С контекстным окном 15000 токенов модель занимает 15,5 Гб памяти GPU. Во время выполнения запроса в LM Studio иногда возникает резкий рост потребления памяти и модель полностью выгружается. В журнале LM Studio появляется ошибка – CUDA error: out of memory. Поэтому модель Qwen3.6-35b-a3b-mtp я запускал на движке Vulkan llama.cpp v.2.15. Разница в скорости генерации текста между CUDA и Vulkan для этой MTP-модели незаметна, при этом работа на Vulkan была стабильной.
Варианты использования локальных моделей ИИ
Рассмотрим наиболее интересные на мой взгляд варианты использования локальных моделей ИИ, запускаемых в LM Studio.
Генерация кода в OpenCode
Проверим на что способны локальные LLM в генерации кода.
В LM Studio есть встроенный локальный сервер API, который позволяет другим приложениям и ИИ-агентам обращаться к запущенным моделям. Я использовал эту функцию для интеграции локальных моделей в OpenCode.
Для начала попробую создать небольшой одностраничный сайт для ведения личного блога. Тестовый запрос был идентичным для всех моделей.
Qwen3.6-35b-a3b:
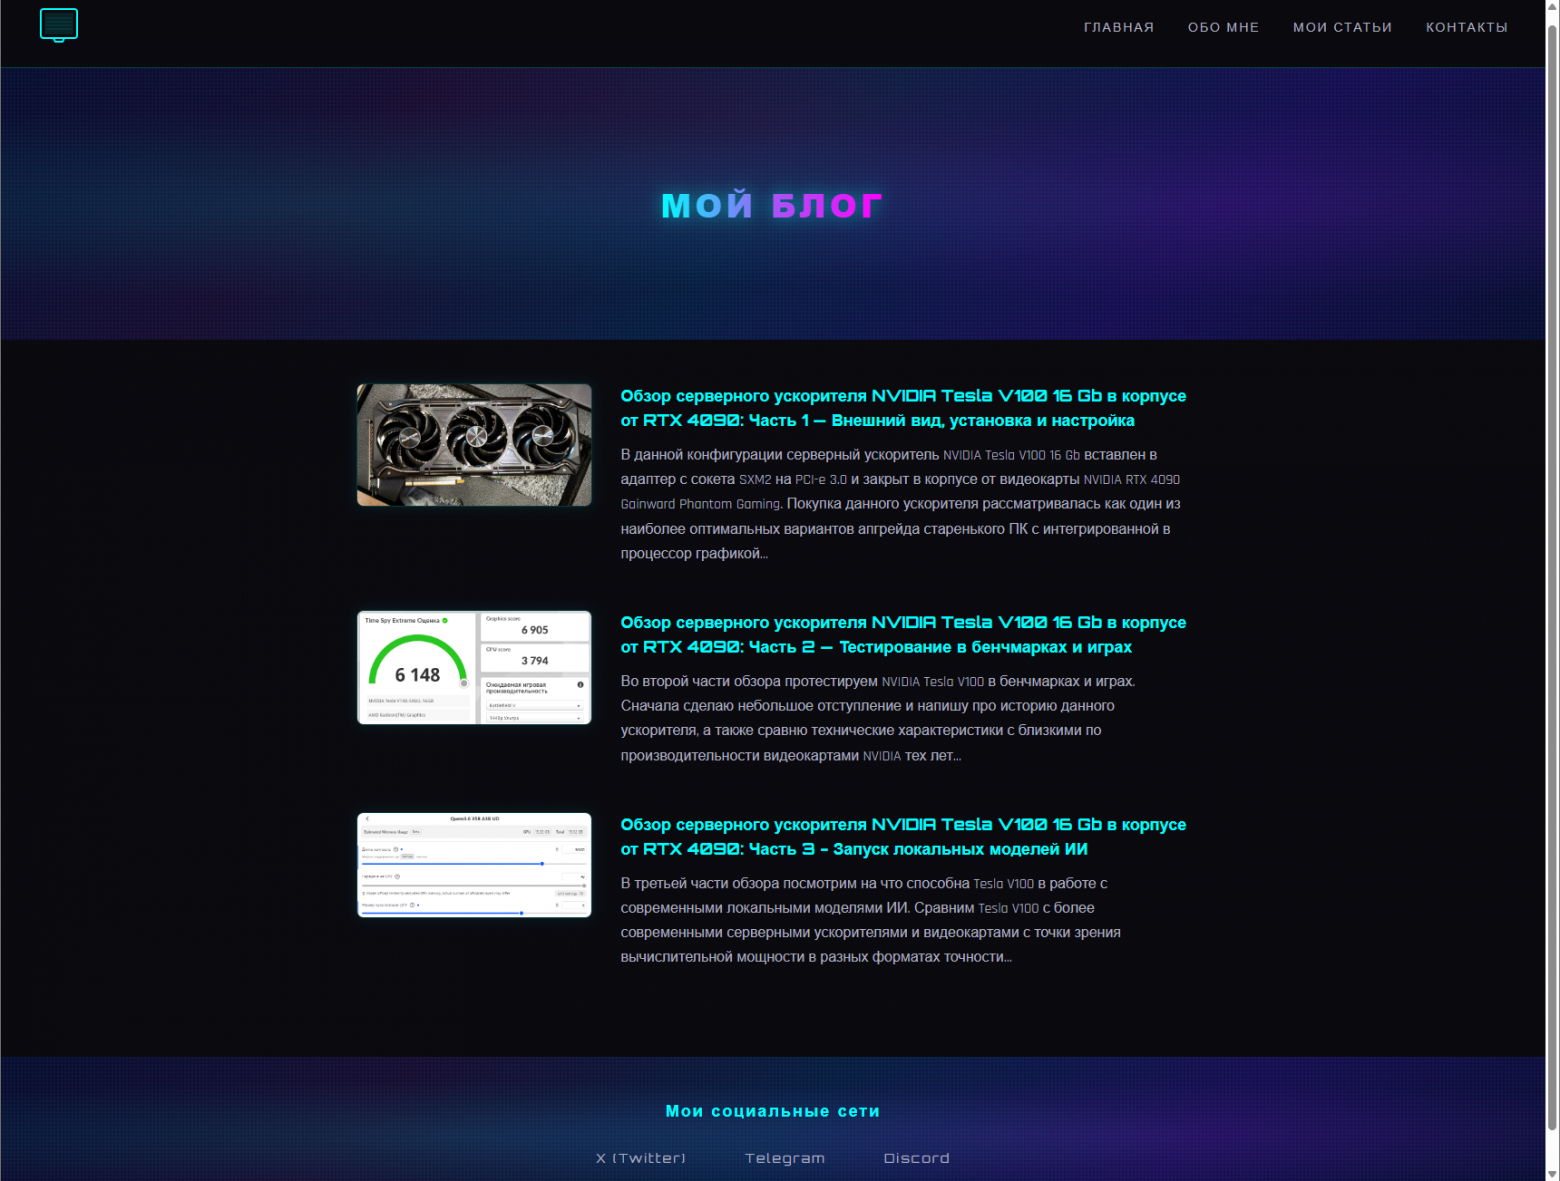
Время генерации сайта – 3 минуты 40 секунд. Использованное количество токенов из контекстного окна – 14901.
Qwen3.6-35b-a3b-mtp:
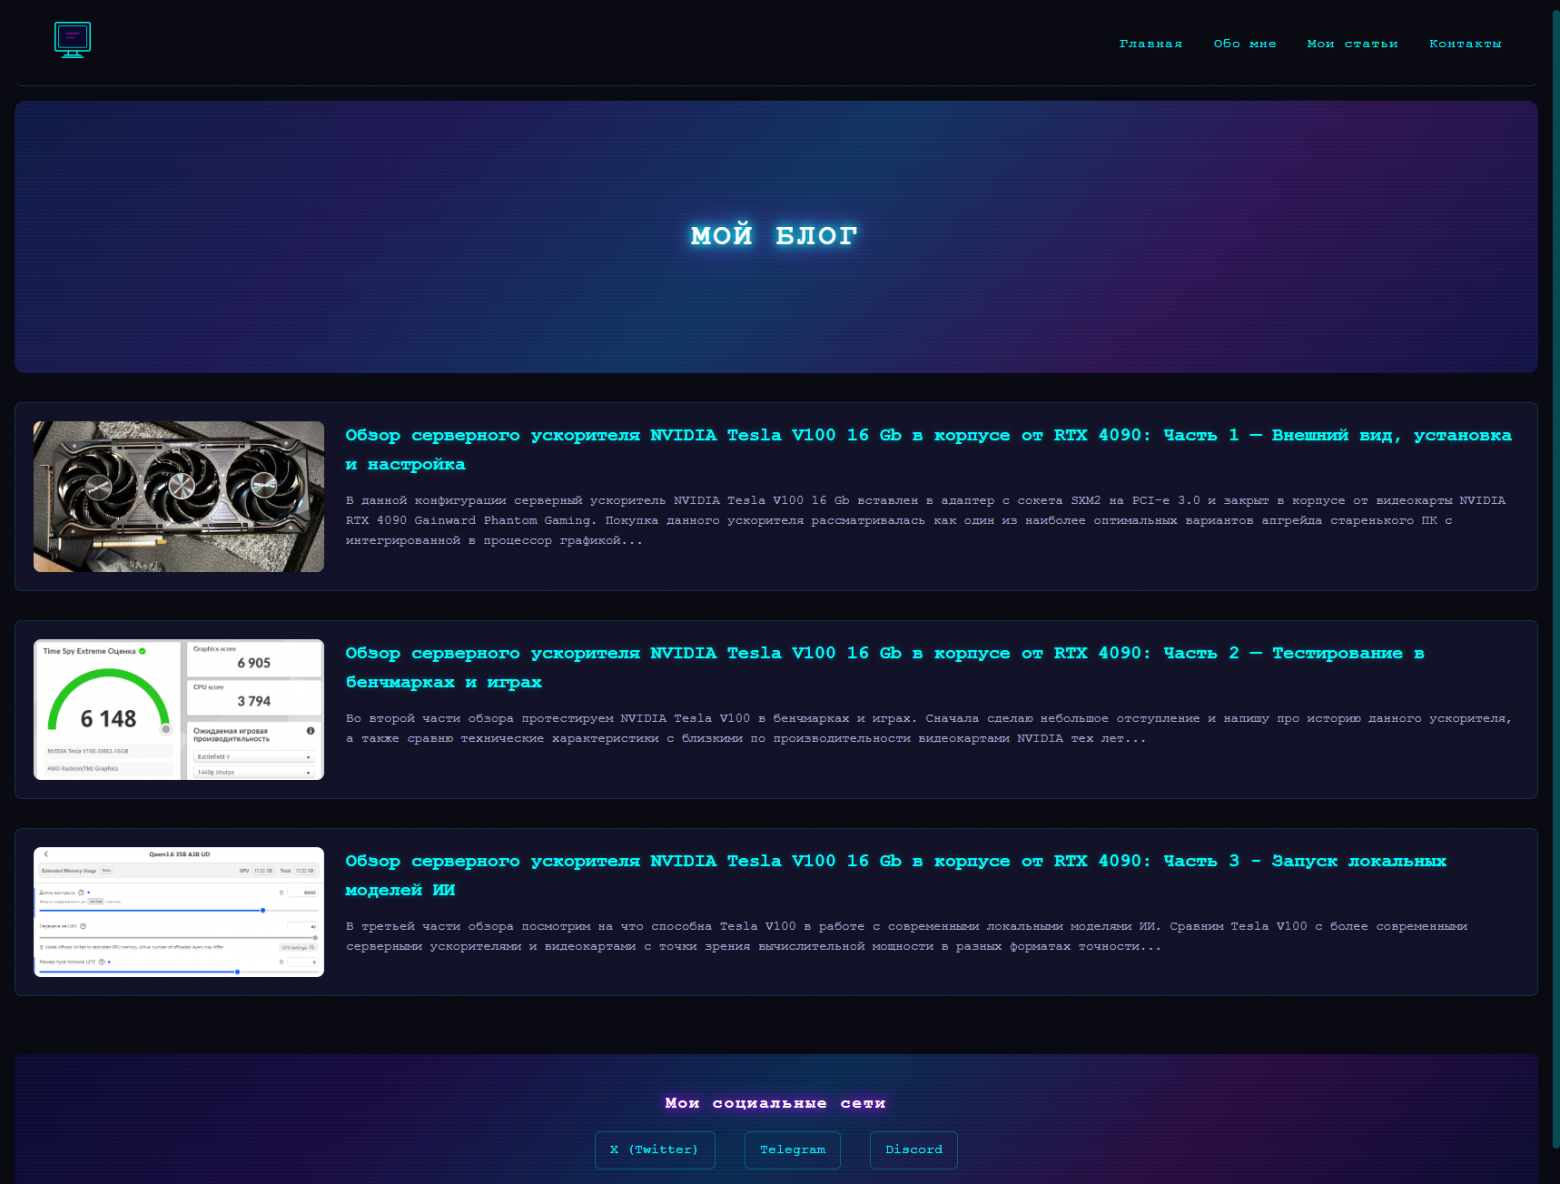
Время генерации сайта – 2 минуты 10 секунд. Использованное количество токенов из контекстного окна – 20244.
GPT-OSS-20B:
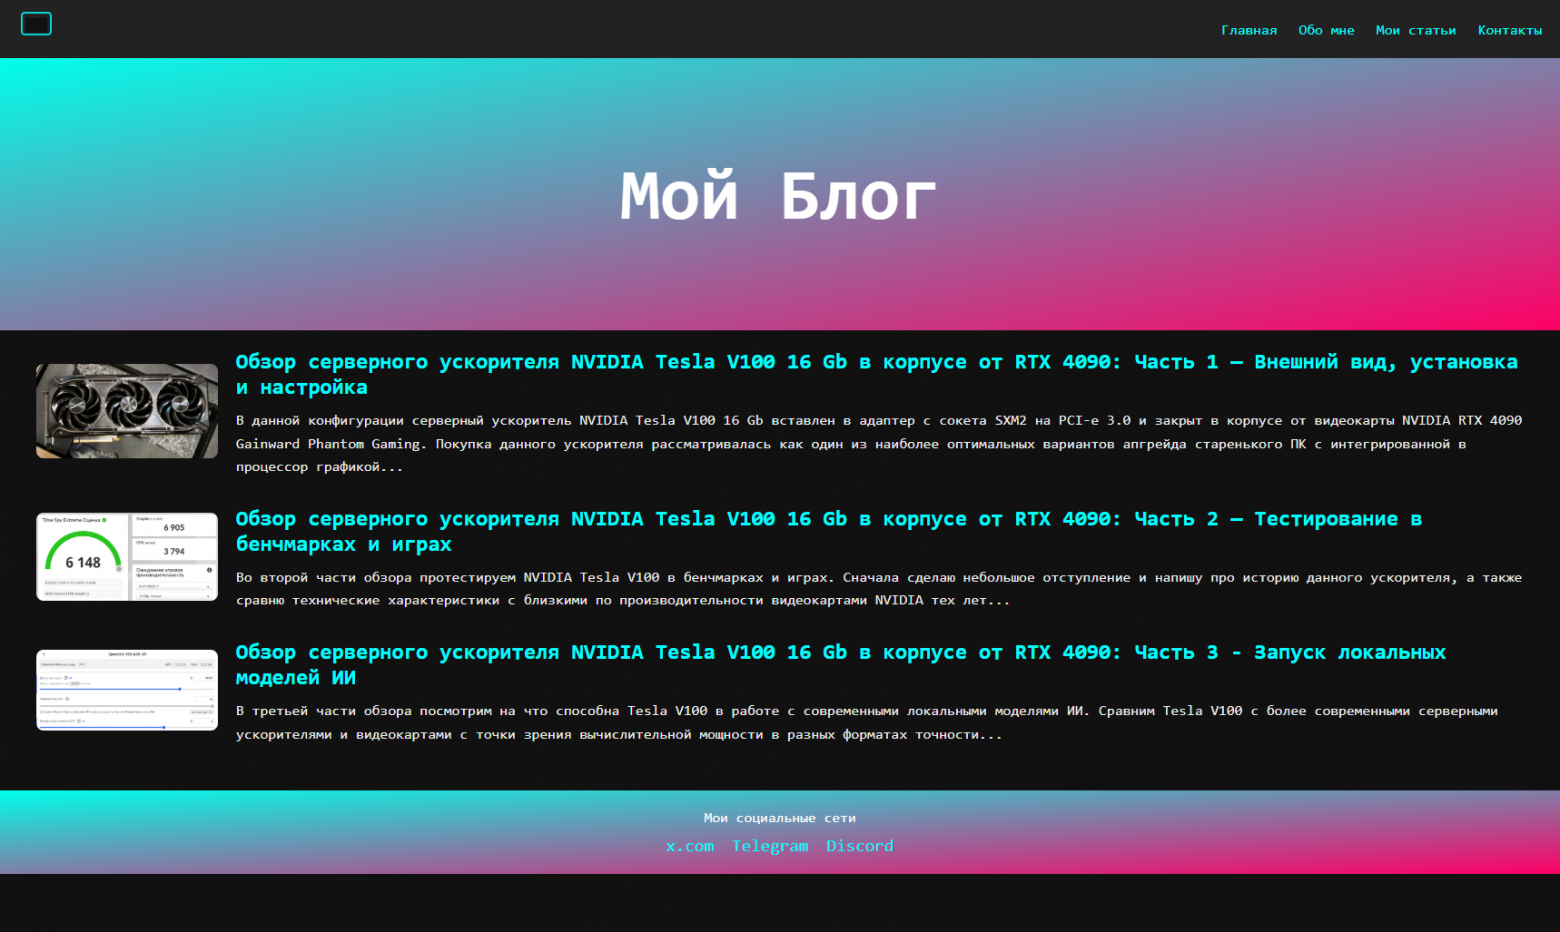
Время генерации сайта – 1 минута 45 секунд. Использованное количество токенов из контекстного окна – 17539.
Gemma-4-e4b:
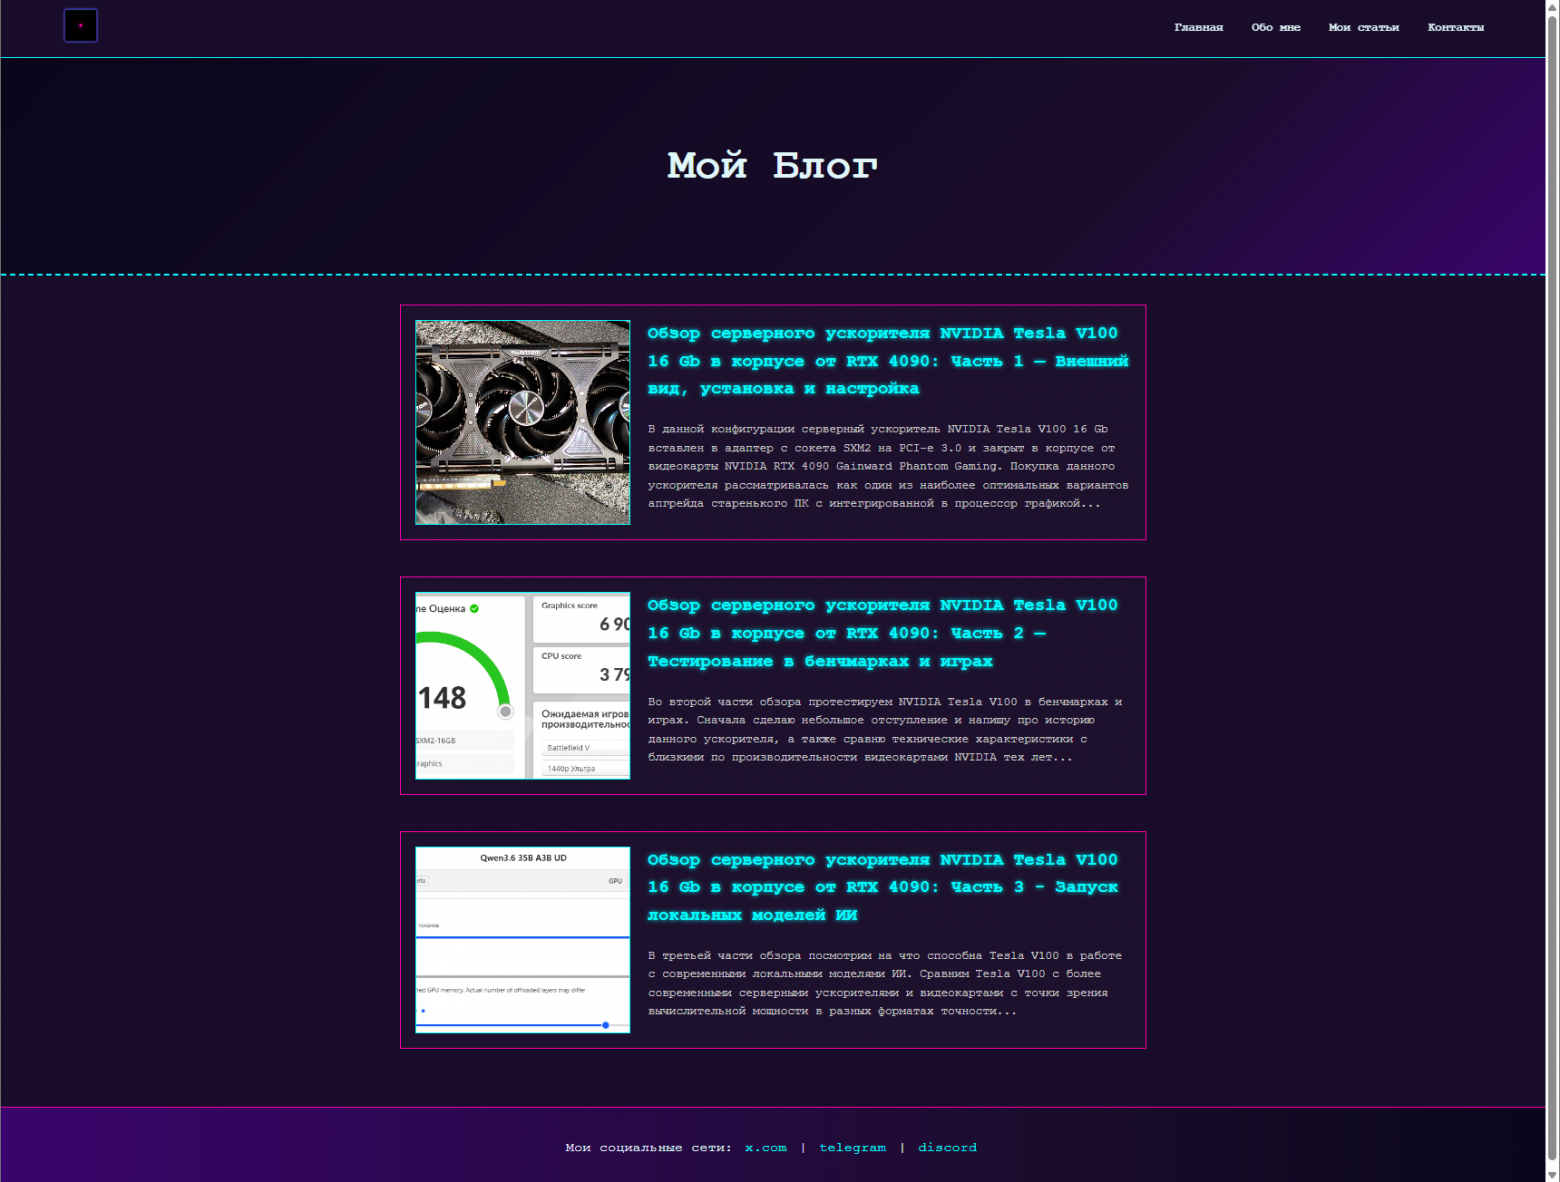
Время генерации сайта – 2 минуты 5 секунд. Использованное количество токенов из контекстного окна – 22456.
Заключение:
Все четыре модели успешно справились с поставленной задачей: корректно сгенерировали структуру сайта, вставили изображения из папки с проектом к заголовкам статей. Правильно вставили текст, соответствующий теме для каждой статьи. Наиболее интересный дизайн на мой взгляд получился у модели Qwen3.6-35b-a3b-mtp.
Далее я решил усложнить задачу и проверить смогут ли локальные LLM справиться с созданием небольшой 2D-игры. Каждой модели отправил одинаковый запрос: “Создай игру, аналогичную игре Flappy Birds. Игра должна открываться в веб-браузере и должна быть максимально приближена к оригиналу”.
Qwen3.6-35b-a3b:
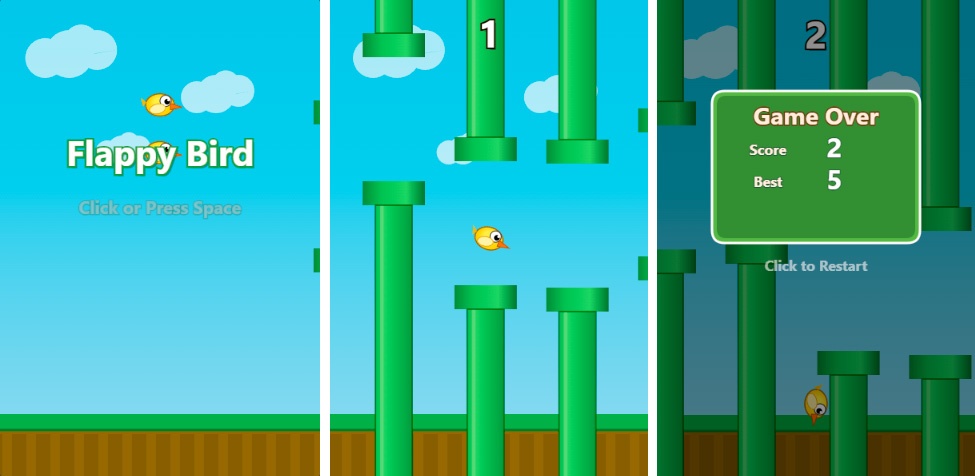
Время генерации игры – 7 минут 24 секунды. Использованное количество токенов из контекстного окна – 18677.
-
Графика: Высококачественная, максимально приближенная к оригиналу.
-
Элементы: Красивые облака на фоне, желтая птица в стиле оригинала, зеленые трубы с характерными “горловинами” сверху.
-
Интерфейс: Есть экран приветствия (“Flappy Bird”, “Click or Press Space”), отображается текущий счет (Score: 1) и лучший результат (Best: 5), полноценный экран Game Over.
-
Геймплей: Птица успешно проходит между трубами, все элементы корректно отображаются. Сложность игры – средняя.
Qwen3.6-35b-a3b-mtp:
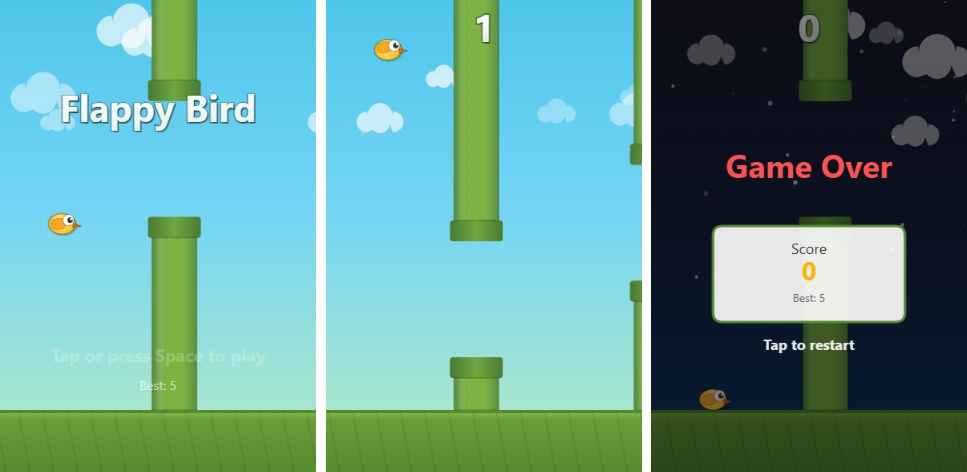
Время генерации игры – 2 минуты 5 секунд. Использованное количество токенов из контекстного окна – 19107.
-
Графика: Хорошая, но фон отличается от оригинала. Облака проработаны лучше, чем в предыдущем варианты. Некорректно выбран цвет земли (зеленый).
-
Элементы: Желтая птица и зеленые трубы выглядят аккуратно.
-
Интерфейс: Экран приветствия с текстом “Tap or press Space to play”, отображается текущий счет и лучший результат. На экране Game Over изменяется фон в отличии от предыдущего результата.
-
Геймплей: Птица успешно проходит между трубами, все элементы корректно отображаются. Сложность игры – легкая, так как количество труб меньше, чем в предыдущем варианте.
GPT-OSS-20B:
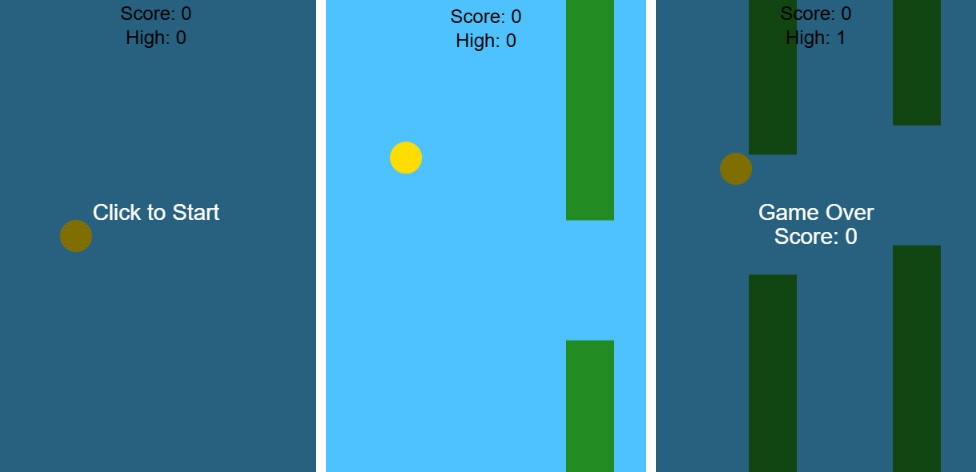
Время генерации игры – 2 минуты 24 секунды. Использованное количество токенов из контекстного окна – 20015.
-
Графика: Базовая, минималистичная.
-
Элементы: Вместо птицы желтый круг без деталей, трубы – зеленые прямоугольники без горловин сверху.
-
Интерфейс: Экран “Click to Start”, отображается текущий счет – Score: 0 и лучший результат – High: 1. На экране Game Over отображается только текущий счет, не указано как перезапустить игру.
-
Геймплей: Желтый круг успешно проходит между трубами, все элементы корректно отображаются. Сложность игры – легкая. Количество труб примерно такое же как в предыдущем варианте.
Gemma-4-e4b:
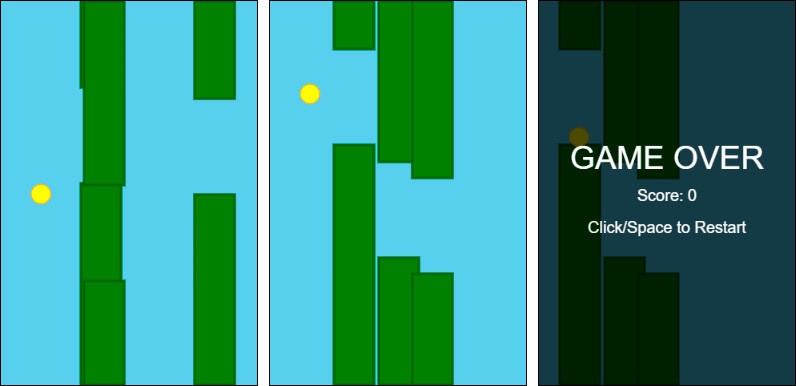
Время генерации игры – 1 минута 3 секунды. Использованное количество токенов из контекстного окна – 17333.
-
Графика: Простая, похожа на результат GPT-OSS-20B.
-
Элементы: Желтый круг вместо птицы, зеленые прямоугольники вместо труб.
-
Интерфейс: На стартовом экране нет информации как начать игру. Не отображается текущий счет во время игры. На экране Game Over не отображается лучший результат.
-
Геймплей: Часто встречаются трубы, которые накладываются друг на друга, или просто смыкаются. Худший геймплей среди всех вариантов.
Заключение:
Все модели создали рабочую версию игры Flappy Bird с основными элементами: птицей, трубами, счетчиком очков и экраном Game Over. Однако качество исполнения значительно различается. Обе модели Qwen-3.6-35b-a3b справилась отлично. GPT-OSS-20B удалось реализовать игру на базовом уровне. Gemma-4-e4b – справилась с задачей быстрее всех, но выдала худший с точки зрения геймплея результат.
Работа с документацией
В LM Studio можно прямо в чат приложить документ в формате docx и попросить модель ИИ проанализировать документ: найти ошибки, улучшить стиль текста или дополнить. Однако редактировать и создавать файлы в формате docx модель ИИ не сможет. Для того, чтобы с помощью LM Studio можно было сразу вносить изменения в файл docx нужно установить соответствующий плагин – word-tools. С помощью этого инструмента ИИ модели хорошо справляются с дополнением текста, рерайтом и исправлением ошибок прямо в файле docx.
В качестве примера я решил проверить насколько быстро локальные LLM справятся с генерацией краткого содержания первой части моего обзора Tesla V100. Полный текст статьи был сохранен в файле docx.
Результаты генерации краткого содержания статьи:
Qwen3.6-35b-a3b:
Статья описывает процесс модификации серверного ускорителя NVIDIA Tesla V100 16 GB (SXM2) для домашнего ПК путем установки в корпус от видеокарты RTX 4090. Автор приобрел карту и адаптер через Taobao, затратив около 15 000 рублей. Ключевые этапы работы:
-
Настройка BIOS: отключение CSM, включение Above 4G Decoding и выбор интегрированной графики для вывода изображения на монитор.
-
Установка драйверов: официальный драйвер NVIDIA работал только в режиме TCC (без игр), а серверный драйвер Google вызывал сбои. Стабильная работа достигнута с драйвером 553.74, требуются манипуляции с виртуальным экраном.
-
Физическая сборка: из-за крупных габаритов карты (3,5 кг) потребовались опорный кронштейн и райзеры для переноски других устройств в заблокированные слоты PCIe.
Особое внимание уделено модификации охлаждения. Стандартные кулеры не поддерживают автоматическую регулировку, поэтому вентиляторы были подключены к материнской плате через специальные переходники. Настройка Fan Control позволила добиться бесшумной работы в простое (~15%) и безопасных температур до 60°C при нагрузке.
Обзор является первой частью цикла. Во второй части запланированы тесты ускорителя в современных играх.
Время генерации – 3 минуты.
Qwen3.6-35b-a3b-mtp:
В статье описывается первая часть обзора серверного ускорителя NVIDIA Tesla V100 16 ГБ, установленного в корпус от видеокарты RTX 4090. Рассматриваются технические характеристики карты (архитектура Volta, 5120 CUDA-ядер) и процесс её покупки через китайский маркетплейс. Описываются трудности физической установки: большие габариты корпуса перекрывают слоты расширения материнской платы, что потребовало использования райзеров для подключения Wi-Fi адаптера и дополнительного накопителя, а также специальной опоры из-за веса конструкции. Указывается на отсутствие видеовыходов у серверной карты. Подробно разбирается настройка BIOS, в частности необходимость включения Above 4G Decoding для адресации памяти, и выбор основного устройства вывода изображения. Отмечаются проблемы с драйверами: официальное ПО от NVIDIA поддерживает только вычислительный режим TCC, а серверные версии от Google вызывают сбои системы; в итоге была успешно применена версия драйвера 553.74. В завершении рассказывается о модернизации охлаждения: подключении вентиляторов к материнской плате и настройке их оборотов через программное обеспечение Fan Control для баланса между шумом и температурой.
Время генерации – 51 секунда.
GPT-OSS-20B:
В статье описывается покупка, установка и настройка серверного ускорителя NVIDIA Tesla V100 16 Гб в корпусе RTX 4090. Автор подробно рассказывает о технических характеристиках карты (5120 CUDA‑ядер, 640 тензорных ядер, 16 ГБ HBM2), стоимости доставки и комплектации, а также об особенностях сборки: необходимость установки дополнительных райзеров, настройка BIOS (отключение CSM, включение Above 4G Decoding) и выбор видеокарты для вывода изображения. Далее рассматриваются драйверы – официальные NVIDIA‑драйверы работают только в режиме TCC, а Google‑драйверы поддерживают WDDM, но требуют отключения виртуального экрана. Охлаждение осуществляется через PWM‑переходники и программу Fan Control. Автор отмечает, что Tesla V100 не имеет видеовыходов, поэтому для игр используется интегрированная графика процессора.
Время генерации – 17 секунд.
Gemma-4-e4b:
Статья описывает процесс установки и настройки вычислительного ускорителя Tesla V100 (архитектура Volta, 16 ГБ HBM2) в ПК на базе материнской платы ASRock A520M с использованием адаптера SXM2 на PCI-e 3.0 и корпуса от RTX 4090. В обзоре освещаются технические детали, включая покупку ускорителя (стоимость около 15 000 руб.), сложности физической установки и необходимость использования райзеров. Подробно описаны шаги по настройке BIOS (отключение CSM, включение Above 4G Decoding) для корректной работы с большим объемом памяти. Также рассматриваются проблемы с драйверами — переход от официальных драйверов NVIDIA к серверным драйверам Google и решение вопроса охлаждения путем подключения кулеров Tesla V100 к материнской плате и настройки кривых оборотов через Fan Control.
Время генерации – 26 секунд.
Все модели успешно справились с генерацией краткого содержания статьи и сохранением в файл формата docx. Лучший результат с точки зрения качества текста на мой взгляд у модели Qwen3.6-35b-a3b: в кратком содержании отражены все основные моменты, а ключевые выделены в структурированный список. Самой быстрой оказалась – GPT-OSS-20B.
Итоговая таблица для сравнения времени генерации краткого содержания статьи локальными LLM:
|
Модель |
Время генерации, с |
|---|---|
|
Qwen3.6-35b-a3b |
180 |
|
Qwen3.6-35b-a3b-mtp |
51 |
|
GPT-OSS-20B |
17 |
|
Gemma-4-e4b |
26 |
Заключение
NVIDIA Tesla V100 представляет собой отличную и доступную платформу для экспериментов с локальными моделями ИИ. Ускоритель успешно запускает современные модели, демонстрируя производительность, достаточную для комфортной работы. Ключевым фактором производительности является возможность полной загрузки LLM в память GPU. При выгрузке части слоев модели в оперативную память ПК скорость значительно снижается, сильно затормаживая работу.
Вывод по итогам тестирования моделей ИИ в LM Studio:
-
Qwen3.6-35b-a3b Q2_K_XL (особенно версия с поддержкой MTP): выдает наиболее качественный результат по сравнению с другими протестированными моделями. Лучше всех справилась со всемми задачами: генерация кода одностраничного сайта, создание игры Flappy Bird, рерайт статьи. Модель с поддержкой MTP обеспечивает высокую скорость работы.
-
GPT-OSS-20B: лидер по скорости генерации текста. В генерации кода и рерайте статьи качественно уступает модели Qwen3.6-35b-a3b, но превосходит Gemma-4.
-
Gemma-4-e4b: на мой взгляд показала посредственный результат. При скорости работы сравнимой с Qwen3.6-35b-a3b-mtp качество итогового результата существенно уступает последней.
В итоге NVIDIA Tesla V100 показала себя универсальным решением. Хотя изначально на момент выхода в 2017 году – это был мощный серверный ускоритель для дата-центров, сегодня – это отличное доступное решение для работы с нейросетям с возможностью комфортно играть в современные игры на высоких настройках графики.
На мой взгляд, покупать её стоит как вариант апгрейда старого ПК или для универсальной бюджетной сборки – “работай и играй”. Современные видеокарты с 16 Гб памяти стоят дороже, а меньший объем VRAM будет недостаточен для запуска современных моделей ИИ. При этом 16 Гб – это минимальный порог. Для полной загрузки в память GPU модели Qwen3.6-35b в квантовании Q4 (которую я исключил из теста из-за низкой скорости работы) нужен объем VRAM минимум 24 Гб.
Автор: Yuiy78

