


В финале прошлой статьи про сборку AI-команды я остановился на клиффхэнгере: наш простой трёхнедельный пилот RAG по технической документации забуксовал, причём виной тому были не модели, не серверы и не разработчики. С первого установочного совещания прошло уже три месяца.
Для тех, кто в блоге впервые: в прошлых частях мы прошли путь от первых экспериментов с ChatGPT и самописных микросервисов до собственной инфраструктуры, найма IT-архитектора и выстраивания DevOps-практик.
В начале пути внедрения AI в бизнес-процессы, мне казалось, что самые сложные вопросы будут сугубо техническими: какую модель выбрать, какие GPU купить, как всё это собрать и не уронить.
Сейчас всё наоборот — техническая логика понятна, а главный затык корпоративного AI, оказалось, вообще не имеет отношения к нейросетям. Настоящее веселье начинается, когда AI просит у компании нормальные исходные данные и понятное описание бизнес-процесса.
Сегодня о том, почему трёхнедельный пилот RAG растянулся на три месяца, как AI вскрыл застарелый бардак в заводских регламентах и во сколько на самом деле обходится этот эксперимент.
Три недели, которые идут уже три месяца
Внимательные читатели могли заметить, что мы уже упоминали RAG, но тогда это был совершенно другой инструмент с ограниченной задачей, где мы использовали языковую модель скорее как сквозной валидатор отгрузочных документов — проверяли грамматику и сверяли базовые параметры в паспортах изделий перед отправкой заказчику.
Текущий пилот — шаг принципиально иного масштаба. Мы создаём полноценную интерактивную базу знаний по тяжёлой технической и эксплуатационной документации. Идея простая: продажник, пресейл или инженер задаёт вопрос по продукту и получает ответ не из интернета или чьей-то памяти, а из верифицированного массива заводских чертежей, схем и регламентов ПСМ.
Для начала мы решили ограничить пилот всего одним видом нашего оборудования — газопоршневой электростанцией мощностью 1 МВт. Казалось бы, одна машина, типовые агрегаты, что тут может пойти не так? Тут же выяснилось, что у одной этой «базовой» станции существует 44 модификации. В нашем бизнесе не бывает просто «генератора»:
-
Исполнение: открытая рама или утеплённый блок-контейнер
-
Электрика: класс напряжения 0,4 кВ или высоковольтные 6,3 / 10,5 кВ
-
Управление: разные марки и логика промышленных контроллеров
-
Опции: когенерация (наличие или отсутствие системы утилизации тепла — СУТ), разные типы радиаторов, подогревателей и вспомогательных систем
И под каждую из 44 конфигураций нужны свои схемы, таблицы нагрузок, регламенты ТО и эксплуатационные карты. А теперь представьте масштаб: в каталоге ПСМ десятки моделей дизельных и газовых электростанций на разных двигателях. Если помножить всю линейку на инженерные модификации, получаем сотни вариантов исполнения оборудования, по каждому из которых клиент может задать точечный каверзный вопрос.
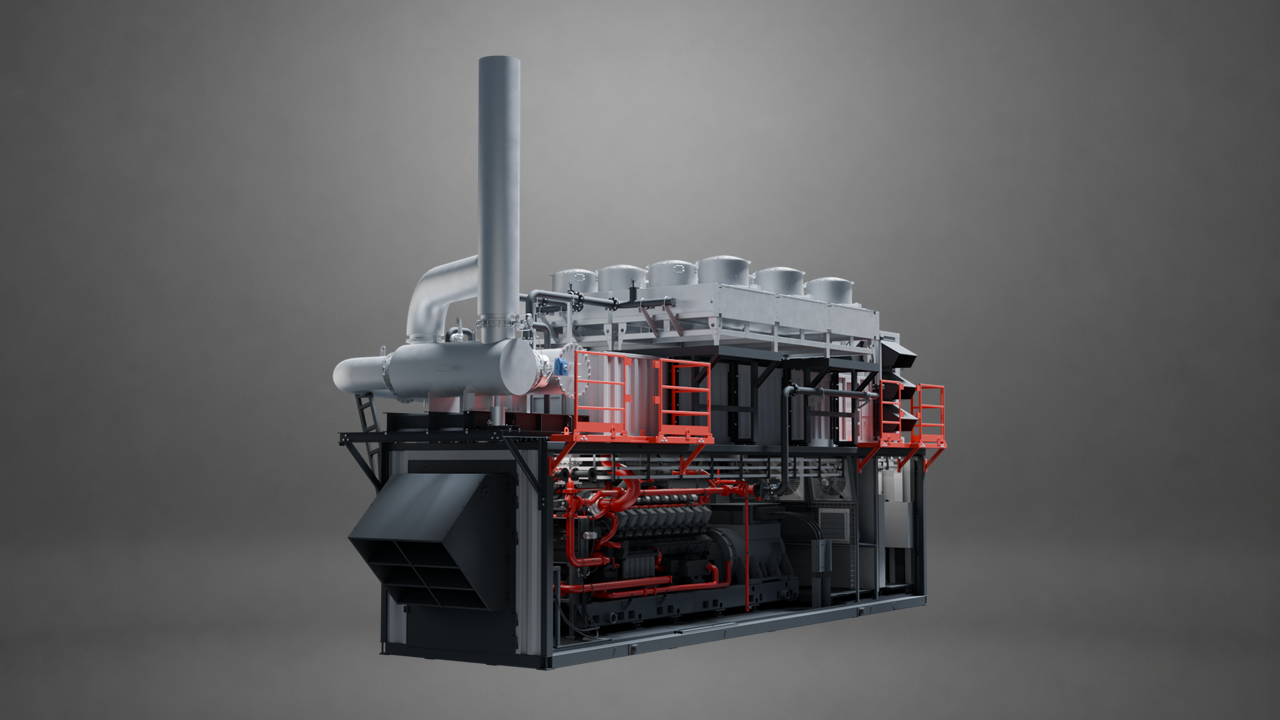
Мы прикинули, что работы здесь недели на три — столько и заложили на пилот. В реальности прошло уже три месяца, а конца и края пока не видно.
Чтобы не закопаться в бесконечных исключениях, вовремя сузили рамки. Вместо всех 44 модификаций взяли в первую итерацию несколько самых ходовых конфигураций. Сам технический прототип и поисковый интерфейс уже развернуты и работают, но выкатить ассистента на тестирование инженерам мы пока не можем, потому что узким местом оказалась не разработка, а сборка и проверка данных.
Excel-реестр и переработка руководства
Выяснилось, что у нас нет одной качественной, проверенной и структурированной базы знаний со всей документацией. Где-то данные лежат в папке на сервере, до которой нужно добраться ещё через 10 папок, где-то — в закрытой задаче в Битриксе, где-то — в облаке или на рабочем столе инженера. При этом непонятно, какая версия актуальная, и документ сначала надо проверить, а человек, который знает как правильно, ушёл в отпуск.
Поэтому для AI-пилота мы сделали реестр в Excel, просто чтобы понять, какие документы вообще существуют и как они связаны. Да-да, «вскипятили воду в кастрюльке, чтобы сходить в душ, и поехали на поиски бензина, чтобы добраться на конференцию по AI». Потом договорились рабочий набор складывать в один чат Bitrix, чтобы никто не запутался, какую версию и из какой папки сейчас тестируем. Это колхозная история, но для пилота было главным зафиксировать набор данных и проверить гипотезу.
Самый забавный момент в том, что руководство по эксплуатации продукта, с которого мы хотели подготовить документы для RAG, оказалось двухлетней давности. Сам по себе срок нормальный, но за эти два года у нас появилось огромное количество разногласий в документах (например, конфликт комплектующих и их характеристик), и информация стала непригодна для LLM. По факту его надо полностью переписывать, потому что оно описывало комплектацию, которую завод уже не собирает, а свежих схем не было. Загрузи мы его в RAG — получили бы уверенный генератор дезинформации.
То есть мы начали строить RAG, а вдобавок получили ещё и проект по приведению в порядок собственной технической документации.
Все свои документы мы всё равно проверяем человеком. Коллеги понимают, что часть материалов я потом посмотрю лично, поэтому совсем плохую эксплуатационную документацию в базу уже никто не хочет тащить.
Как будем проверять работу RAG
Тут не хочется принимать результат по принципу «вроде отвечает умно». В переписке с клиентом цена галлюцинации вполне конкретная. Помимо внешнего риска выдуманных данных из открытого интернета, куда опаснее ситуация, когда RAG выдаёт подлинные и существующие параметры из внутренней базы, но от похожей или старой модификации. Если сейл или пресейл спрашивает у модели «Влезет ли эта комплектация ГПУ в стандартный габарит контейнера?», система не имеет права придумать ответ от себя или взять данные от соседних моделей. Поиск сведений о габаритах в документации — не финальная инженерная приёмка компоновки, но стоит менеджеру выдать клиенту уверенную, но выдуманную цифру, сразу получим риск сорванной поставки, переделки на площадке или гарантийный скандал.
Поэтому мы заложили требования к валидации ответов:
-
Точная привязка к модификации: модель должна чётко различать исполнения и использовать документы строго под заданную конфигурацию
-
Обязательная ссылка на источник: к каждому ответу ассистент обязан прикреплять ссылку на конкретный чертёж, пункт РЭ или спецификацию с указанием даты и ревизии
-
Право на отказ: если точных данных по запрошенной опции в верифицированной базе нет, система обязана прямо ответить «В документации нет информации», а не пытаться додумать ответ по аналогии
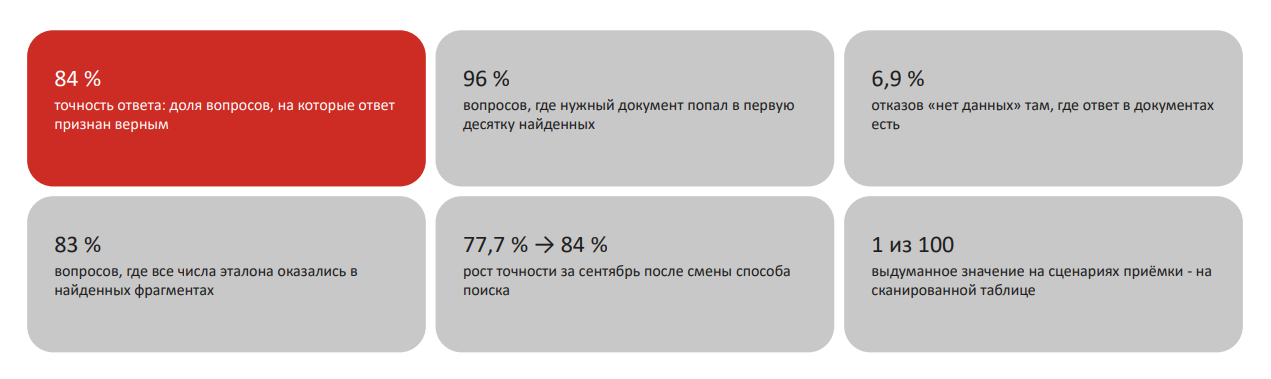
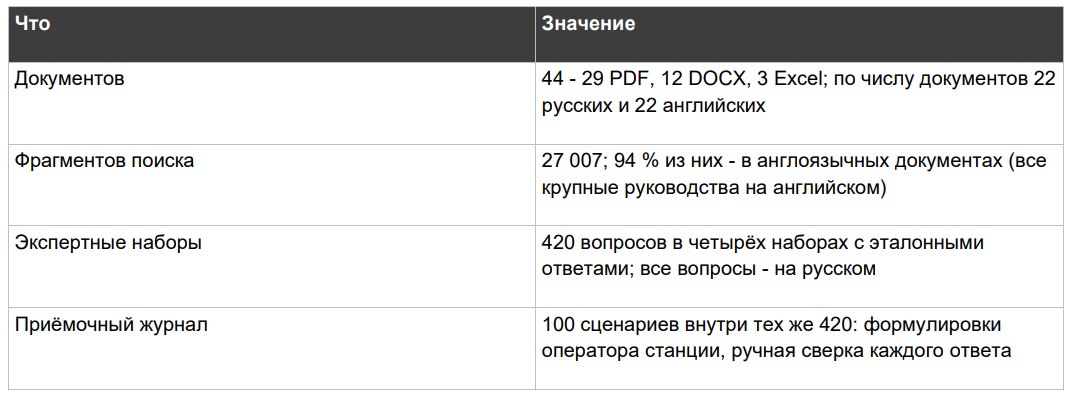
Поэтому разные направления готовят общий контрольный набор на 100 вопросов и эталонных ответов к ним: продажи, инжиниринг и другие подразделения. Такой же набор делаю и я.
На этом пилоте будем смотреть, насколько система реально знает нашу документацию и где начинает фантазировать. Только после этого есть смысл переходить от пилотного набора файлов к полноценной базе знаний.
RAG по насосам? Пока почти утопия
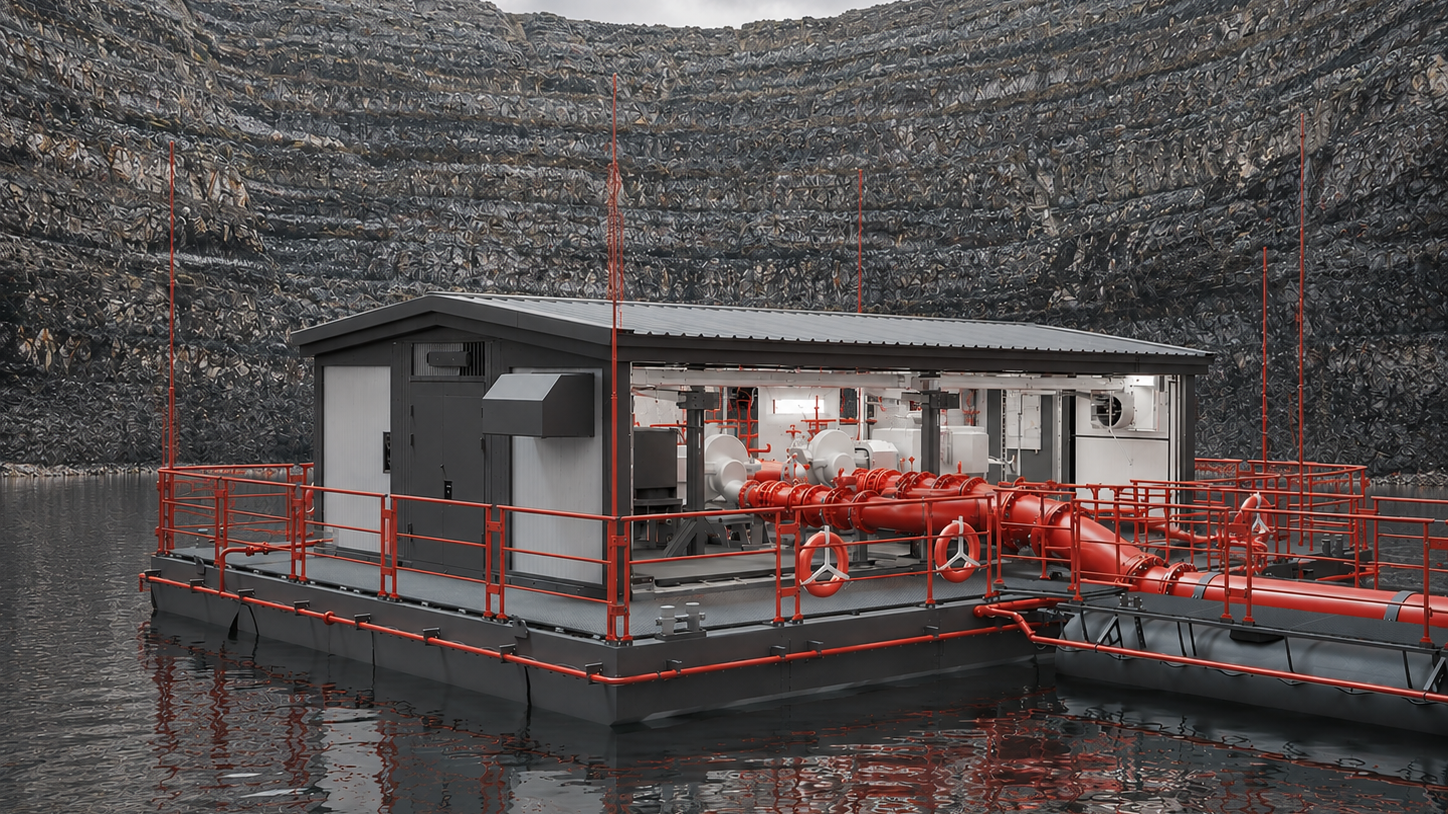
Мы хотели бы сделать похожую систему знаний по насосному оборудованию, особенно по сложным плавучим насосным станциям. На мой взгляд, прямо сейчас полноценный RAG по этому направлению — утопия.
Не потому что не хватает умной модели. Можно купить самые хорошие GPU и поставить сильную LLM. Но если знания компании разбросаны по головам людей и сотням файлов, AI нечего нормально читать. Поэтому у нас сначала должна появиться база знаний: из каких блоков она состоит, какая информация эталонная, как связаны проекты, расчёты, комплектующие и эксплуатация, какая версия актуальная и кто отвечает за обновление. Только исходя из этого можно будет смотреть в сторону разработки RAG по насосным станциям.
Что придётся построить кроме RAG
Excel-реестр годится только на пилот. Для нормальной эксплуатации всё равно нужны версионность, владелец данных, правила актуализации, понятная структура и связь документа с конкретной версией продукта. Причём это вообще не AI. Это обычная цифровизация, которую просто стало невозможно дальше откладывать.
И это, наверное, один из самых полезных побочных эффектов внедрения. AI заставляет приводить в порядок то, что компания годами могла не замечать.
Локальный контур — коротко
Практика только укрепила нас в идее гибридного контура, о котором я подробно писал в статье про информационную безопасность. Интеллектуальную собственность, договоры, персональные данные и чувствительную техническую информацию мы не хотим отдавать наружу, поэтому внешние облачные сервисы мы подключаем точечно и только там, где данные полностью обезличены и нет риска утечки интеллектуальной собственности завода.
AI очень быстро показывает, насколько компания готова к цифровизации
До AI многие процессы выглядят нормальными, потому что не видно, как именно они работают. Опытный сотрудник знает, где лежит файл, помнит, какая версия правильная, понимает, кому позвонить и что спросить. Система держится на людях и привычках.
Когда пытаешься объяснить этот процесс модели, бардак становится очевидным.
Разматывая цепочки задач по автоматизации, мы выделили три главных фактора, которые тормозят внедрение:
-
Автоматизация костылей. Начинаешь разбирать процесс, чтобы отдать его нейросети, и выясняется, что сам регламент — многолетний костыль, который давно потерял смысл. ИИ-костыль бизнесу не нужен, поэтому приходится нажимать на тормоз и сперва чинить реальную, а не цифровую логику работы.
-
Сырые и дырявые вводные. Технологии описаны криво, в документах зияют пробелы, половина данных устарела два года назад, а остальное живет в табличке Excel, которую кто-то ведет уже десять лет. Снова берем паузу и вместо магии алгоритмов ид`м вручную чистить и верифицировать корпус документов.
-
Конфликт приоритетов и размытая ответственность. При реализации пилота никто не снимает обязанности с владельцев процессов. Подготовка датасетов для IT падает на них вторым слоем с нагрузкой x2. Может ли в такой спешке пострадать качество технической базы? Гарантированно. Сможет ли разработчик со стороны понять, где в чертежах ошибка? Нет. В итоге задача скатывается в формальное «они просили залить файлы — я залил».
Мне почему-то казалось, что людей, которые умеют системно мыслить, поставить задачу, разложить её на части и нормально сформулировать ожидаемый результат, намного больше. Это была одна из моих главных ошибок.
Плюс люди не любят менять процесс. Гораздо удобнее оставить всё как есть и держать знания у себя в голове. А потом взять одну из самых сильных современных моделей и использовать её для проверки орфографии. И после этого сказать, что AI не особо полезен.
Модель не читает мысли. Если ты не дал ей нормальный контекст, не подготовил исходные данные и сам толком не понимаешь задачу, качественного результата не будет. AI очень быстро показывает качество мышления самого пользователя.
Скепсис внутри завода мы переломили. Инструментом на постоянной основе пользуются десятки специалистов, но я сознательно отказался от формальных метрик числа пользователей, потому что поставить себе KPI «выдать доступ 500 сотрудникам» — самый простой способ пустить пыль в глаза самому себе.
Настоящую эффективность я измеряю тем, сколько технологических рисков мы отловили до отгрузки, насколько сократили цикл подготовки КП и смогли ли снять с инженеров рутину поиска чертежей.
Сколько всё это стоит: бюджет AI-направления
Есть ещё один момент, который часто теряется в красивых рассказах про корпоративный AI: это совсем не дешёвая игрушка.
На июль-декабрь 2026 года на само AI-направление ПСМ заложено около 22 млн рублей текущих расходов. Примерно 17 млн из них — команда. Отдельно покупаем собственный AI-сервер примерно за 5,5 млн рублей.
Общую инфраструктуру для ERP, Bitrix, SCADA и других направлений, я сюда специально не отношу, чтобы не размывать учёт.
Если честно спросить, вернулись ли эти вложения прямым рублём — разумеется, нет. Инвестиции в R&D на старте всегда существенно опережают прямую финансовую отдачу. Тем не менее, первые результаты уже видны:
-
Риск-менеджмент (attention-боты) — модели, которые анализируют рабочие коммуникации, выцепляя маркеры проблем быстрее людей. Например, когда в переписке с заказчиком всплывает спор по гарантии, зависает согласование критичного этапа или в проект пролезают кабальные неустойки. Человек в рутине может пропустить вспышку, а бот сразу поднимает красный флаг и подсвечивает риск руководителю.
-
Контроль качества документов. Когда перед тобой спецификация на 50 страниц, то уже к десятой плывёт внимание и пропускаются типовые нестыковки. AI на таких формализуемых проверках может работать в разы системнее и тщательнее проверять опечатки в марке комплектующих, нестыковки в характеристиках между разными разделами, забытые параметры и не дать выпустить документ с противоречиями.
-
Первичная квалификация входящих обращений. По оценке коммерческого отдела, бот взял на себя около 70% рутинных операций по первичной фильтрации лидов (отсеивание спама, нецелевых запросов и дубликатов), разгрузив рабочее время менеджеров.
Но главный практический эффект первых трёх месяцев лежит в другой плоскости. Я не могу назвать это финансовой окупаемостью, но проект RAG сработал как самый неподкупный аудитор наших внутренних регламентов. Он заставил завод вскрыть старые завалы в технической документации, которые годами маскировались привычкой «спроси у Петровича, он помнит».
В октябре пора перестать бесконечно строить фундамент
Сейчас команда тратит примерно 70% времени на платформу и 30% на прикладные сервисы. На этапе строительства фундамента это нормально, но так продолжаться бесконечно не может.
Мы поставили перед собой задачу — в октябре довести платформу до базового рабочего состояния и потом перевернуть пропорцию, чтобы в итоге условно 20% усилий были на платформу и 80% на реальные прикладные решения. Потому что платформа сама по себе бизнесу не нужна. Нужно чтобы процесс стал быстрее, качественнее, безопаснее или вообще начал работать по-другому.
Отдельный большой блок — кодинг с помощью AI. Если мы научимся быстрее писать и менять внутренние системы, это ускорит стандартную цифровизацию ПСМ: ERP, Bitrix, интеграции и другие вещи, которые промышленная компания обычно внедряет годами.
Самое интересное — AI внутри промышленного продукта
Пока большинство реально работающих сервисов ПСМ связано с документами, контролем, продажами и офисными процессами. Однако стратегически мы видим свой AI не в этом.
Делаем ставку на промышленную автоматизацию и прикладные продукты. SCADA и предиктивная аналитика, которые показывают, что уже произошло, и помогают увидеть проблему заранее, до поломки.
-
Внедрено и работает: офисные ассистенты, боты контроля договорных рисков, первичный фактчек сопроводительной документации
-
В стадии пилота: RAG-система по технической базе ГПУ 1 МВт
-
В стадии прикладного R&D: интеграция предиктивных моделей в нашу диспетчерскую систему SCADA (прогнозирование предотказных состояний и расчет остаточного ресурса до поломки), а также ассистенты инженера-проектировщика для автоматической компоновки шкафов управления
Сейчас здесь больше R&D, чем готовых результатов. И я специально не хочу писать, что мы уже внедрили что-то великое. Но именно AI-направление для промышленной компании выглядит самым интересным. AI должен постепенно выйти из чатов и документов и переместиться внутрь продукта.
В самом начале у нас была идея просто внедрять AI внешним компаниям. Довольно быстро стало понятно, что это бездонный океан кастомной разработки, где у каждого свои данные, процессы, интеграции и хотелки.
Поэтому сейчас логика другая. Сначала нужно обкатать решения на себе, потом стандартизировать, собрать продукт и только после этого идти с ним на рынок. Голубая мечта остаётся прежней — AI ready под ключ: инфраструктура, вычисления, платформа и прикладные сервисы в одном контуре. Но до этого ещё предстоит дорасти.
Главный риск — автоматизировать старый завод
Внутри своей традиционной отрасли ПСМ, на мой взгляд, идёт по пути AI намного быстрее большинства конкурентов. Но это вообще ничего не гарантирует. Сравниваться нужно с мировыми технологическими лидерами, потому что там скорость изменений просто безумная. Можно долго считать себя самым цифровым заводом в локальной и привычной среде, но при этом глобально отстать в разы.
Главный риск в том, что корпоративное внедрение растянется на много лет. Мы можем построить платформу, сделать сотню сервисов, выдать доступ 500 сотрудникам, а сама компания по сути продолжит работать по-старому.
Поэтому при всех текущих инвестициях, IT-команде, платформе, сервере и работающих сервисах текущий уровень внедрения AI в ПСМ я оцениваю примерно в 1,5 из 10.
Чем глубже погружаешься, тем меньше ощущение, что «мы уже что-то внедрили», и тем лучше видно масштаб задачи.
Как я пойму через пять лет, что всё это было не зря
У меня довольно простой критерий. Через пять лет ПСМ должна стать условно в 10 раз больше. Но численность сотрудников не должна вырасти в те же 10 раз.
Если людей станет, например, в три раза больше, а бизнеса в десять, значит, мы действительно научились расти по-другому. И AI вместе с роботизацией и обычной цифровизацией должны быть одними из главных причин, почему это вообще стало возможно.
Вторая часть цели — сделать так, чтобы направления, связанные с AI, уже занимали заметное место в портфеле промышленной компании как реальный бизнес с готовыми и тиражируемыми продуктами.
Я считаю AI новым электричеством. Можно ошибиться в конкретной модели, закрыть неудачный сервис, купить не то железо или потерять деньги на проверке гипотез. Но вообще пропустить этот переход для промышленной компании — подобно смерти.
Поэтому главный вопрос для нас сейчас: успеем ли мы перестроить компанию быстрее, чем изменится сам рынок?
Автор: psm_medved

