


TL;DR
-
Время на погружение в контекст теперь приходится в основном на этап ревью.
-
Если принимать код только потому, что он работает, можно накопить долг, которого команда даже не замечает.
-
Стоит либо снижать объём ручного ревью, либо автоматизировать повторяющиеся проверки.
В разговоре с одним из клиентов об AI-разработке я услышал мнение, что ревью кода, сгенерированного агентами, создаёт огромную когнитивную нагрузку — приходится одновременно держать в голове множество деталей, чтобы понять работу и оценить её качество.
Сам я почти никогда этого не ощущал. Думаю, дело в том, что я начал пользоваться AI-инструментами для разработки ещё с бета-версии GitHub Copilot и привык к небольшим задачам, маленьким коммитам и коротким циклам обратной связи.
Тогдашние модели плохо справлялись с большими задачами. Я разбивал проблемы на части, читал и исправлял результат и постепенно погружался в код и его ограничения. По мере роста возможностей моделей я одновременно учился понимать, где им можно доверять.
Сегодня модель способна за один раз сгенерировать большой объём кода. Но время, необходимое для погружения в его контекст, не сокращается автоматически вместе со временем написания кода. Если понимание больше не формируется по ходу реализации, вся эта нагрузка накапливается и обрушивается на человека в момент, когда он получает готовый результат.
Мне кажется, из-за этого люди могут начать принимать незнакомый им код просто потому, что он работает, и тем самым накапливать «когнитивный долг», которого сами не замечают. Чтобы разорвать этот цикл, нужно либо снижать нагрузку при ревью кода, архитектуры и документации, либо вообще убирать человека из рутинных повторяющихся проверок.
1. Время на погружение в контекст сжимается до этапа ревью
Когда разработчик писал код сам, ему приходилось читать окружающий код, переводить требования в реализацию и исправлять падающие тесты. В процессе он понимал, зачем нужна именно такая структура и при каких условиях она может сломаться.
То есть время написания кода одновременно было временем погружения в контекст. Даже если понимание оставалось неполным, у разработчика всё равно постепенно складывалась рабочая модель, на которую можно было опереться при следующем решении.
Когда реализацию делегируют, человек сразу получает готовый результат. Теперь ему приходится идти в обратную сторону: разбирать код и тесты, чтобы восстановить замысел, исходные предположения и исключения. Работа, которая раньше была распределена по всему процессу разработки, теперь должна уместиться в короткое окно ревью.
DORA описывает это как перенос времени с генерации на проверку и прямо подчёркивает разницу между этими задачами.
«Проверка — это принципиально иная когнитивная задача, чем создание».
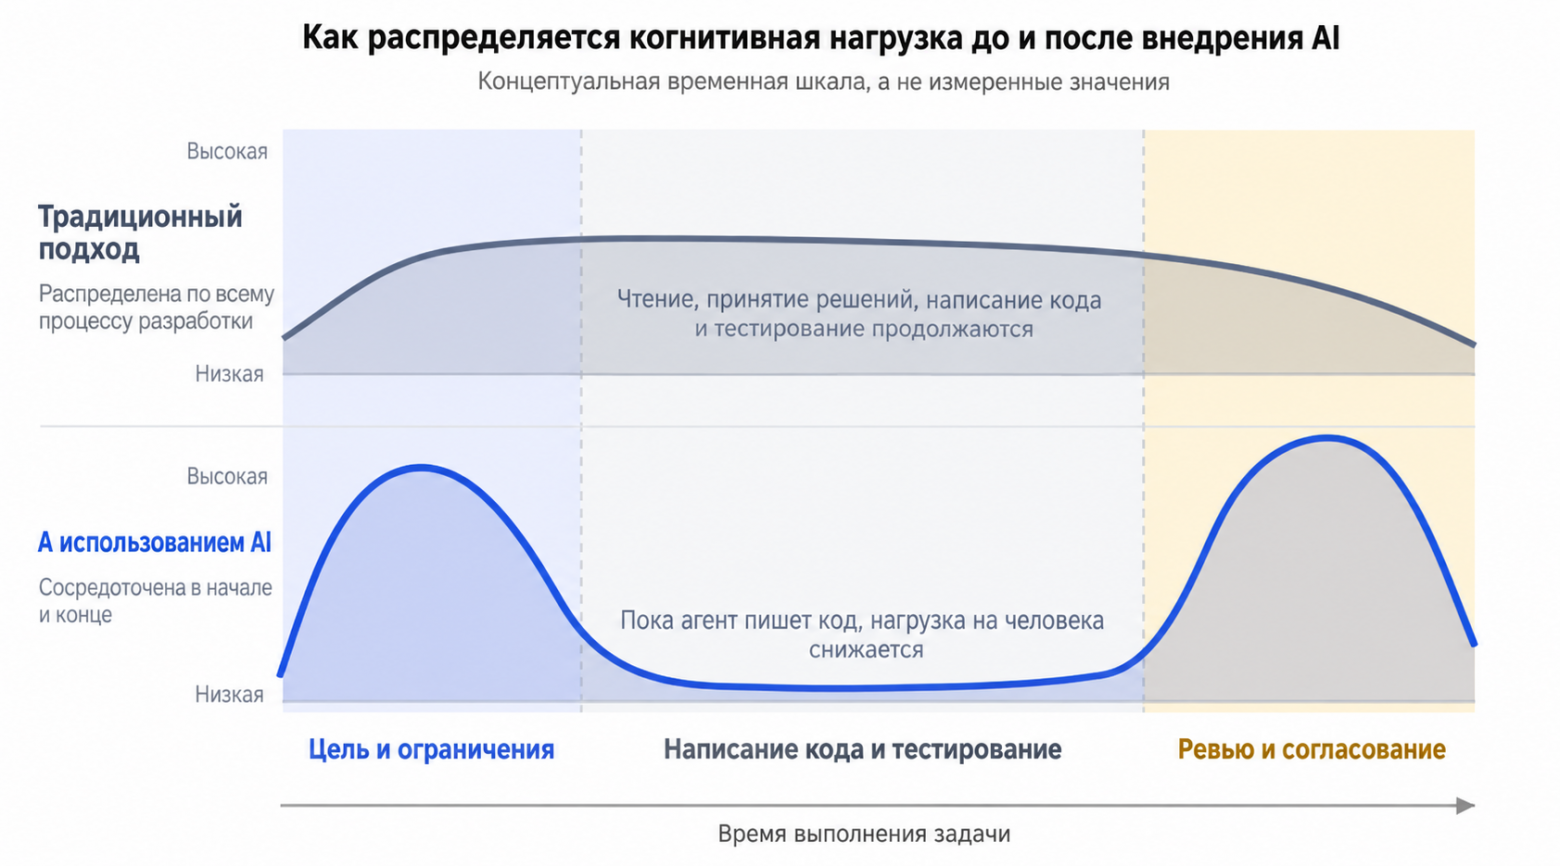
На этой схеме видно, на каком этапе приходится основная работа. Если тот же объём кода генерируется быстрее, это ещё не значит, что вся задача ускоряется пропорционально: человеку всё равно приходится отдельно погружаться в контекст.
Если при прежних сроках одновременно брать в работу больше изменений, людям приходится постоянно переключаться между незнакомыми контекстами. Для отдельного разработчика это оборачивается когнитивной нагрузкой, а на уровне команды — очередями на ревью и дополнительными доработками.
В этой статье под обратным давлением на этапе ревью я понимаю ситуацию, когда прогресс упирается в способность людей разобраться во входящем потоке изменений и проверить его. Если объём генерации растёт, а время на погружение в контекст всё сильнее сжимается, это давление только усиливается.
2. Долг, который берут осознанно, и долг, которого не замечают
Когда говорят о техническом долге, обычно имеют в виду компромисс между сроками релиза, производительностью и стоимостью дальнейшей поддержки. Например, команда может осознанно отложить устранение дублирующей реализации, чтобы выпустить продукт быстрее.
Описывая осознанный технический долг, Мартин Фаулер отдельно подчёркивает этот момент.
«Команда знает, что берёт на себя долг».
Если команда понимает, что именно она отложила и во что это может обойтись, погашение такого долга становится решением, которое можно обсуждать. Но технический долг бывает и непреднамеренным. Здесь важно различать осознанный компромисс и пробел в понимании, который незаметно проходит через ревью.
Когнитивный долг — это отсутствие у команды общего понимания того, как ведёт себя система и как на неё повлияют изменения. Здесь я рассматриваю ситуации, когда команда принимает код, не осознавая в полной мере, что такой пробел вообще существует.
Представим гипотетическую функцию защиты от повторного списания. Платежи через интерфейс проходят, тесты с повторными попытками тоже зелёные, но никто не проверил, что произойдёт при повторной попытке после потери записи или если два запроса придут одновременно.
Под контрактом здесь понимается поведение и набор условий, которым должна соответствовать реализация. Например, один запрос не должен приводить к двум списаниям. Знать сам контракт — не то же самое, что понимать, при каких именно условиях реализация действительно его соблюдает. Если принять результат просто потому, что он работает, команда может даже не заметить, что именно осталось непроверенным.
Отложить разбор под давлением сроков и необходимости быстрее согласовать изменения можно вполне осознанно. Но это ещё не значит, что команда понимает масштаб и последствия оставленного пробела. Стори разделяет эти два момента.
«Даже когда такое решение принимается осознанно, возникающий долг накапливается незаметно».
— Маргарет-Энн Стори
Позже кто-то сокращает срок хранения платёжных записей, чтобы уменьшить расходы на хранение данных. Ревьюер, который не понимает связи с повторными попытками, может пропустить ошибочное изменение. Когнитивный долг ухудшает качество последующих решений: из-за него может расти технический долг или позже обнаруживаться уже существующая проблема.
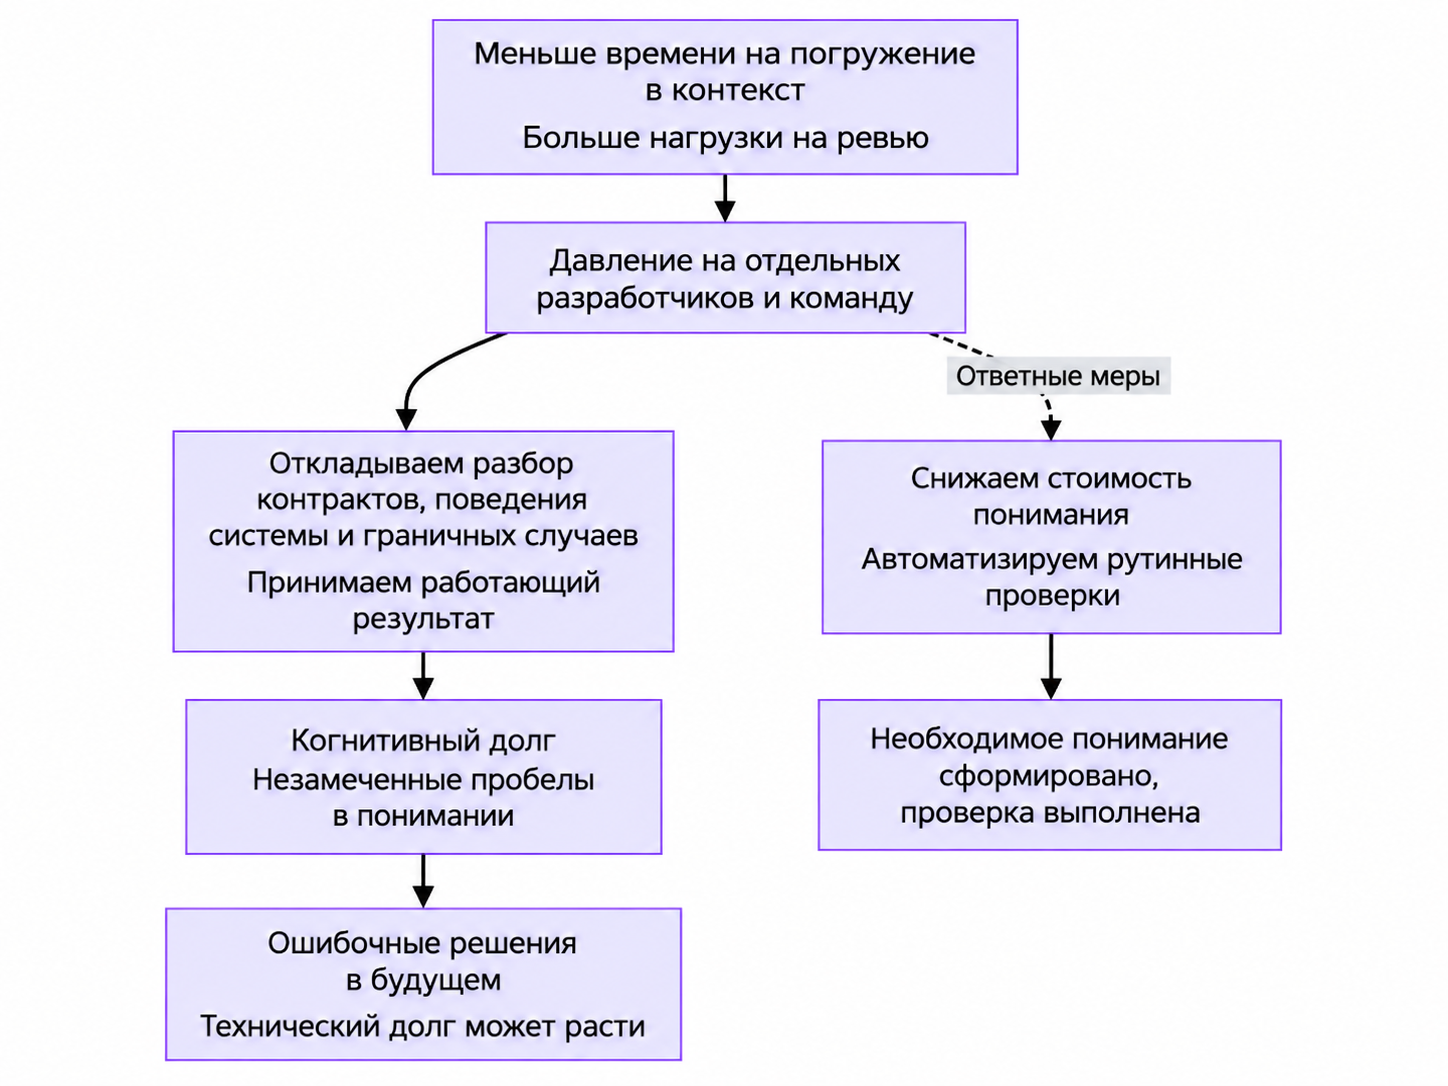
На схеме показан один из возможных сценариев, когда команда принимает код раньше, чем успевает в нём разобраться. Когнитивный долг не исчезает, превращаясь в технический. Недостаток понимания и ошибочный код, который он позволяет пропустить, могут существовать одновременно.
3. Скорость команды ограничена более медленным этапом проверки
Чтобы не накапливать когнитивный долг, нужно понять, сколько изменений команда способна обрабатывать, успевая при этом разобраться в них и выполнить необходимые проверки. Когда генерация становится достаточно быстрой, именно пропускная способность проверки начинает ограничивать скорость работы команды. В рекомендациях Microsoft по узким местам в системах этот принцип формулируется так:
«Система может обрабатывать данные лишь с той скоростью, которую позволяет её самый медленный компонент».
— Microsoft
Применим этот принцип к ревью. Предположим, что генерация и доставка не создают других узких мест, а входящего потока изменений достаточно, чтобы полностью загрузить ревью. Каждое изменение проходит автоматические проверки, а на ручное ревью попадают только те изменения, где нужна человеческая оценка. При этом оба этапа могут параллельно обрабатывать разные изменения. Будем считать, что единицы изменений и критерии качества одинаковы.
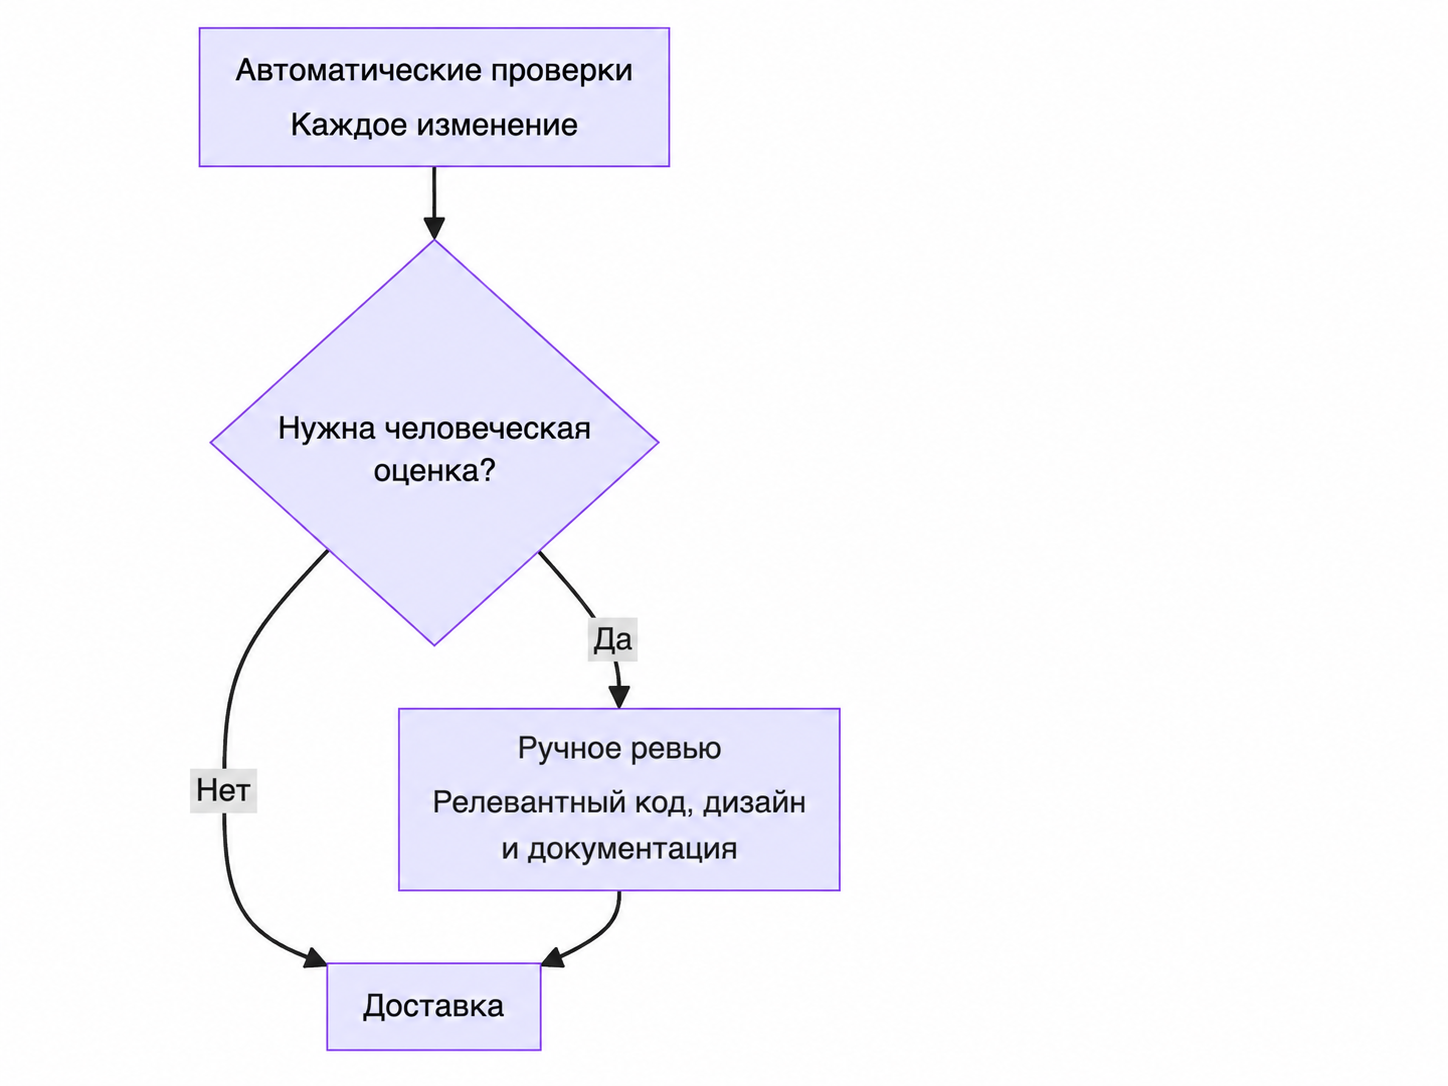
Если выразить пропускную способность обоих этапов в количестве обрабатываемых изменений, скорость команды, ограниченная этапом ревью, можно приближённо представить так. Это модель узкого места, которая помогает понять, что именно стоит улучшать, а не формула, полученная из замеров реальных команд.
team velocity ≈ min(human review velocity, automated review velocity)Здесь скорость означает количество изменений, которые проходят одни и те же критерии качества, а не просто число одобрений. Повторные доработки и ожидание могут снижать фактическую пропускную способность. Если генерация или доставка работают медленнее, их тоже нужно учитывать при поиске узкого места.
Представим гипотетическую команду, где каждое изменение требует ручного ревью. Люди успевают проверить восемь изменений в день, а автоматические проверки — двенадцать. min выбирает меньшее значение, поэтому min(8, 12) = 8. Даже если автоматизация успевает обработать двенадцать изменений, команда сможет стабильно доставлять около восьми в день, если люди успевают отревьюить только восемь.
Откуда берётся эта пропускная способность ручного ревью — восемь изменений в день? Её можно вычислить из времени, доступного для ревью, и среднего времени на одно изменение.
H = доступное время на ручное ревью в день
C = среднее время ревью одного изменения, требующего человеческой оценки
p = доля всех изменений, требующих ручного ревью

human review velocity = H / (p × C)
Допустим, у команды есть 240 минут в день на ревью, а одна проверка в среднем занимает 30 минут. Каждое изменение требует ручного ревью, поэтому p = 1. Подставим значения: 240 / (1 × 30) = 8. Получаем пропускную способность в восемь изменений в день.
Теперь предположим, что ручного ревью требует только половина всех изменений, то есть p = 0,5. Если H и C не меняются, получаем 240 / (0,5 × 30) = 16. Люди проверяют восемь из этих шестнадцати изменений, затрачивая 8 × 30 = 240 минут. Знаменатель p × C — это среднее время ручного ревью, приходящееся на одно изменение среди всех изменений.
Поэтому результат показывает общее количество изменений, которое способна поддержать имеющаяся пропускная способность ручного ревью, а не число ревью, которые люди выполняют непосредственно. Поскольку автоматические проверки по-прежнему обрабатывают только двенадцать изменений в день, скорость команды теперь равна min(16, 12) = 12, то есть примерно двенадцати изменениям в день.
В C входит чтение кода, восстановление контекста, проверка предположений в архитектуре и документации, а также разбор исключений. Чем больше времени требуется, чтобы понять незнакомый контекст и разобраться в сложных условиях, тем выше становится C. Если доступное время на ревью H и доля изменений, требующих ручного ревью, p остаются прежними, рост C означает, что команда сможет обработать меньше изменений.
Поэтому я считаю, что когнитивная нагрузка может быть обратно связана со скоростью команды. Здесь я связываю когнитивную нагрузку с пропускной способностью через время, необходимое на понимание и оценку. Я не утверждаю, что между каким-либо численным показателем психологической нагрузки и скоростью команды существует точная обратная зависимость. Речь о том, что когнитивная нагрузка ограничивает скорость команды в ситуации, когда узким местом становится ручное ревью.
Вернёмся к исходному условию, где каждое изменение требует ручного ревью. Предположим, что за счёт снижения усилий на погружение в контекст теперь можно провести ревью того же качества за 15 минут. H остаётся равным 240 минутам, p — единице, а C снижается: 240 / (1 × 15) = 16. Если сократить время одного ревью вдвое, пропускная способность ручного ревью удвоится. При неизменной пропускной способности автоматических проверок скорость команды может вырасти примерно до двенадцати изменений в день.
Если численность команды и доступное время не меняются, на стороне ручного ревью остаются два основных рычага — C и p: можно снизить стоимость понимания и оценки либо уменьшить долю изменений, которые требуют непосредственного участия человека. Если какой-то поток изменений вообще не требует ручного ревью, этот этап нужно просто убрать из модели пропускной способности, а не пытаться делить на ноль.
4. Снизить стоимость погружения в контекст
Первое направление — сделать необходимое ручное ревью менее трудозатратным. C растёт, когда при каждом ревью кода, архитектуры или документа с требованиями людям приходится с нуля восстанавливать цель изменений и заложенные в них предположения.
Я бы определял контракт ещё до начала реализации, а готовый результат связывал с поведением системы до и после изменения, сценариями сбоев и проверяемыми результатами. В контракте стоит зафиксировать наблюдаемое поведение, условия, которые должны выполняться, а также кто и какие данные может читать или изменять.
В примере с платежами простого сообщения о том, что тесты прошли, недостаточно. Гораздо полезнее понимать, какие сценарии повторных попыток были проверены, как учтены потеря записи и одновременные запросы и какие решения всё ещё остаются открытыми. Пояснения должны вести прямо к соответствующему коду и реально выполненным тестам — так восстановление контекста требует меньше усилий.
Можно уменьшить и объём информации, с которым приходится разбираться за один раз. Реализуйте одну небольшую часть требования, разберитесь в ней, проверьте её и только потом делайте коммит. Если сначала сгенерировать несколько небольших пулл-реквестов — запросов на ревью и слияние изменений, — а прочитать их все только потом, время на погружение в контекст снова окажется сдвинуто в самый конец.
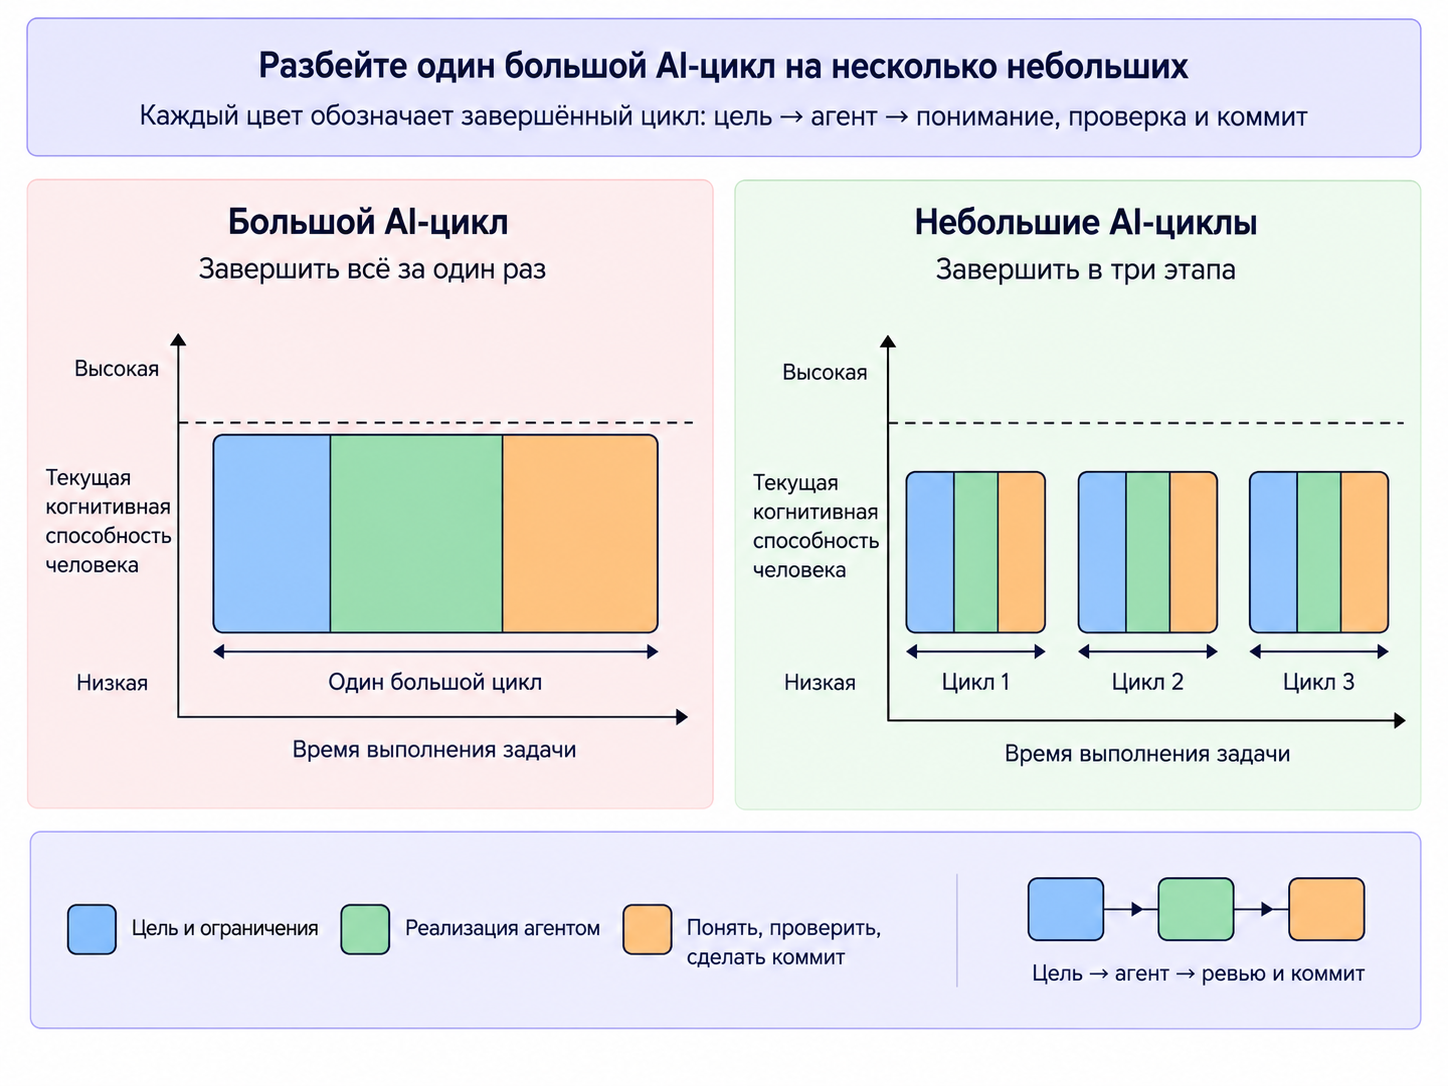
На схеме показано, как понимание формируется между небольшими шагами реализации. Контекст текущего небольшого изменения становится отправной точкой для следующего.
Уже накопленный когнитивный долг всё равно придётся погашать. На совместный разбор кода и дизайна, поиск пропущенных предположений и сценариев сбоев, а также исправление ошибочной реализации нужно время. Если зафиксировать поведение системы и исходные предположения в коде, документации и тестах, при следующей задаче не придётся снова восстанавливать весь этот контекст с нуля.
В ALPS Writer Plugins, которые я поддерживаю, я заложил критерии для разбиения работы на части и проверки результатов на соответствие контрактам. Долгосрочные решения фиксируются в записях архитектурных решений (ADR), а пояснения к реализации связывают сценарии обработки запросов и сбоев с конкретным кодом и тестами.
Само наличие документации ещё не означает, что система понятна команде. Мейнтейнеры должны уметь объяснить поведение, которое важно для будущих изменений и реагирования на инциденты. Небольшие изменения и понятные проверяемые результаты помогают поддерживать такое понимание.
5. Убрать людей из рутинных проверок
Второе направление — перестать требовать одного и того же ручного ревью для каждого изменения. Если людям приходится снова и снова перечитывать условия, которые можно проверить автоматически, p остаётся высоким.
Если на ревью постоянно приходится проверять, какие модули могут зависеть друг от друга, эти связи можно контролировать архитектурными тестами. Если ревьюеры раз за разом убеждаются, что один и тот же запрос не обрабатывается дважды, регрессионные тесты могут проверять, что последующие изменения не вернули эту проблему. Если накапливать такие решения в инфраструктуре проверок (harness) — рабочих инструкциях, инструментах и среде верификации, — их можно использовать повторно.
В целевом для меня сценарии, если согласованный контракт достаточно полно проверяется автоматически, повторное одобрение человеком больше не требуется. Люди подключаются там, где нужно определить новое поведение продукта, изменить контракт, оценить условия с высоким риском или проверить предположения, которые автоматизация подтвердить не может.
Одного заявления агента о том, что всё в порядке, недостаточно, чтобы отказаться от ручного ревью. Должно быть понятно, что именно было проверено, а результаты проверки должны быть доступны человеку. Иначе процесс просто начинает быстрее пропускать незнакомый код.
Автоматизация проверок — это не то же самое, что поддержание необходимого понимания системы. Людям не обязательно читать каждую деталь реализации, но команда по-прежнему должна задавать цель и критерии качества и брать на себя ответственность за последующие изменения.
Пока этот переход не завершён, стоит контролировать поток новой работы, поступающей в процесс. Само по себе снижение количества входящих изменений не уменьшает стоимость понимания одного ревью. Освободившееся время лучше использовать на улучшение пояснений, контрактов, тестов и инструментов — тогда в дальнейшем пропускная способность сможет вырасти.
После автоматизации нужно заново оценить сложность тех ручных ревью, которые остались. Исключение рутинных изменений может снизить p, но одновременно увеличить C, потому что людям останутся более сложные решения. Поэтому стоит смотреть на фактическое время ревью и его качество. Автоматическая проверка тоже требует затрат на инструменты и эксплуатацию, поэтому полезно оценивать CTS-SW — стоимость доставки одной единицы ПО пользователю, — чтобы понять, снизилась ли общая стоимость.
Подведем итоги
AI сокращает время написания кода, но людям всё равно может понадобиться отдельное время, чтобы погрузиться в контекст. Если принимать работающий результат, игнорируя этот разрыв, можно накопить когнитивный долг — причём команда не всегда будет понимать, каких именно знаний ей не хватает.
Требование одобрять изменения ещё быстрее под тем же давлением вряд ли решит эту проблему. При неизменном качестве нужно либо снижать усилия, необходимые для ручного ревью, либо убирать людей из рутинных повторяющихся проверок. На мой взгляд, именно это становится главной задачей для роста скорости команды после того, как генерация кода уже перестаёт быть узким местом.
Что почитать по теме:
Почему AI-агенты ломаются на длинных задачах — и как обвязка помогает им дописывать приложения
Кто платит за ИИ-продуктивность: почему выгорают middle-инженеры
Работа с AI-инструментами меняет привычный процесс разработки: часть задач по созданию кода уже можно делегировать моделям, но вопросы проверки результата, качества и понимания контекста остаются за инженером. Разобраться, как выстроить этот процесс на практике, можно на бесплатных уроках Otus:
-
29 сентября, 20:00. «Зелёные тесты, неверный продукт: как системному аналитику принимать работу ИИ-агента». Записаться
-
1 октября, 20:00. «Продуктивность разработчика и Agent Skills». Записаться
Автор: kmoseenk

