


Последнюю неделю я делал StoryOps.
Если очень грубо, это набор Agent Skills и утилит для Codex/Claude Code, который должен помогать мне писать технические статьи. Он умеет читать мои предыдущие публикации, смотреть историю проекта, искать изменения в Git, собирать evidence, анализировать текущий Хабр и только после этого предлагать следующую статью.
Звучит удобно.
А потом я поймал себя на довольно неприятной мысли.
Я буквально автоматизирую производство контента. Причём следующим логичным шагом было бы сделать так:
репозиторий
    ↓
агент
    ↓
статья
    ↓
Хабр
Ещё немного автоматизации, и можно выпускать статьи быстрее, чем я успеваю их перечитывать.
И где в таком случае проходит граница между нормальным использованием ИИ и тем самым AI slop, который многие уже терпеть не могут?
В 2025 году American Dialect Society вообще выбрала slop словом года, определив его как низкокачественный контент, производимый в больших объёмах, чаще всего с помощью генеративного ИИ.
Но это определение сразу создаёт проблему.
Если я использовал Claude для статьи, это slop?
Если ИИ написал 80% текста, а я неделю проверял источники и переписывал его, это slop?
А если человек самостоятельно написал 300 SEO-страниц ради поискового трафика, это уже качественный человеческий контент только потому, что токены генерировал биологический процессор?
Мне стало интереснее разобраться не в том, можно ли распознать AI-текст, а в другом вопросе:
Что вообще плохого происходит с интернетом, когда стоимость производства информации стремится к нулю, а количество человеческого внимания остаётся конечным?
И заодно понять, не строю ли я сам именно ту систему, от которой пытаюсь защититься.
Для начала: AI-generated и AI slop — вообще не одно и то же
Сейчас эти понятия часто смешиваются.
Есть просто контент, при создании которого использовали ИИ.
Есть полностью сгенерированный контент.
Есть массово произведённый контент.
Есть низкокачественный контент.
И только часть пересечения этих множеств имеет смысл называть slop.
Мне нравится определение из исследования, опубликованного в JMIR Medical Education. Авторы оценивали AI-видео на TikTok и YouTube и определяли slop через степень человеческой заботы о производстве, а не просто через факт использования модели.
По-моему, это куда полезнее привычного:
сделано ИИ → мусор
Потому что тогда проблема выглядит скорее так:
ИИ
+
массовое производство
+
минимальная проверка
+
минимальная ответственность
+
цель захватить внимание
=
очень хороший кандидат в slop
А это уже другое утверждение.
Так сколько AI-контента вообще стало в интернете?
Тут начинается веселье.
Если погуглить этот вопрос, можно найти числа от 5% до 75%, и все они могут быть честными.
Потому что исследования измеряют совершенно разные вещи.
Pew Research Center в 2026 году взял 490 тысяч случайных англоязычных страниц из Common Crawl. В июльском срезе признаки существенного AI-авторства или AI-редактирования обнаружились примерно у 10% всех страниц. Но если смотреть только страницы, опубликованные уже после появления ChatGPT, доля превышала треть.
Graphite исследовал не весь веб, а 55,4 тысячи англоязычных статей и listicles. По их методике, в первом квартале 2026 года 49,9% новых статей были преимущественно AI-generated. Что интересно, рост практически остановился: 49,6% в Q1 2025, 50,9% в Q4 2025 и снова 49,9% в Q1 2026.
Ahrefs получил ещё более пугающую цифру: среди 900 тысяч новых страниц, обнаруженных их краулером в апреле 2025 года, 74,2% содержали AI-generated content. Но формулировка здесь критична: «содержали AI-контент» гораздо шире, чем «были полностью написаны ИИ».
Получается примерно такая картина:
|
Исследование |
Результат |
Что реально измеряли |
|---|---|---|
|
Pew, 2026 |
10% |
Все случайные страницы в срезе веба |
|
Pew, 2026 |
>33% |
Страницы, опубликованные после запуска ChatGPT |
|
Graphite, 2026 |
49,9% |
Новые статьи/listicles, преимущественно AI-generated |
|
Ahrefs, 2025 |
74,2% |
Новые страницы, где обнаружено хотя бы некоторое AI-содержимое |
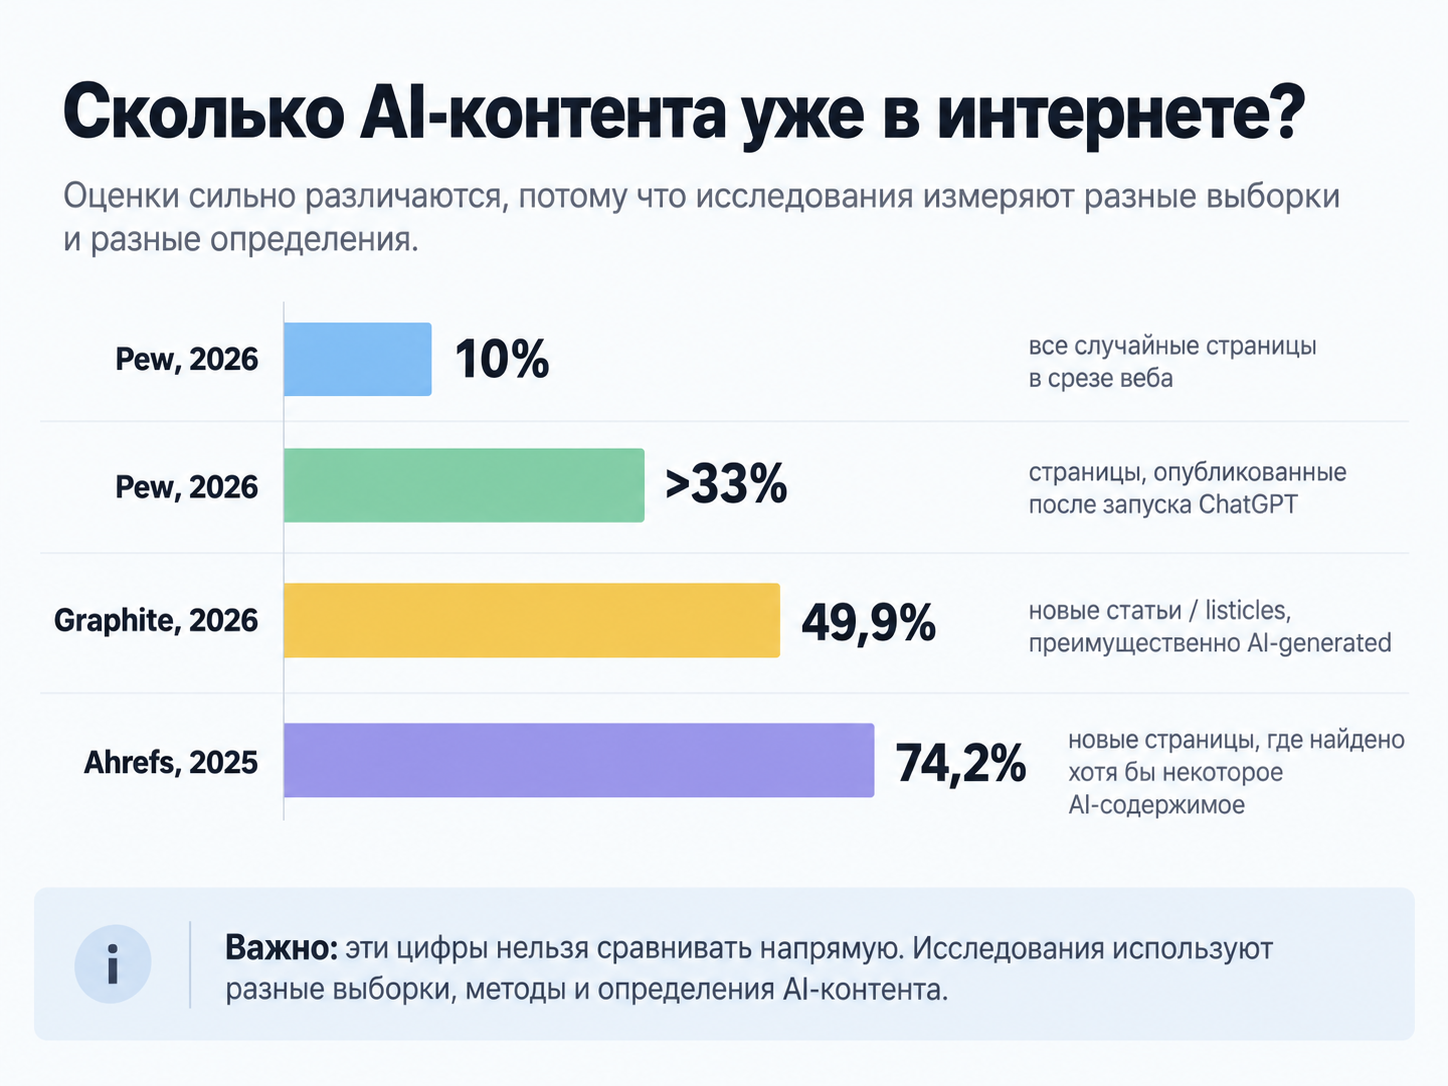
Складывать эти числа в один график «сколько процентов интернета захватил ИИ» я бы не стал.
Но направление довольно очевидное: AI-assisted и AI-generated публикации уже стали массовым явлением.
И вот здесь обнаруживается неожиданная деталь.
Производится такого материала огромное количество, но это ещё не означает, что он хорошо доходит до читателя.
Graphite отдельно изучил Google Search и источники, которые цитировали ChatGPT и Perplexity. В их выборке 86% статей в Google были human-written, а среди материалов, цитируемых ChatGPT и Perplexity, человеческими классифицировались примерно 82%. На первом месте Google AI-generated статьи встречались особенно редко: около 7,7%.
То есть мы уже получили первое интересное противоречие:
Производить AI-контент стало невероятно легко. Получать человеческое внимание от этого автоматически легче не стало.
А потом я посмотрел на TikTok
Здесь ситуация ещё страннее.
Kapwing в мае 2026 года создал совершенно новый TikTok-аккаунт и вручную классифицировал первые 500 роликов в For You.
294 из 500, то есть 59%, они отнесли к AI slop.
Для свежего аккаунта YouTube Shorts тот же эксперимент дал 104 из 500, или 21%. Дополнительно Kapwing вручную изучил 10 742 TikTok-видео из 20 категорий.
59% звучит почти как начало фильма про мёртвый интернет.
Но другое исследование даёт совершенно иную цифру.
Авторы peer-reviewed работы по образовательным биомедицинским видео исследовали 1082 ролика с TikTok и YouTube. Slop они признали только 57 видео, 5,3% выборки. Причём статистически значимой разницы по просмотрам, лайкам и комментариям между slop и остальными видео они вообще не обнаружили.
Это не противоречие.
Kapwing смотрел широкую рекомендательную ленту нового пользователя.
Исследователи JMIR изучали ограниченную образовательную нишу по конкретным поисковым запросам.
Но мне здесь понравился другой вопрос.
Если люди так ненавидят AI slop, какого чёрта его тогда столько в рекомендациях?
Возможно, slop вообще не обязан нравиться
Есть соблазн дать простой ответ:
TikTok специально пушит нейросетевой мусор.
Но доказательств именно такого механизма я не нашёл.
Официальное описание TikTok говорит, что For You использует пользовательские взаимодействия, лайки, шеры, комментарии, подписки, информацию о видео и другие сигналы. Причём полный просмотр более длинного ролика приводится как пример сильного сигнала интереса.
YouTube описывает похожую логику через три группы сигналов:
-
Appeal: выбрал ли пользователь видео;
-
Engagement: продолжил ли смотреть;
-
Satisfaction: остался ли доволен.
Кроме этого учитываются история просмотра, лайки, дизлайки, «не интересно» и даже пользовательские опросы. YouTube пишет, что его рекомендательные системы ежедневно обучаются более чем на 80 миллиардах сигналов.
Чего среди этих сигналов нет?
Сколько часов автор исследовал тему.
Сам ли он держал камеру.
Переписывал ли сценарий пять раз.
Проверял ли источники.
Или нажал Generate 30 раз подряд.
Алгоритм в основном видит реакцию зрителя на готовый объект.
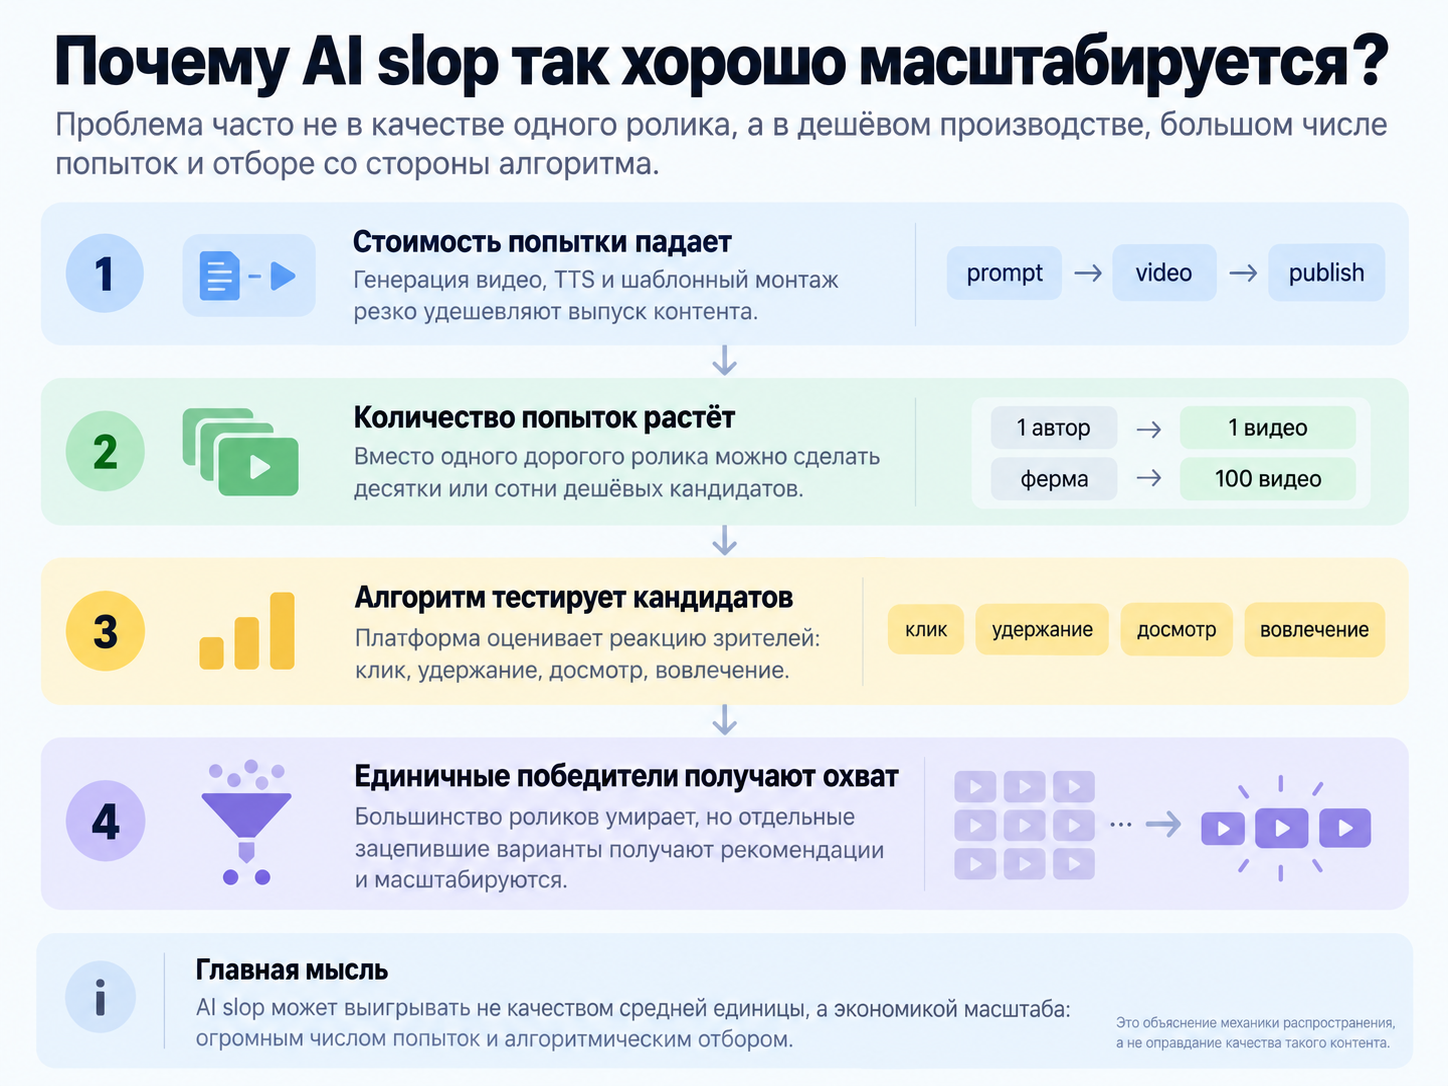
И здесь генеративный ИИ меняет не столько качество отдельного ролика, сколько экономику производства.
Один хороший ролик или сто лотерейных билетов
Раньше производство видео выглядело примерно так:
идея
↓
сценарий
↓
съёмка
↓
озвучка
↓
монтаж
↓
публикация
Теперь возможен другой pipeline:
prompt
↓
генерация видео
↓
TTS
↓
шаблонный монтаж
↓
публикация
Не обязательно хороший pipeline. Просто очень дешёвый.
И если стоимость одной попытки падает в десятки раз, стратегия тоже меняется.
Обычный автор думает:
Стоит ли мне потратить три дня на этот ролик?
Контент-ферма может думать:
Сделаем сто штук и посмотрим, что платформа разгонит.
Условный пример, именно условный:
1000 человеческих видео
×
20% прошли первичный отбор
=
200

1 000 000 дешёвых AI-видео
×
0,1% прошли отбор
=
1000
Второй производитель может быть в 200 раз хуже в среднем и всё равно дать платформе больше «победителей».
Не потому, что алгоритм любит AI slop.
Потому что количество попыток имеет значение.
Получается что-то вроде естественного отбора контента:
сгенерировали 100 вариантов
↓
платформа показала их аудиториям
↓
большинство умерло
↓
несколько удержали внимание
↓
им дали больше показов
Автору даже необязательно понимать, почему конкретно один ролик с ИИ-котом, пожарным грузовиком и четырьмя Папами Римскими внезапно оказался победителем.
Отбор частично делает сама рекомендательная система.
Я для себя называю это алгоритмической селекцией slop. Это моя интерпретация, не термин TikTok или YouTube.
Slop может быть везде и одновременно никому особенно не нравиться
Есть довольно забавное подтверждение этого парадокса.
В свежем working paper 2026 года исследователи изучили YouTube и провели отдельный контролируемый эксперимент. Когда у видео становилось явно известно AI-происхождение, просмотры в среднем снижались примерно на 10%. Эффект обнаружился и у коротких, и у длинных видео, особенно у небольших каналов. Работа пока опубликована как SSRN working paper, так что относиться к числу стоит соответствующе.
То есть вполне возможна ситуация:
пользователь:
"терпеть не могу AI slop"

его For You:
AI
AI
AI
AI
AI
И здесь нет логического противоречия.
Популярность способа производства не равна любви аудитории к результату.
Почему AI-контент вызывает такое отторжение
Мне сначала казалось, что здесь много обычного технологического снобизма.
В духе:
Раньше фотографы боялись Photoshop, теперь все боятся Midjourney.
Наверняка такой компонент существует.
Но опросы показывают, что отношение людей немного сложнее.
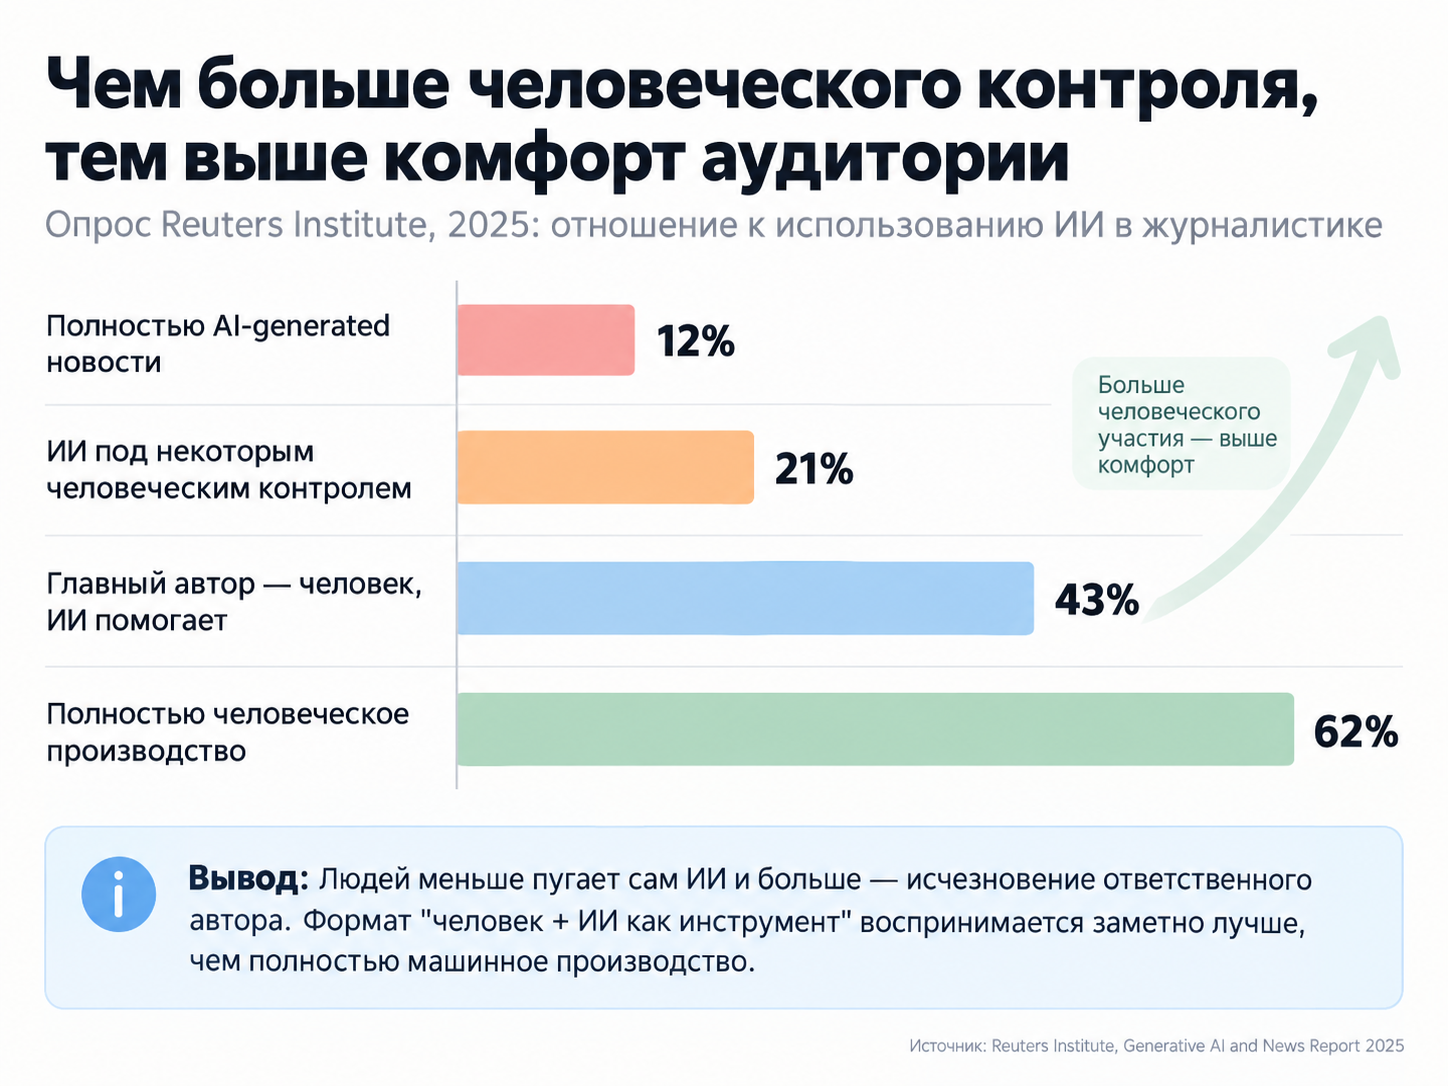
Reuters Institute в 2025 году исследовал отношение людей к генеративному ИИ в журналистике в шести странах.
Полностью AI-generated новости комфортны только 12% опрошенных.
Если ИИ работает под некоторым человеческим контролем, уже 21%.
Если главным остаётся человек, а ИИ только помогает, комфорт вырастает до 43%.
Полностью человеческое производство: 62%.
То есть шкала выглядит почти идеально:
Причём к техническим задачам отношение намного спокойнее: AI для исправления орфографии устраивает 55%, для перевода 53%.
Это сильно меняет картину.
Похоже, многих раздражает не сам факт вычислений на GPU.
Раздражает исчезновение ответственного автора.
YouGov получил похожие результаты в Великобритании. Только 26% взрослых заявили, что готовы взаимодействовать с контентом, если знают, что он создан или совместно создан ИИ; 53% сказали, что не готовы. Среди главных опасений были аутентичность, 67%; возможность вводить в заблуждение, 62%; качество, 51%. А 91% считают, что AI-generated контент должен явно маркироваться. Выборка составляла 2035 взрослых.
Ipsos/Viral Nation в другом исследовании получил ещё одну интересную цифру: 72% потребителей сказали, что аутентичность важна для решения, подписываться ли на автора.
На этом фоне общая тревога вокруг технологии тоже растёт. В июне 2026 года 52% американцев отвечали Pew, что рост использования AI вызывает у них больше беспокойства, чем энтузиазма. Больше энтузиазма, чем беспокойства, испытывали всего 9%. В 2021 году обеспокоенных было 37%.
Это уже сложно списать только на «люди боятся нового».
Забавно, но платформы постепенно приходят примерно к тому же определению проблемы
Google не объявляет войну AI-контенту.
Он объявляет войну масштабному производству бесполезного контента ради поисковой выдачи.
В 2024 году компания обновила spam policies и прямо сформулировала scaled content abuse так, чтобы не иметь значения, кем произведён мусор: моделью, человеком или их комбинацией.
После rollout Google сообщил о 45% снижении низкокачественного и неоригинального контента в Search по сравнению с исходным уровнем.
YouTube в июле 2025 года переименовал политику repetitious content в inauthentic content и отдельно уточнил, что массовый и повторяющийся контент не подходит для монетизации.
При этом YouTube специально пояснил авторам: само использование ИИ нарушением не является. AI можно использовать для storytelling, если контент остаётся оригинальным и соответствует правилам.
То есть:
AI → OK

массовый шаблонный мусор → проблема
TikTok летом 2026 года пошёл ещё прямее: компания объявила тестирование систем для обнаружения аккаунтов, специально публикующих AI-generated spam, который вытесняет оригинальных авторов. К этому моменту TikTok утверждал, что маркировка AIGC была применена уже более чем к 3 миллиардам видео через сочетание creator labels, C2PA и invisible watermarking.
Pinterest вводит AI labels и позволяет пользователю выбрать see fewer AI Pins в отдельных категориях.
В ЕС с 2 августа 2026 года начал применяться Article 50 AI Act с требованиями прозрачности для ряда синтетических материалов. Особенно интересна деталь для текста общественного интереса: требование disclosure имеет исключение, если материал прошёл человеческую редакционную проверку и за публикацию отвечает физическое или юридическое лицо.
Получается, платформы и регуляторы постепенно сходятся не на:
ИИ запрещён.
А примерно на:
Масштабный мусор понижаем, происхождение обозначаем, а ответственность должен нести кто-то живой.
Тогда зачем вообще всё это использовать?
На этом месте можно решить, что самый надёжный способ борьбы с AI slop заключается в удалении всех LLM и возвращении к Блокноту.
Но исследования производительности делают такую позицию довольно неудобной.
В эксперименте, опубликованном в Science, 453 специалиста выполняли профессиональные письменные задачи. У группы с ChatGPT среднее время выполнения снизилось на 40%, а качество по внешней оценке выросло на 18%. Особенно сильно выиграли участники с более слабым исходным результатом.
В исследовании 5179 сотрудников customer support AI-assistant повысил количество решённых вопросов в час в среднем на 14%. Для новичков и менее квалифицированных сотрудников рост составил 34%.
В эксперименте с 758 консультантами BCG на задачах внутри возможностей модели участники с GPT-4 выполняли на 12,2% больше задач, работали примерно на 25% быстрее и выдавали существенно более высокое качество. При этом исследователи специально показали обратную сторону: на задаче за пределами возможностей модели AI мог ухудшать результат.
А в полевом эксперименте на 7137 knowledge workers из 66 компаний активные пользователи встроенного AI-инструмента стали тратить примерно на два часа в неделю меньше на email.
То есть отрицать полезность генеративного ИИ становится примерно так же сложно, как отрицать полезность компилятора, потому что плохие программисты тоже им пользуются.
Вопрос скорее в том, куда отправится высвободившееся время.
Вариант A:
раньше:
1 статья в неделю

теперь:
20 статей в неделю
Вариант B:
раньше:
8 часов на черновик
2 часа на проверку

теперь:
2 часа на черновик
8 часов на исследование,
проверку и редактуру
Один и тот же прирост производительности может создать либо content farm, либо более тщательно сделанную работу.
И вот здесь я снова вернулся к StoryOps
Первоначальная идея была довольно простой.
Мне хотелось систему, которой я скажу:
Хочу написать новую статью про проект.
А она сама вспомнит предыдущие публикации, посмотрит Git и поможет продолжить историю.
В первой версии pipeline стал выглядеть примерно так:
прошлые статьи автора
        +
текущий репозиторий
        +
тренды площадки
        ↓
narrative gap
        ↓
canonical story
        ↓
evidence
        ↓
platform brief
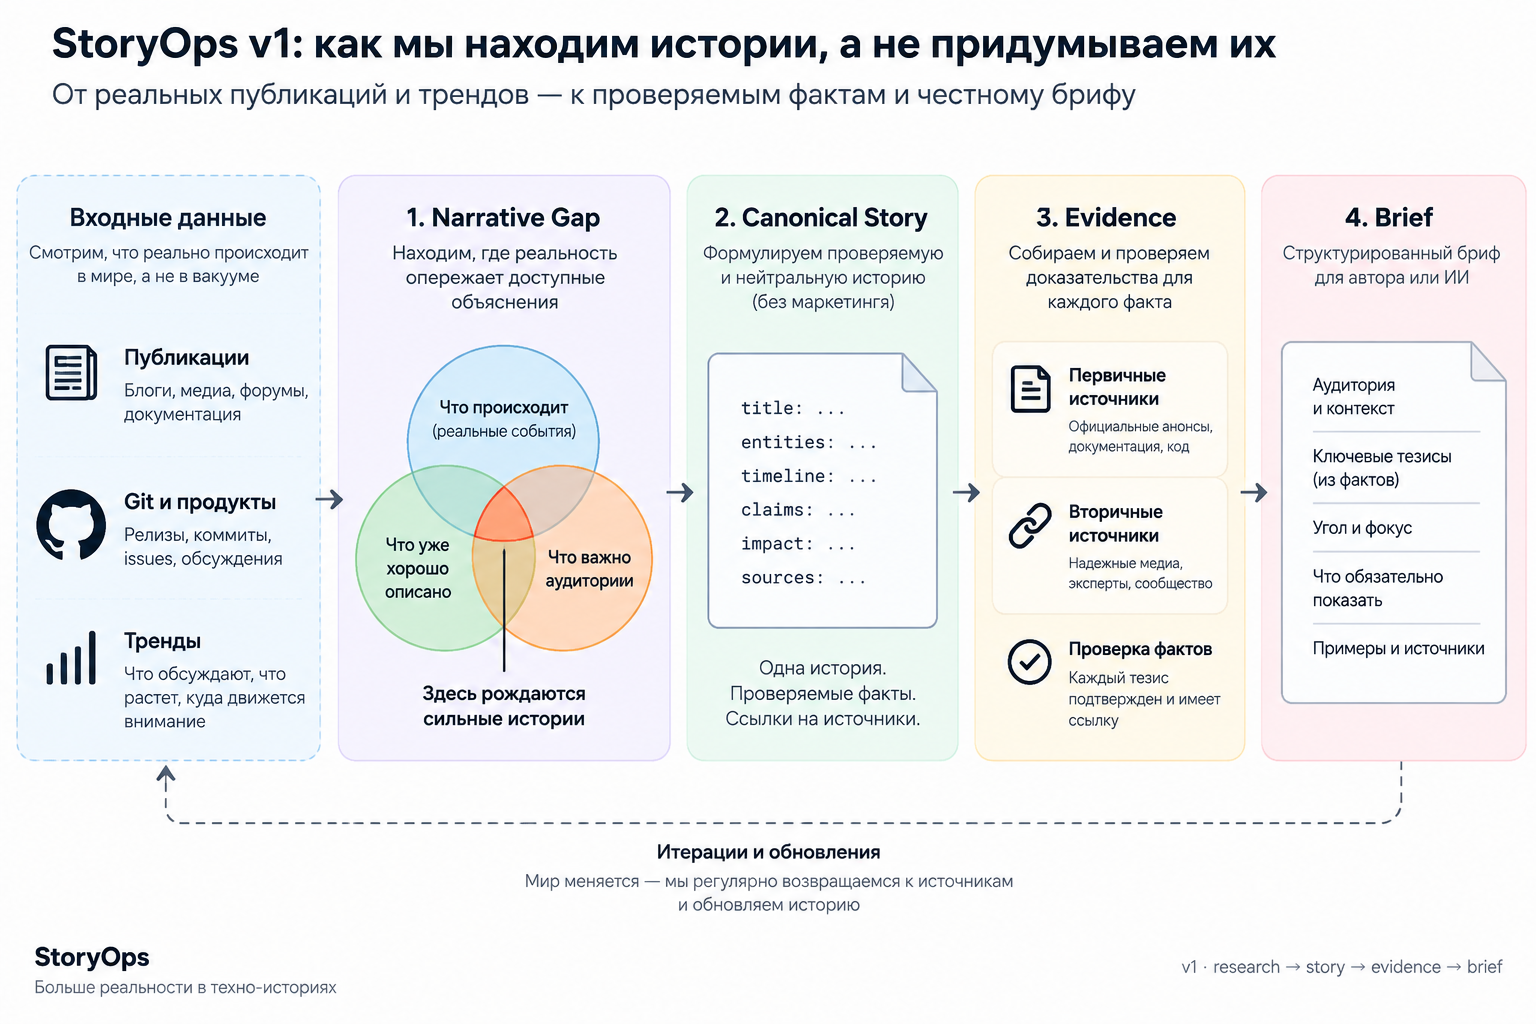
Например, для одной реальной статьи StoryOps прошёл мои предыдущие публикации, исследовал репозиторий и отдельно проанализировал 171 свежую статью Хабра.
Но важнее оказалось другое.
В тестовом исследовании Veynrel система оставила поле measurements пустым, потому что в проекте не было данных, подтверждающих пользовательский эффект. Synthetic fixtures и количество тестов она специально не превратила в «наш продукт стал полезнее». А результаты анализа Хабра сохранила как слабые подсказки для упаковки, а не как доказательство того, что тема уникальна или обязательно станет популярной.
Это мелочь с точки зрения генерации текста.
Но именно такие мелочи внезапно показались мне важнее самой генерации.
Потом обнаружилась ещё одна проблема.
Canonical story получался фактически правильным, но сухим.
Если просто дать его LLM и сказать «теперь напиши статью», получается та самая знакомая гладкая масса:
В данной статье рассмотрим архитектуру системы…
Технически правильно.
Читать хочется примерно никогда.
Поэтому в StoryOps появился следующий слой:
canonical story
↓
author input
↓
pattern transfer
↓
style preset
↓
editorial direction
↓
voice plan
↓
draft
↓
audit
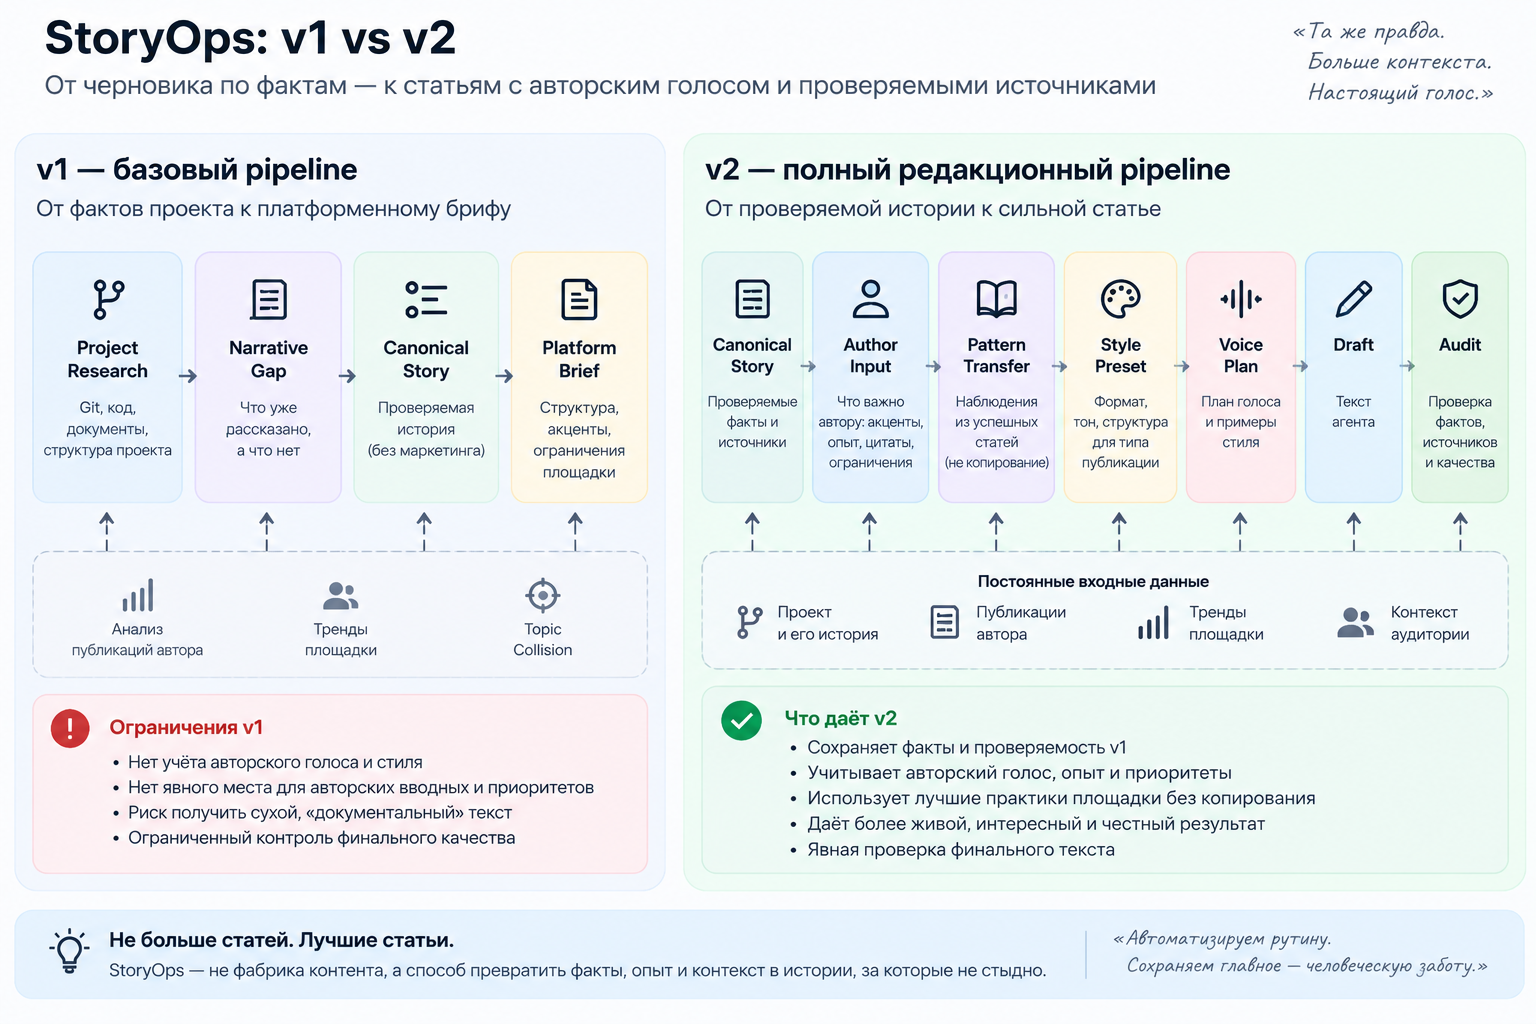
Автор может буквально бросить туда:
Вот здесь хочу рассказать, как сначала сделал всё глупо.
или:
Эту фразу хочу оставить почти без изменений.
или:
Тут можно пошутить.
А агент уже должен встроить это в фактическую историю, не имея права придумывать за автора мотивацию.
Отдельно мне захотелось заставить систему смотреть популярные материалы площадки. Но тоже не в формате:
Вот успешная статья. Сделай такую же.
А так:
наблюдение
↓
абстрактный паттерн
↓
решение применить или не применить
↓
конкретное место в нашей статье
Если исследования показывают, что сильные технические статьи быстро выходят на инженерный конфликт, StoryOps может предложить открыть текст конкретным багом.
Но он не должен брать чужой заголовок и менять в нём два существительных.
Получился немного странный продукт
Обычно смысл автоматизации в том, чтобы убрать трение.
Я сделал систему, которая часть трения специально возвращает.
Перед публикацией нужно:
-
найти реальные изменения;
-
подтвердить тезисы evidence;
-
отделить факт от авторской интерпретации;
-
посмотреть, что автор уже рассказывал;
-
решить, какие тренды площадки вообще имеют смысл применять;
-
дать автору добавить свои мысли;
-
проверить финальный текст.
С точки зрения максимального throughput это ужасный дизайн.
Можно было написать:
for repo in repos:
    article = llm(repo)
    publish(article)
И закрыть проект за вечер.
Но чем больше я смотрел на исследования slop, тем сильнее мне казалось, что throughput вообще не та метрика, которую хочется максимизировать.
Где настоящая опасность?
Самый очевидный ответ: misinformation.
Но мне больше интересна другая проблема.
Генерация стала дешёвой. Проверка всё ещё дорогая.
Если отправителю раньше приходилось потратить час, чтобы произвести текст, а читателю пять минут, чтобы понять его качество, экономика была относительно симметричной.
Теперь автор может сгенерировать тысячу убедительно выглядящих текстов почти бесплатно.
А читателю всё равно надо:
-
прочитать;
-
проверить источник;
-
понять контекст;
-
заметить ошибку.
Экономию производителя оплачивает потребитель своим вниманием.
Получается классический spam problem, только spam научился разговаривать нормальным языком.
Есть и более технический долгосрочный риск.
В работе в Nature исследователи показали model collapse: при последовательном обучении моделей на данных, произведённых предыдущими моделями, без достаточного сохранения исходных данных начинают теряться редкие части исходного распределения. Авторы отдельно подчёркивают растущую ценность оригинальных human-produced data.
Это не означает:
ещё два года AI slop, и GPT превратится в тыкву.
Исследование говорит о конкретных режимах training pipeline.
Но сама проблема происхождения данных становится реальной.
Если интернет всё больше состоит из переработки переработки переработки, то вопрос «где здесь вообще первоначальное наблюдение человека?» становится техническим, а не только философским.
Может быть, противоположность slop вообще не называется human-made
После всего этого я перестал считать полезным спор:
AI-art против настоящего искусства.
или:
AI-текст против человеческого текста.
Потому что можно сделать великолепный материал при помощи ИИ.
И можно вручную произвести совершенно бессмысленный SEO-мусор.
Исследование JMIR, с которого я начинал, предлагает смотреть на slop через human care in production. Мне эта формулировка нравится всё больше.
Для себя я сейчас рисую границу примерно так.
Если ИИ:
-
помогает исследовать;
-
ищет противоречия;
-
собирает черновик;
-
предлагает структуру;
-
автоматизирует рутину;
но при этом человек:
-
выбирает, что вообще стоит говорить;
-
отвечает за источники;
-
проверяет утверждения;
-
добавляет собственный опыт;
-
решает, что удалить;
-
готов поставить под текстом своё имя,
то мне сложно назвать результат slop только из-за присутствия LLM.
А вот когда человек исчезает из процесса почти полностью, а остаётся:
Generate
↓
Publish
↓
Generate
↓
Publish
↓
Generate
↓
Publish
тогда мы получаем именно тот экономический механизм, из-за которого slop так хорошо масштабируется.
Ирония в том, что эту статью тоже помог написать ИИ
Что, конечно, немного портит красивый финал.
Часть исследований для неё я собирал при помощи AI-инструментов.
StoryOps тоже построен вокруг AI-агентов.
Черновики, формулировки и структура проходили через LLM.
По самому примитивному критерию эта статья автоматически подозрительна.
Но мне кажется, в этом и есть самый интересный эксперимент.
Можно использовать генеративную модель, чтобы уменьшить человеческое участие.
А можно использовать её так, чтобы освободить время для тех частей работы, где человеческое участие действительно важно.
И поэтому главный вопрос для меня теперь звучит не:
Использовался ли здесь AI?
А:
Есть ли здесь человек, которому действительно не всё равно, что получилось, и который готов за это отвечать?
Возможно, именно это и есть более полезная граница.
Не между человеком и машиной.
А между созданием и производством контента.
Источники
-
American Dialect Society — 2025 Word of the Year Is “Slop”
https://americandialect.org/2025-word-of-the-year-is-slop/ -
Pew Research Center — How much of the internet is written with AI?
https://www.pewresearch.org/data-labs/2026/08/20/how-much-of-the-internet-is-written-with-ai/ -
Graphite — AI now writes as many online articles as humans do
https://graphite.io/five-percent/research/ai-now-writes-as-many-online-articles-as-humans-do -
Ahrefs — AI content research
https://ahrefs.com/blog/how-to-detect-ai-generated-content/ -
Graphite — AI content in search and LLMs
https://graphite.io/five-percent/research/ai-content-in-search-and-llms -
Kapwing — The TikTok AI Slop Report
https://www.kapwing.com/resources/the-tiktok-ai-slop-report/ -
JMIR Medical Education — AI slop in biomedical social video
https://mededu.jmir.org/2025/1/e80084 -
TikTok — How TikTok recommends videos #ForYou
https://newsroom.tiktok.com/how-tiktok-recommends-videos-for-you -
YouTube Help — recommendation and performance signals
https://support.google.com/youtube/answer/16089387 -
Reuters Institute — Generative AI and News Report 2025
https://reutersinstitute.politics.ox.ac.uk/generative-ai-and-news-report-2025-how-people-think-about-ais-role-journalism-and-society -
YouGov — UK audience attitudes toward AI-generated content
https://yougov.co.uk/ -
Ipsos/Viral Nation — creator authenticity research
https://www.ipsos.com/en-ca/seven-10-consumers-require-creator-authenticity-hitting-follow -
Google — March 2024 Search update
https://blog.google/products-and-platforms/products/search/google-search-update-march-2024/ -
YouTube Help — monetisation / inauthentic content policy
https://support.google.com/youtube/answer/1311392 -
TikTok Newsroom — AI-generated content transparency and spam measures
https://newsroom.tiktok.com/ -
Pinterest Newsroom — GenAI labels
https://newsroom.pinterest.com/news/introducing-gen-ai-labels/ -
European Commission — Article 50 AI Act transparency obligations
https://digital-strategy.ec.europa.eu/en/faqs/transparency-obligations-under-article-50-ai-act -
Science — Experimental evidence on the productivity effects of generative artificial intelligence
https://doi.org/10.1126/science.adh2586 -
NBER — Generative AI at Work
https://www.nber.org/papers/w31161 -
Harvard/BCG — Navigating the Jagged Technological Frontier
https://aiinstitute.hbs.edu/navigating-the-jagged-technological-frontier/ -
NBER — generative AI and knowledge work field experiment
https://www.nber.org/papers/w33795 -
Nature — AI models collapse when trained on recursively generated data
https://www.nature.com/articles/s41586-024-07566-y -
SSRN working paper — disclosure and AI-generated YouTube content
https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6885980
Автор: Ziverpup

