


В этой статье хочу рассказать, как мы добивались настоящей отказоустойчивости для платформы, растянутой на несколько датацентров, с какими проблемами столкнулись по дороге и какие инструменты нам пришлось для этого написать.
Многие знают нас как разработчиков Cozystack. Но помимо него в Ænix мы разрабатываем платформу для запуска публичного облака под ключ: с биллингом, проектами, self-service, поддержкой разных бэкендов, включая тот же Cozystack, и интеграциями с внешними системами.
Эта платформа целиком построена на Kubernetes, причём в самом буквальном смысле. Её бэкенд реализован на Kubernetes API Aggregation Layer и controller-runtime, собственные ресурсы хранятся в etcd-кластерах под управлением нашего etcd-operator, а единственная реляционная база данных — Postgres для Keycloak — работает под управлением CNPG-оператора (CloudNativePG). Своего хранилища состояния, своего механизма выбора лидера и своей репликации у платформы нет: всё это она получает от Kubernetes.
Архитектура Kubernetes позволила нам достичь элегантной схемы, где нам не требуется даже реплицируемое хранилище. Никакого DRBD, Ceph или синхронизации дисков между площадками: каждый член etcd и каждая реплика Postgres живут на своём локальном томе, а данные между площадками переносят сами etcd и Postgres своими механизмами репликации. Им в любом случае приходится договариваться о том, какая копия главная, и делать то же самое ещё раз уровнем ниже было бы лишним. К тому же блочная репликация между городами добавляла бы задержку к каждой записи и ещё один слой, который пришлось бы отдельно учить переживать разрыв связи.
Такой дизайн мы выбрали не случайно. Kubernetes с самого начала проектировался с расчётом на отказоустойчивость: декларативное состояние хранится в etcd с кворумом, контроллеры приводят систему к нему после любого сбоя, всё, что должно работать в одном экземпляре, использует leader election, а пробы убирают трафик с больных подов. Если построить весь бэкенд на этих механизмах, отказоустойчивость платформы в теории достаётся почти бесплатно.
Забегая вперёд скажу, что на практике Kubernetes оказался готов к этому куда меньше, чем принято считать, и многое нам пришлось достраивать самим.
Исходные данные
Проверять теорию пришлось на одной из реальных инсталляций. Система готова к нагрузке до 10 000 одновременных пользователей, а требование к отказоустойчивости звучало просто: потеря любой площадки или связи между любыми двумя площадками не должна класть платформу.
-
Два датацентра в разных городах, в которых живёт вся нагрузка, и третья площадка с единственной нодой — witness. Площадки связаны по L3, общего L2 между ними нет.
-
Задержка от основных площадок до witness около 23 и 43 мс, внутри площадки — доли миллисекунды.
-
Канал между датацентрами — 100 Мбит/с. Он довольно узкий, поэтому гонять через него лишний трафик нельзя, и это ещё одна причина держать запросы внутри своей зоны везде, где это возможно.
-
Talos Linux, Cilium с VXLAN-туннелями и kube-proxy replacement.
-
По одной control-plane ноде в каждом датацентре и на witness, etcd запущен средствами Talos. Члены etcd-кластеров платформы тоже разложены по трём зонам.
Самыми поучительными оказались тесты на сетевые отказы и потерю площадки. Почти каждый такой прогон заканчивался одинаково: все поды Ready, все пробы зелёные, а сервис не работает.
Дальше я по порядку разберу, что ломалось на каждом уровне — в сети между площадками, в доступе к Kubernetes API и в самом etcd, — и как мы это чинили. Попутно расскажу о трёх небольших проектах, которые из этой работы выросли:
-
extractedprism — локальный балансировщик до Kubernetes API на каждой ноде, сделанный по мотивам Talos KubePrism. Он не зависит от discovery и умеет уводить kubelet с apiserver, потерявшего кворум;
-
threek — агент, который держит лидера etcd на той площадке, откуда видно всех;
-
twok — исследование о том, как жить с etcd на двух площадках и внешним арбитром вместо третьего члена.
Зачем нужен witness
Изначально у нас было только два датацентра, но для отказоустойчивости понадобился третий. Объясню почему. etcd, а вместе с ним и весь Kubernetes, работает до тех пор, пока жив кворум — строгое большинство голосующих членов. Если датацентров всего два, большинство неизбежно оказывается в одном из них. Положим два члена в первый ДЦ и один во второй — тогда потеря первого уносит кворум. Разделим поровну — кворум теряется при отказе любого из них, а при разрыве связи между ними писать не может ни одна сторона. Как ни раскладывай, один из датацентров оказывается тем, без которого кластер не живёт.
Третий голос на отдельной площадке эту симметрию ломает: при потере любого датацентра или связи между ними у одной из сторон остаётся два голоса из трёх. Строить ради этого полноценный третий датацентр не нужно. На witness нет рабочей нагрузки, там стоит одна control-plane нода с членом etcd и apiserver, и её задача — голосовать.
Бесплатным такой подход, правда, не назовёшь. Witness — полноправный член Raft и участвует в подтверждении каждой записи, поэтому задержка до него напрямую влияет на скорость etcd.
Латентность против доступности
Первое, во что упираешься, растягивая кластер по городам, это даже не отказоустойчивость, а скорость. Каждый хоп между площадками стоит десятки миллисекунд, а сервисы в Kubernetes по умолчанию балансируют трафик на все эндпоинты одинаково. Цепочка из контроллера, агрегированного API и SubjectAccessReview легко набирает несколько межзональных хопов на один запрос.
Первый интересный случай был связан с сервисом kubernetes в неймспейсе default. В него ходят буквально все в кластере: контроллеры, операторы, любой под, которому нужен Kubernetes API. Эндпоинты для этого сервиса публикуют сами apiserver’ы, каждый добавляет туда свой адрес. А witness стоит дальше остальных, поэтому запросы, которые попадали на его apiserver, отвечали заметно дольше. Чтобы этого избежать, мы добавили apiserver’у на witness флаг --endpoint-reconciler-type=none. С ним он перестаёт публиковать свой эндпоинт в сервис kubernetes, и клиенты кластера на него больше не попадают, но при этом witness продолжает работать как полноценный член etcd и голосовать в кворуме.
Но это решало проблему только для одного сервиса и одной площадки. На остальных своих сервисах мы проставили trafficDistribution: PreferClose. Поле trafficDistribution вместе со значением PreferClose стало GA в Kubernetes 1.33, а на кластере без зон оно безопасно деградирует до обычного поведения:
apiVersion: v1
kind: Service
spec:
  trafficDistribution: PreferClose
В Kubernetes 1.33 добавлено значение
PreferSameZone— синонимPreferClose; в 1.35 оно стало GA, аPreferCloseобъявлено устаревшим. Cilium 1.19.5 поддерживает толькоPreferClose(и аннотациюservice.kubernetes.io/topology-mode). СPreferSameZoneзональная маршрутизация в нём не работает.
С etcd так не получится. Каждый commit и каждое линеаризуемое чтение должны подтвердить большинство членов, и если члены стоят в разных зонах, каждая такая операция платит межзональный RTT. Настройкой сервиса это не обойти. Тем не менее мы разнесли члены etcd по одному на зону, а apiserver каждого кластера мягко притягиваем к зоне его etcd. На тестовом кластере чтение из etcd при этом занимало 139–166 мс. Можно было бы держать все три члена в одной зоне: тогда etcd работает быстро, но при потере этой зоны пропадает целиком.
Иллюзия Ready
Самым неприятным оказался не тот сценарий, в котором площадка умирает целиком, а тот, где отказ частичный. Суть теста такая: мы рвём связь между двумя датацентрами, но обе стороны продолжают видеть witness, а он видит обе. Все площадки и все члены etcd живы, кворум формально есть, просто связи «каждый с каждым» больше нет.
Полная потеря площадки отрабатывает штатно: два оставшихся члена переизбирают лидера, и кластер живёт дальше. А вот при частичной недоступности кластер вставал колом. @sir_cthulhu, который проводил тесты, описал картину так: «линеаризованное чтение тормозит, запись либо тормозит, либо не работает, а API-сервера при этом отчитываются, что у них все хорошо».
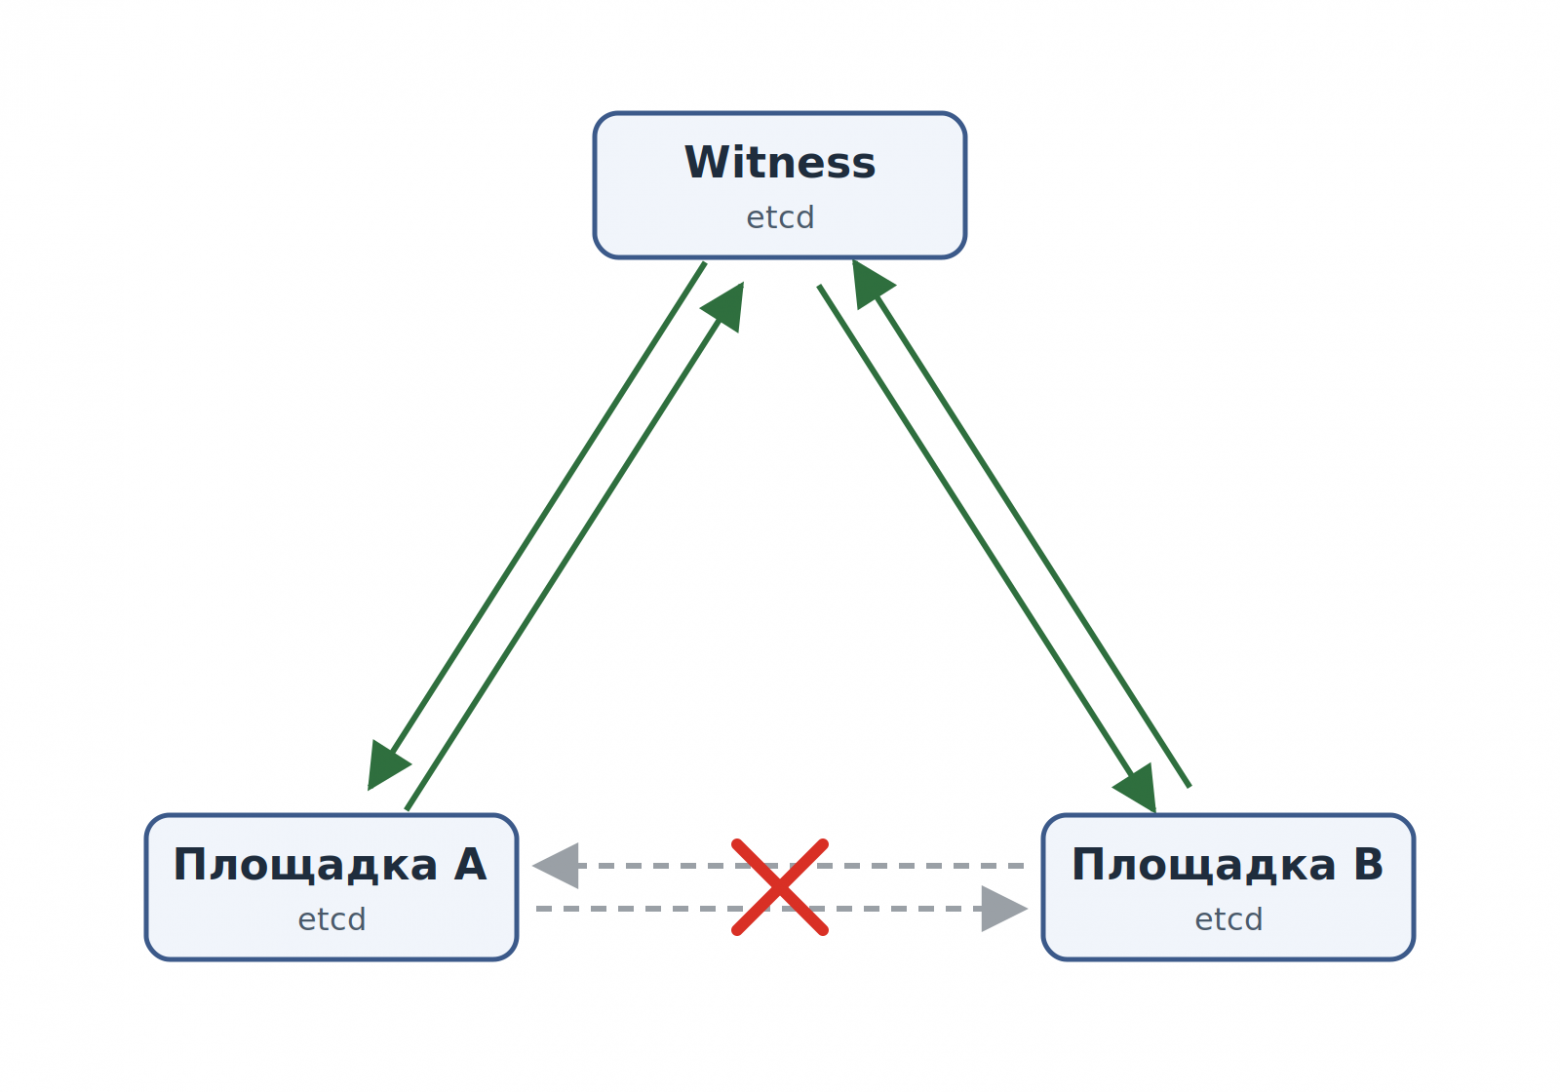
Kubernetes здесь, в общем-то, не врёт. Readiness-проба отвечает на вопрос, жив ли процесс и отвечает ли он локально, но не на вопрос, может ли он прямо сейчас обслужить запрос через частично разорванную сеть. Под, который принимает TCP-соединения, но висит на каждом запросе, остаётся в эндпоинтах, и трафик продолжает на него идти.
Самый наглядный пример — логи. VictoriaLogs шардирует логи по узлам vlstorage без реплик, и каждый запрос уходит на все узлы сразу. Если один из узлов оказался по ту сторону разрыва, vlselect ждёт его до дедлайна запроса в 30 секунд и обрывает запрос целиком. В итоге во время разрыва пользователь видел не половину логов, а ни одного. Флаг -search.allowPartialResponse здесь не спасает: он срабатывает, только когда узел вернул ошибку, а таймаут подключения зашит в те же 30 секунд, и по уже открытому keep-alive соединению ошибка не приходит вовсе. Все поды при этом Ready.
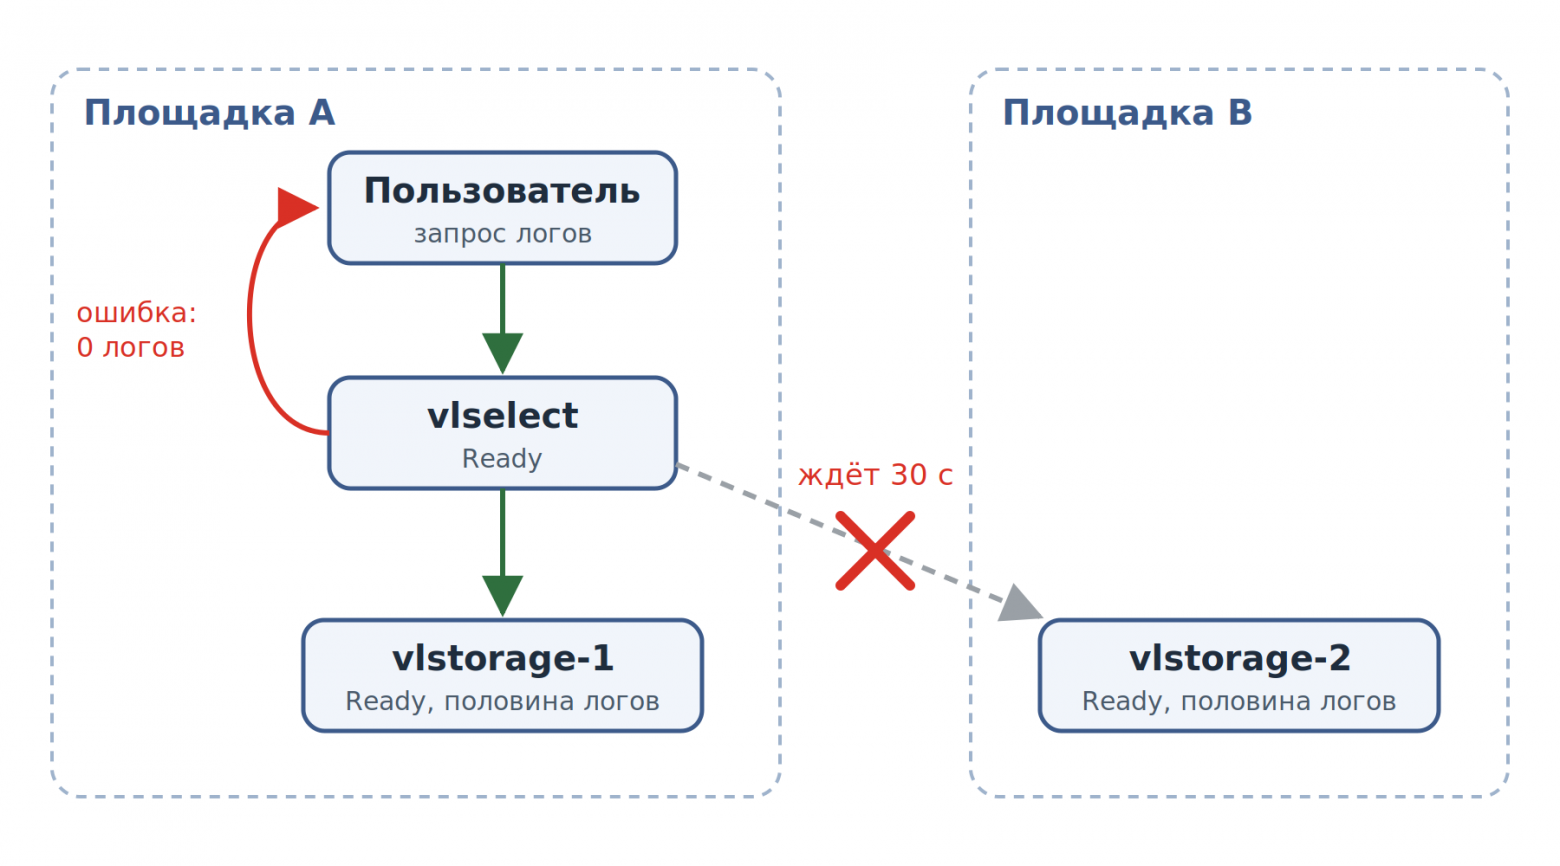
Решением стала схема, которую для HA рекомендует сама VictoriaLogs: полная копия логов в каждой зоне, отдельный кластер на зону, коллектор пишет во все, а читатели ходят в vlselect своей зоны через сервис с PreferClose. Платить за это приходится двойным объёмом хранения. Зато по замеру на проде запрос, который до правки висел 30 секунд и обрывался, стал отвечать меньше чем за секунду.
В итоге почти вся наша работа свелась к одной задаче: добиться того, чтобы Ready снова означало «работает», и чтобы трафик не уходил туда, где его не смогут обслужить.
Сеть
Gateway, который не знает про зоны
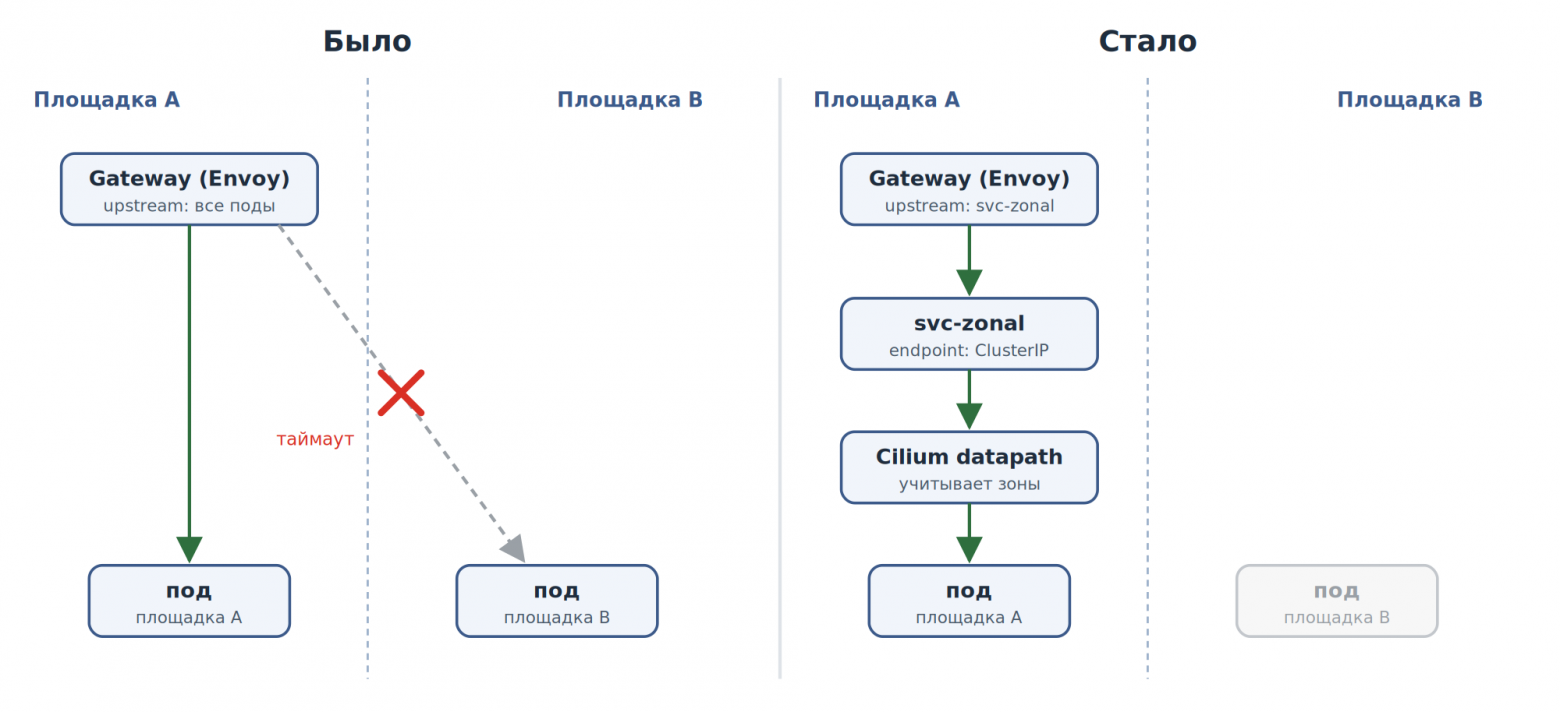
Главным сюрпризом в сети оказался Gateway API в Cilium. Envoy строит upstream из эндпоинтов всех зон и PreferClose не учитывает (cilium/cilium#48738, #48134). При одностороннем блоке VXLAN между зонами примерно половина запросов через каждую точку входа уходила в таймаут.
Обошли это так: рядом с каждым сервисом создаётся сервис <svc>-zonal без селектора, единственным эндпоинтом которого служит ClusterIP настоящего сервиса. Envoy видит один адрес, а конкретный под выбирает уже datapath Cilium, который зоны учитывает. На стенде после этого проходили все запросы. Минус тоже есть: под выбирается на соединение, а не на запрос, поэтому outlier detection и ретраи Envoy теряют смысл.
Доступ к Kubernetes API
Здесь проблем оказалось больше всего. К Kubernetes API на ноде ходят двумя путями: kubelet и всё, что живёт на хосте, — через локальный балансировщик, а поды — через сервис kubernetes в неймспейсе default, тот самый 10.96.0.1. Проблемы обнаружились на обоих.
KubePrism и extractedprism
В Talos есть KubePrism — локальный TCP-балансировщик на localhost:7445, который раскидывает соединения kubelet по всем control-plane нодам. Список бэкендов он собирает из внешнего endpoint кластера, указанного в machine config, и из адресов control-plane нод, которые узнаёт через Talos discovery.
На практике же KubePrism на воркерах знал ровно один адрес — внешний endpoint кластера, и при изоляции площадки, где этот адрес находился, ноды на стороне большинства уходили в NotReady.
Когда мы стали разбираться, почему так, картина получилась следующая. У discovery два реестра. Kubernetes-реестр устроен просто: ноды хранят данные о себе в аннотациях объектов Node и оттуда же узнают друг о друге. Но начиная с Kubernetes 1.32 feature gate AuthorizeNodeWithSelectors ужесточил доступ нод к чужим объектам Node, и этот реестр перестал нормально работать. Официальная документация Talos прямо называет его устаревшим и не рекомендует отключать feature gate, так как это убирает и другие важные защиты, а взамен предлагает сервисный реестр. Это внешний discovery-сервис, через который ноды обмениваются информацией друг о друге: публичный инстанс держит Sidero Labs, а собственный можно поднять только под коммерческой лицензией. Нам он не подходил: по требованиям заказчика кластер не может зависеть от внешних сервисов, тем более проприетарных. Так что discovery у нас не работал вовсе, и KubePrism оставалось довольствоваться одним адресом из machine config.
Мы заменили KubePrism на extractedprism. Это проект нашего коллеги @lexfrei, который он сделал, вдохновившись KubePrism в Talos. В отличие от KubePrism, extractedprism позволяет задать список эндпоинтов статически, поэтому от discovery он не зависит. Мы развернули его static pod’ом на всех нодах кластера и прописали в нём все apiserver. Но тут же столкнулись со следующей проблемой: extractedprism, как и KubePrism, выбирал upstream с минимальным временем TCP connect. А локальный apiserver без кворума принимает TCP-соединения отлично, причём быстрее любого удалённого. В результате балансировщик честно выбирал самый быстрый бэкенд, который не работает.
Сначала мы переключили выбор на случайный, но это было скорее смягчение, чем решение. Решением стала проверка /readyz вместо TCP, которую добавили прямо в extractedprism (lexfrei/extractedprism#199 и #200). Анонимный /readyz у нас выключен, поэтому балансировщик ходит с клиентским сертификатом kubelet. Проба выполняется раз в 5 секунд с таймаутом 3 секунды, и по расчёту kubelet уходит с неготового apiserver примерно за 15 секунд. Проверяли на стейдже в четырёх сценариях разрыва: воркеры отрезанной стороны оставались Ready.
Сервис kubernetes и его эндпоинты
С 10.96.0.1 история интереснее. Казалось бы, достаточно поставить на сервис PreferClose, и поды пойдут в apiserver своей зоны. Мы так и сделали. Apiserver поле не откатывает, но и толку от него нет: EndpointSlice для этого сервиса пишет сам kube-apiserver. Его lease endpoint reconciler переписывает слайс каждые несколько секунд и пишет его без информации о топологии, так что топологию, добавленную руками, он стирал за 2–4 секунды.
Поэтому мы забрали эту работу у apiserver. Флаг --endpoint-reconciler-type=none теперь стоит на всех apiserver, а не только на witness, и сами они в сервис kubernetes больше ничего не пишут. Вместо них на каждой control-plane ноде работает небольшой DaemonSet apiserver-endpoints. Раз в 5 секунд он проверяет /readyz своего apiserver и публикует для него отдельный EndpointSlice kubernetes-<node> с топологией своей зоны.
Проверяет он только свой apiserver, через localhost. Если проверять соседей по сети, при разрыве не понять, сломался apiserver или до него просто не достучаться, а ошибка в EndpointSlice бьёт сразу по всему кластеру. В API сам DaemonSet ходит через локальный балансировщик на localhost:7445, а не через сервис kubernetes, который он же и наполняет.
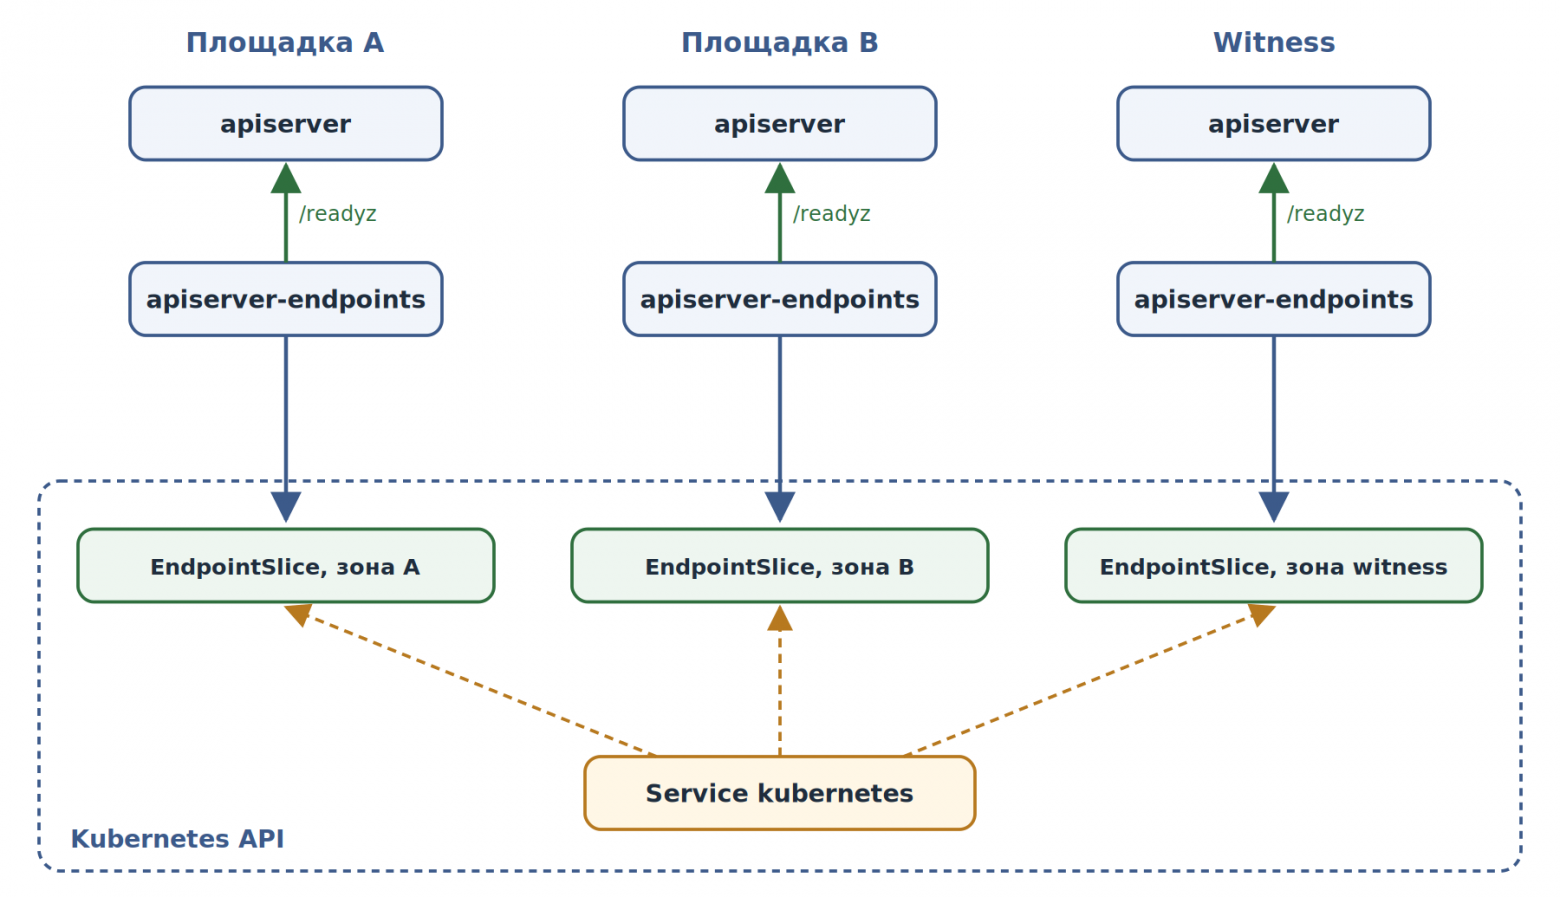
Дальше выяснились ещё два нюанса, и оба хорошо показывают, что в распределённой системе «готово» почти никогда не значит «готово».
Осиротевшая зона
Когда сторона без кворума теряет свой apiserver, топологии для её зоны больше нет, и Cilium начинает раскидывать её поды по всем готовым бэкендам, включая недоступную площадку. На стейдже это давало потерю около половины проб к 10.96.0.1 и около десятка рестартов подов за прогон. Поэтому теперь осиротевшую зону подхватывает witness.
Однако первая версия этого фолбэка на практике не помогала. Причина нашлась в коде Cilium 1.19 (DefaultSelectBackends): топология учитывается только до тех пор, пока она указана у каждого бэкенда, включая неготовые. Один неготовый эндпоинт без топологии выключал зональную фильтрацию для всего сервиса. Теперь неготовый эндпоинт сохраняет топологию своей зоны, а witness забирает зону с первого же раунда. Остаточное окно по расчёту составляет один интервал публикации (5 секунд) плюс время, за которое Cilium подхватит изменения.
Talos, который читал этот слайс
Отключение reconciler задело то, о чём мы не подумали. Talos берёт адреса trustd из EndpointSlice со строго заданным именем kubernetes. Слайс с таким именем больше никто не обновлял, и на продовых воркерах перестали обновляться сертификаты apid, так что talosctl перестал до них дотягиваться. На стейдже всё работало исключительно по счастливой случайности: Talos держит последние адреса в памяти до ребута. Теперь публикаторы пишут и слайс kubernetes со всеми адресами, но спрятанный от datapath: без метки kubernetes.io/service-name его игнорирует kube-proxy, а с меткой service.kubernetes.io/service-proxy-name на него не смотрит Cilium.
Как apiserver ходит в etcd
Ещё одна мелочь, которая стоила нам нескольких итераций. Стандартная практика — отдать apiserver’у сразу несколько эндпоинтов etcd или одно DNS-имя, которое резолвится в несколько адресов. Именно так работает headless-сервис: apiserver получает все члены etcd и сам выбирает из них доступный.
Что здесь может пойти не так? У apiserver нет никакого знания о топологии. Для него член etcd на соседней площадке ничем не отличается от члена в своей зоне, и при разрыве он вполне может держаться за член без лидера на другой стороне. Поэтому мы перенастроили apiserver’ы на обычный сервис с PreferClose, и после этого всё поехало.
etcd
К этому моменту сеть работала и API находился, но тест всё равно не проходил. Разбираясь, почему, мы сделали для себя неожиданное открытие: etcd, на котором держится весь Kubernetes, не умеет сам восстанавливаться после частичного разрыва сети. И это не баг, а прямое следствие того, как устроен Raft.
Почему etcd не выздоравливает сам
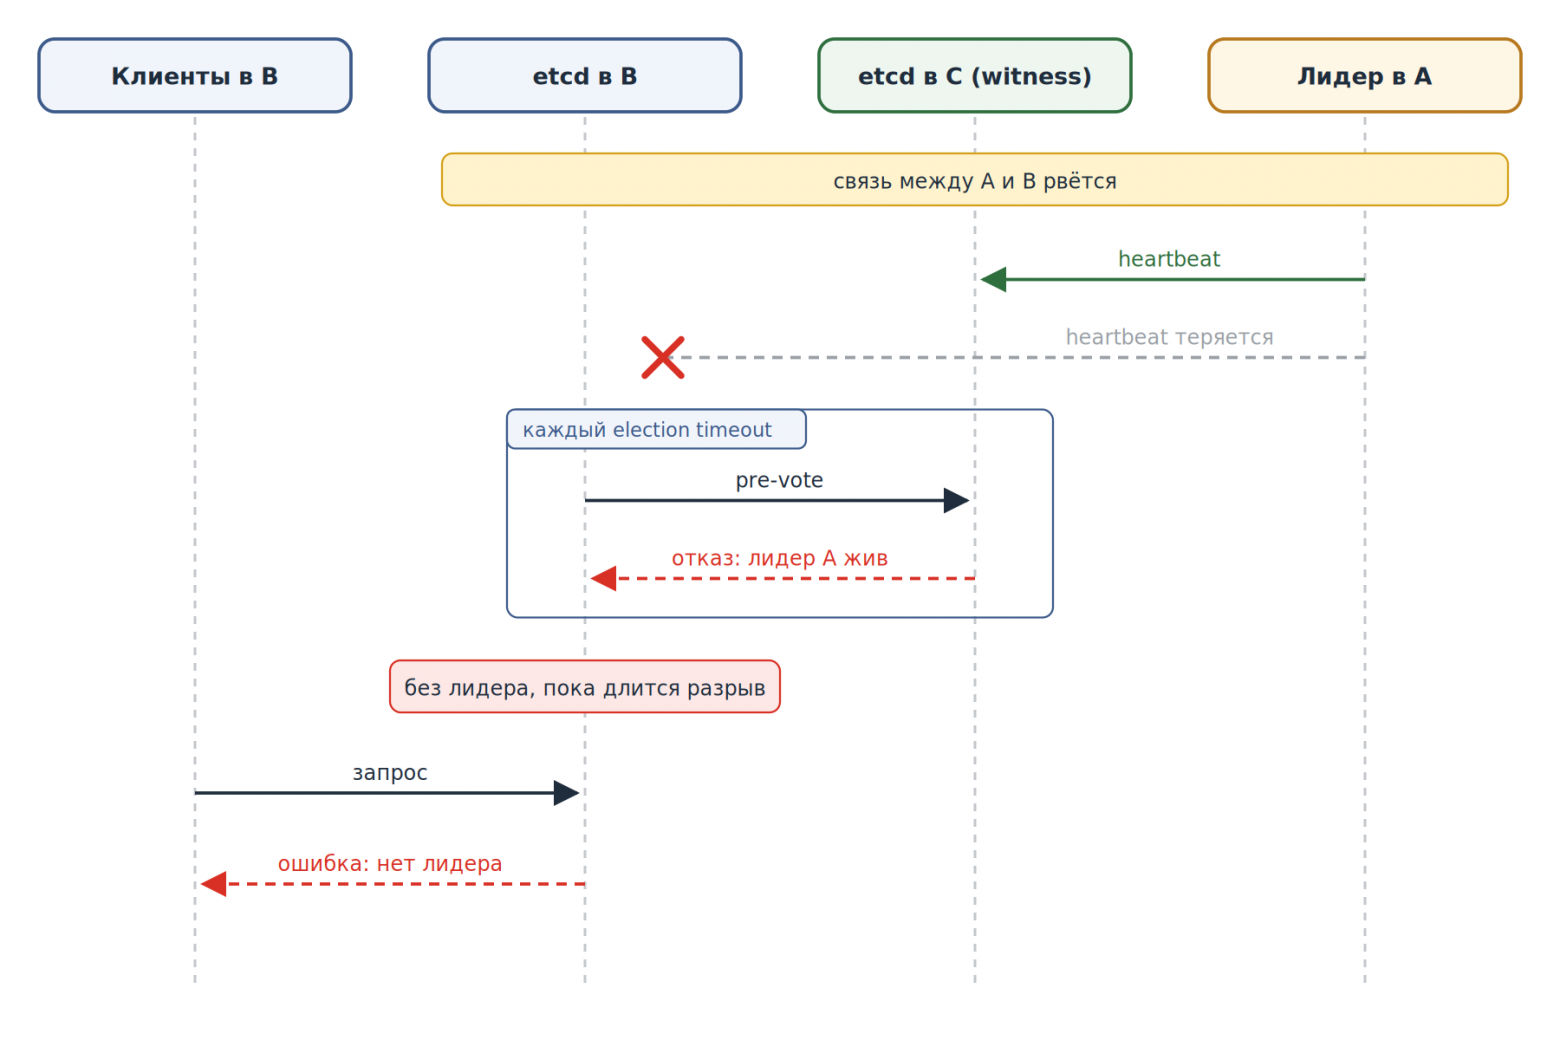
Возьмём три члена etcd на трёх площадках: A, B и witness C. Связь между A и B рвётся, C видит обоих, лидер находится в A.
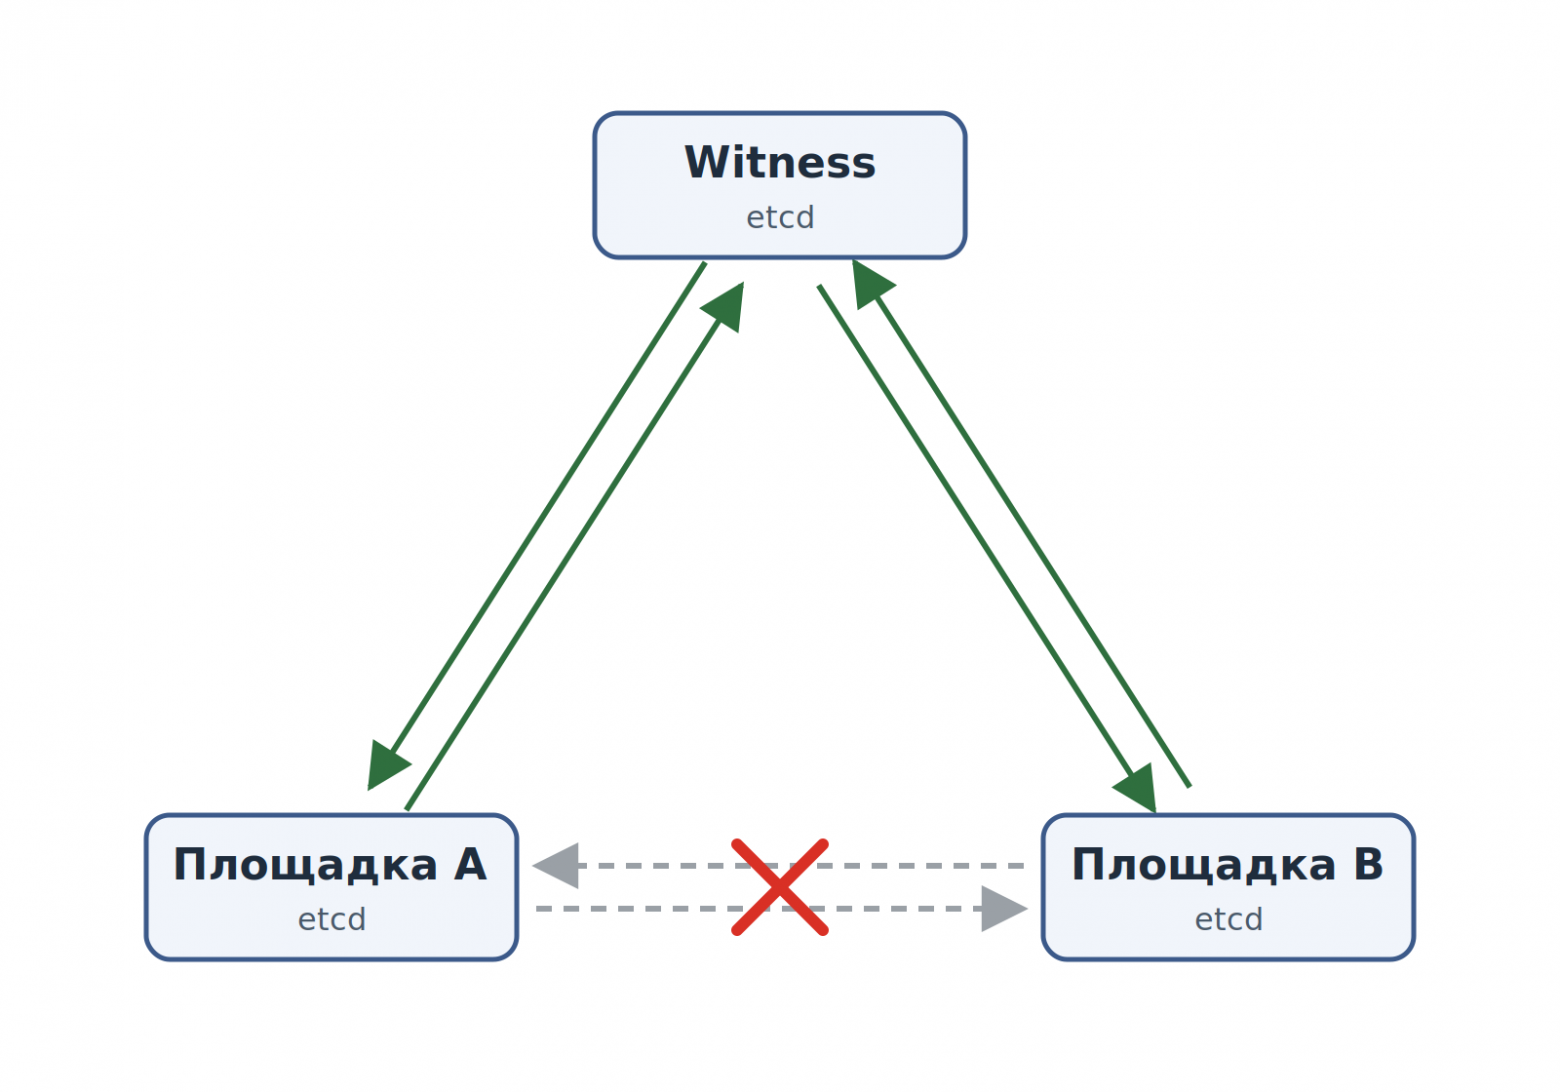
Лидер в A сохраняет кворум с C и продолжает принимать записи. Член в B теряет лидера и пытается начать выборы, но C отказывает ему в голосе, потому что всё ещё слышит живого лидера. За это отвечают PreVote и CheckQuorum: они защищают Raft от лишних перевыборов, и член, который не слышит лидера, не может свергнуть лидера, которого слышит остальной кворум. Это не баг, так задумано. Но в результате член в B остаётся без лидера всё время, пока длится разрыв, и все подключённые к нему клиенты получают ошибки. При этом apiserver поверх него с точки зрения Kubernetes вполне себе жив.
Когда на одних и тех же площадках работает несколько etcd-кластеров, картина становится ещё запутаннее: каждый кластер остаётся там, где у него случайно оказался лидер. Часть кластеров продолжает работать со стороны B, часть нет, и результат зависит от удачи.
Лечится это одной командой — etcdctl move-leader на член в C, который видит всех.
Готового механизма в upstream нет. Приоритет лидера предлагали и закрыли как stale (etcd-io/etcd#10201), а ForgetLeader в библиотеке raft есть (etcd-io/raft#78), но etcd его не использует и наружу не выставляет.
threek
Первым делом мы посмотрели на memberlist, который, например, использует MetalLB. Но он не подошёл: memberlist реализует SWIM, и если один узел не может достучаться до другого напрямую, он просит третий проверить его за себя. Для memberlist это защита от ложных срабатываний, а для нас ровно та ситуация, которую нужно поймать: частичный разрыв он специально прячет. Поэтому мы сделали проще: каждый член сам проверяет остальных и рассказывает, кого он видит, а лидер переезжает туда, откуда видно всех. Правило уложилось в одну фразу:
Если лидер не видит какого-то члена, а другой член видит всех, лидер передаёт лидерство этому члену.
Реализовал это @sir_cthulhu в проекте threek. Устроен он так:
-
Рядом с каждым членом etcd работает агент
threek-agent, а сам etcd, его образ и аргументы остаются без изменений. -
Раз в секунду каждый агент проверяет пиров тем же запросом, которым их проверяет сам etcd:
GET /raft/probingна peer-порт с peer-сертификатом. Никаких новых правил на фаерволе не требуется, и etcd ничего лишнего не логирует. Голый TCP connect здесь не подошёл бы, так как etcd пишет в лог каждое соединение, закрытое до TLS-хэндшейка. -
То, что агент видит, он публикует в небольшую запись в самом etcd под префиксом
/threek/members/с lease на 10 секунд. Переписывается она только при изменении картины, поэтому стабильный кластер лишних записей не получает. kube-apiserver эти ключи не видит, так как читает только/registry. -
Решение принимает только текущий лидер, и только через штатный
MoveLeader. etcd принимает этот вызов исключительно на настоящем лидере, так что два агента, которые оба считают себя лидером, не смогут оба перенести лидерство. Консенсуса между агентами нет, форка etcd нет, новых портов нет. -
Если всех не видит никто — площадка упала целиком или сеть развалилась полностью, — threek ничего не делает, и Raft отрабатывает как обычно.
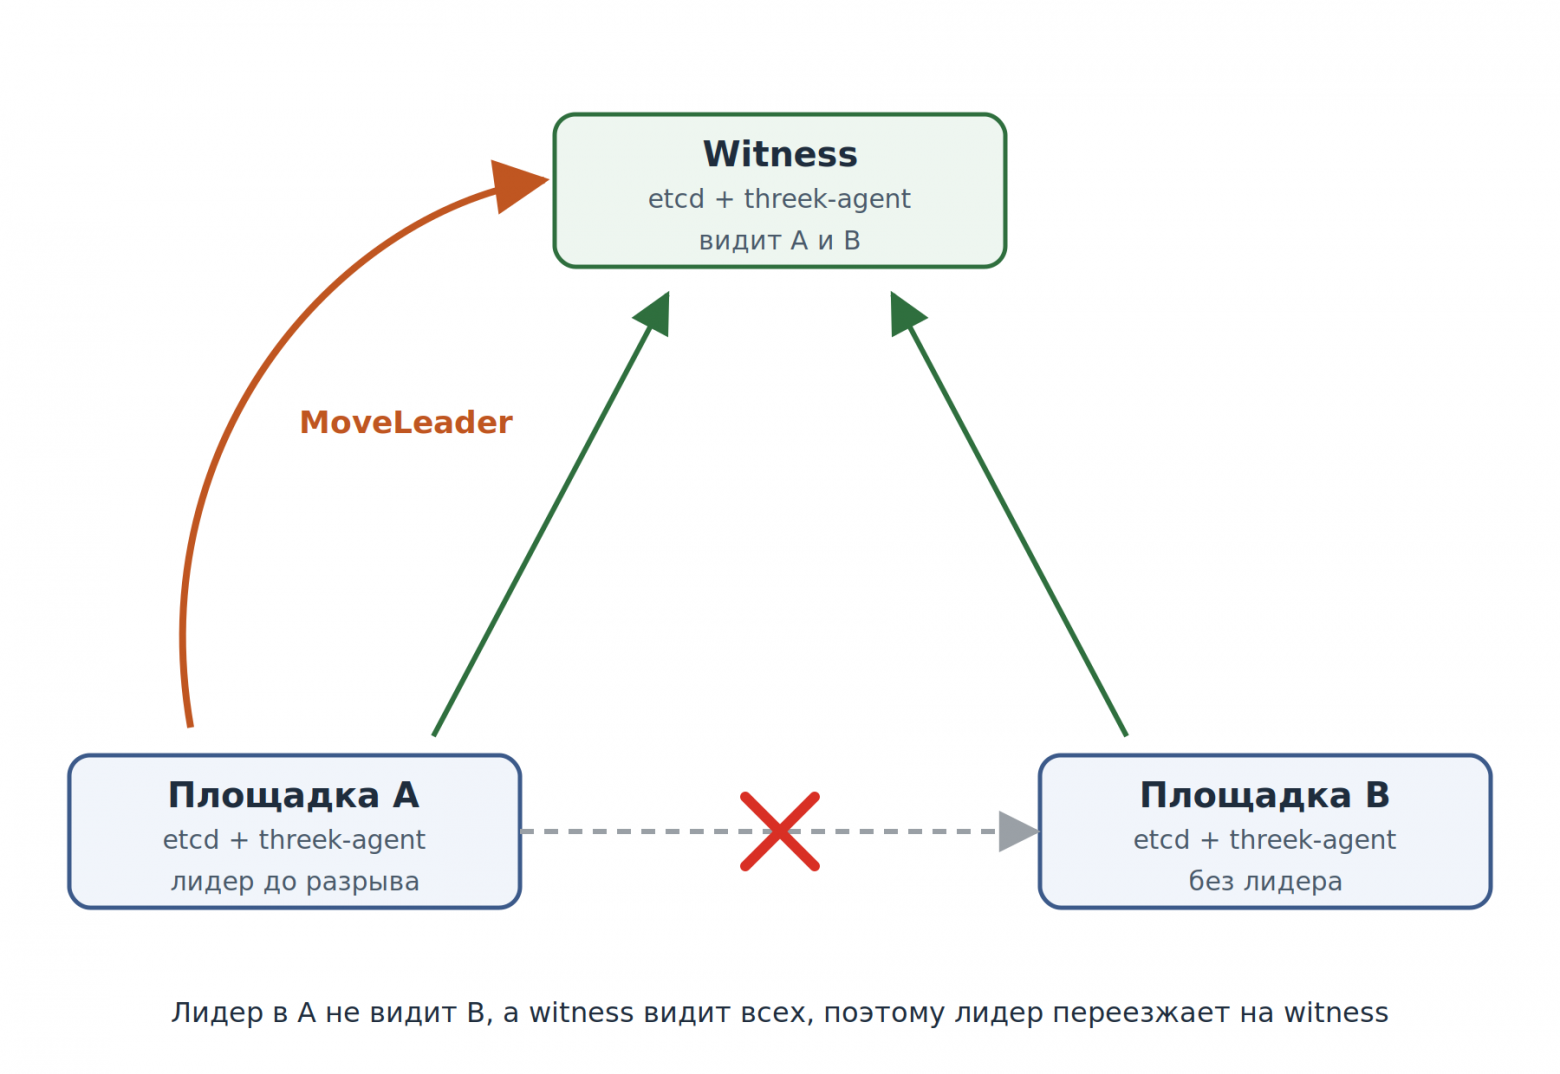
Чтобы флапающий линк не гонял лидера туда-сюда, предусмотрен гистерезис. Линк считается упавшим после трёх неудачных проб подряд и поднявшимся после десяти удачных, перенос выполняется, только если линк лежит дольше 15 секунд, а получив лидерство, агент две минуты не отдаёт его дальше. Опционально можно задать preferred leader, и тогда после восстановления связи лидер вернётся на него.
С настройками по умолчанию лидер переезжает примерно через 20 секунд после разрыва — это время меряет e2e-тест в репозитории.
По дороге нашлась ещё одна любопытная вещь. Изначально мы хотели вообще не опрашивать пиров, а читать метрику etcd etcd_network_active_peers. Оказалось, что она не замечает пира, который перестал отвечать: таймаут чтения у peer-стримов выставлен на dialer, который net/http игнорирует, и стрим к такому пиру остаётся «активным», пока не сдастся TCP, а это минуты. @sir_cthulhu отправил исправление в upstream (etcd-io/etcd#22639), но в выпущенных версиях баг остаётся, поэтому threek меряет достижимость самостоятельно.
Обёртка или сайдкар
Первая версия threek была образом, в котором бинарь etcd подменён обёрткой: она запускала настоящий etcd и агента рядом с ним. Логика понятная — и в Talos, и в etcd-operator подменить образ проще, чем добавить ещё один контейнер. Однако позже мы решили пересмотреть эту логику в пользу отдельного контроллера и уже через день от обёртки отказались. Причин было несколько:
-
в Talos явно заданный образ etcd отключает его штатное обновление, а исправления безопасности etcd оказываются привязаны к релизам threek;
-
любое изменение настроек перезапускает etcd;
-
обёртке приходится в точности повторять разбор флагов, обработку сигналов и коды выхода etcd.
Теперь агент можно запустить двумя способами. С etcd-operator это native sidecar, который подкладывается в поды членов через MutatingAdmissionPolicy по метке на кластере, так что сам оператор менять не нужно. На Talos это static pod на каждой control-plane ноде, который ходит в etcd с клиентским сертификатом, выпускаемым Talos для kube-apiserver. Отдельного сертификата для агента Talos не выпустит, а передавать его через machine config означало бы раздать ключ всем, у кого есть роль os:reader.
Что получилось на живом кластере
Разрезы мы делали на продовом кластере, пока на нём ещё не было боевого трафика. В первом прогоне агент стоял только на части etcd-кластеров, и это дало наглядное сравнение. etcd без агента вёл себя в точности по схеме выше: член на отрезанной стороне всё время разреза оставался без лидера, его apiserver был не ready, а нода уходила в NotReady. С threek лидер через 17 секунд переезжал на witness, сама передача лидерства занимала около 100 мс, все три члена оставались в кворуме, а все три apiserver — в состоянии ready.
Отдельно мы проверили асимметричные разрезы, когда трафик режется только в одну сторону, и stateful-фильтрацию, как на настоящем фаерволе, где режутся только новые соединения, а установленные продолжают жить. Здесь threek тоже отрабатывает: если соединения от лидера пропадают, он переносит лидера на witness, а если связь у лидера остаётся, лидер остаётся на месте.
А если площадок две
К нам вообще часто приходят с вопросом, можно ли жить всего на двух площадках. Обычно мы требуем хотя бы одну witness-ноду в третьей. Но мысль о том, как можно было бы обойтись двумя, меня не отпускала: полноценный третий член участвует в каждой записи и должен стоять так же близко, как два других, а подходящей третьей площадки рядом может просто не оказаться.
Ещё в конце августа я закинул тред на Reddit: насколько сложно научить etcd работать на двух датацентрах с лёгким внешним арбитром, который не хранит данные и участвует только в выборах? Это мог бы быть хоть S3-бакет, хоть что-то ещё. Там же появилось и рабочее название — twok :)
В комментариях мне подкинули ссылки на то, как это делает Red Hat. Решений у них два. Two-Node with Arbiter — по сути обычный трёхчленный etcd, просто третья нода не запускает остальной control plane и рабочую нагрузку, но данные хранит полностью. Интереснее Two-Node OpenShift with Fencing, где действительно два члена etcd и Pacemaker. При потере связи узлы пытаются зафенсить друг друга через BMC, выживший перезапускает etcd с --force-new-cluster, а зафенсенный потом возвращается learner’ом с пустым каталогом данных. Кто выживет, решает статическая задержка фенсинга по имени ноды (в коде cluster-etcd-operator это 10 и 1 секунда), а информация о том, кто выжил, хранится в CIB Pacemaker, который расщепляется вместе с нодами. Поэтому холодный старт и перезагрузка выжившего требуют участия человека. К тому же у нас Talos, и никакого Pacemaker там нет.
Идея висела давно, и руки до неё всё не доходили. Но когда threek получился таким аккуратным — маленький агент рядом с etcd, который работает только через его публичные API и не трогает ни образ, ни флаги, — я решил попробовать воплотить в той же форме и её.
У Red Hat twok берёт сам механизм, но меняет в нём три вещи: фенсинг заменяет арбитром, задержку — compare-and-swap, а память в CIB — поколением, которое живёт в арбитре и в логе самого кластера.
Как устроен twok
Рядом с каждым из двух членов etcd работает агент, и пока у кластера есть лидер, он ничего не делает. Лидер в кластере из двух членов снимает себя сразу, как только теряет фолловера, поэтому потеря ноды, линка или целой площадки для агентов выглядит одинаково: лидера нет.
Если лидера нет дольше claim-after (20 секунд), каждый агент пытается через compare-and-swap увеличить поколение в арбитре на единицу и записать выжившим себя. Выиграть может ровно один, причём бывший лидер получает фору в 5 секунд. Арбитр — это одна запись в несколько сотен байт в любой системе с атомарным CAS:
-
S3-бакет (условный
PUTпо ETag); -
другой etcd (транзакция по ModRevision);
-
ConfigMap в Kubernetes (resourceVersion);
-
любой HTTP-сервис, поддерживающий
PUTсIf-Match.
При старте каждый бэкенд проверяет на пробном ключе, что хранилище действительно соблюдает условия, потому что некоторые S3-совместимые хранилища такие заголовки принимают, но игнорируют. Арбитр не стоит на пути записи, поэтому задержка до него не важна.
Победитель останавливает свой etcd, сам дописывает в его WAL удаление второго члена и даёт etcd запуститься снова с теми же флагами. etcd проигрывает лог и через 1–2 секунды лидирует в кластере из одного члена. Проигравший же ничего не может закоммитить уже в силу самого Raft: голосующий член без второго не коммитит ничего, знает он про арбитр или нет. Когда связь вернётся, он узнает, что его удалили, агент добавит его обратно learner’ом под новым ID, перепишет идентификатор члена в его WAL, и он догонит выжившего с того места, где остановился.
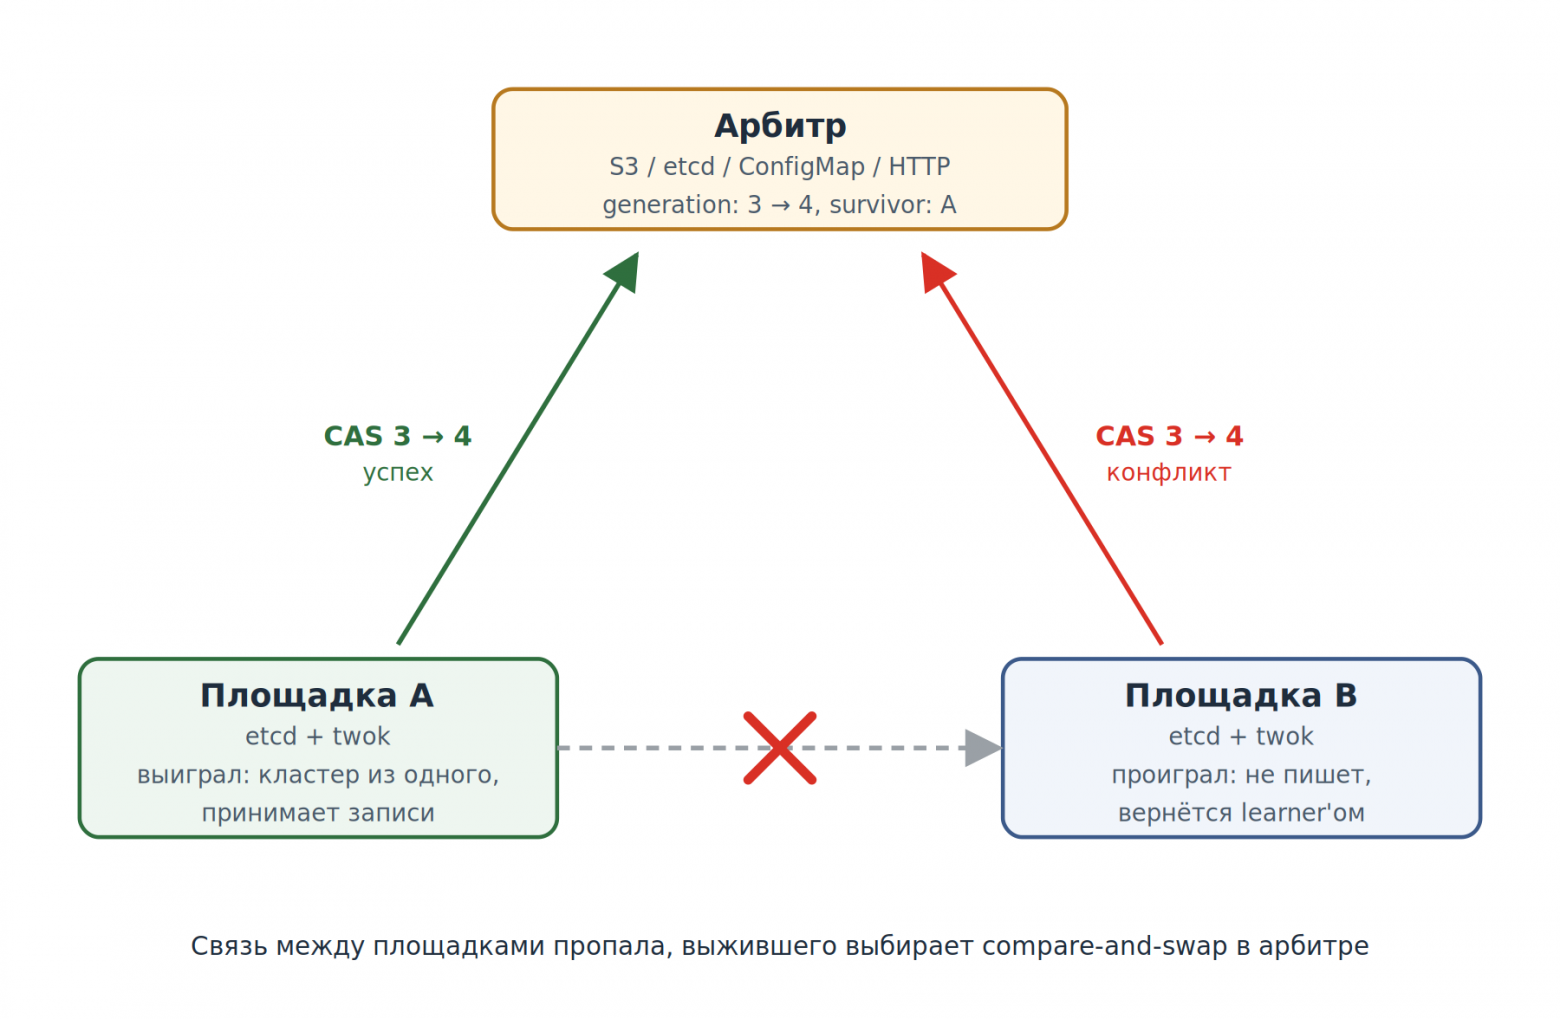
Важно, что член может претендовать только на то поколение, которое лежит в его собственных данных. Поэтому член с отставшими данными никогда не станет выжившим, он может только вернуться.
Если вы знакомы с DRBD, механизм покажется знакомым: там похожую роль играют идентификаторы поколений. Узел, который стал primary без связи с соседом, начинает новое поколение данных, и при переподключении по этим идентификаторам видно, у кого данные свежее и кому догонять. Разница в том, что DRBD обнаруживает split brain уже постфактум, когда оба узла успели начать новое поколение, а в twok новое поколение выдаётся через compare-and-swap в арбитре, и получить его может только один.
Почему не –force-new-cluster
На мой взгляд, это самая интересная часть исследования. --force-new-cluster отбрасывает записи WAL выше commit index члена. А фолловер узнаёт commit index из следующего сообщения лидера, так что в момент разрыва у него может лежать подтверждённая клиенту запись, о которой он ещё не знает, что она закоммичена.
Мы проверили это на реальном etcd 3.5.34 и 3.6.15: пара членов, клиент пишет через лидера, а фолловера убиваем SIGKILL сразу после подтверждения записи. Персистентный commit index фолловера отставал от его лога во всех прогонах. --force-new-cluster на копии тех же данных терял от 1 до 4 подтверждённых записей в каждом прогоне — и при немедленном убийстве, и при конкурентной записи. Правка WAL, которую делает twok, не потеряла ни одной.
Удаления twok дописывает в следующем term и с commit в конце лога, ничего не усекая. Если же дописывать удаления в текущем term, как это делает --force-new-cluster, возвращающийся член падал с panic: failed to update; member unknown на обеих версиях. Разжаловать проигравшего в learner вместо удаления тоже не получилось: Raft такую запись принял бы, но membership-слой etcd на ней паникует.
Что показали тесты
Все цифры вместе с командами и сырыми логами лежат в docs/testing.md, здесь приведу основное.
Возврат проигравшего с сохранением лога работает и инкрементально, и через снапшот после 5300 записей, и с расходящимся хвостом, который в этом случае перезаписывается. В интеграционных тестах с двумя агентами и реальным etcd через TCP-прокси первая запись у выжившего проходила через 29–31 секунду после разреза, пара восстанавливалась через 5–10 секунд после восстановления связи, и все подтверждённые записи оставались на месте.
На стенде в Kubernetes с сетевыми разрезами первая серия из девяти прогонов со всеми видами арбитров дала такую картину: последний лидер выигрывал каждый раз, первая запись проходила через 29–30 секунд, проигравший снова голосовал через 7–13 секунд после восстановления связи, а из 428–476 подтверждённых записей на прогон не потерялась ни одна. Если же арбитр недоступен в момент разрыва, не пишет никто, пока не вернётся арбитр или связь. Это осознанный выбор: безопасность здесь важнее доступности.
Односторонний разрез нашёл настоящий баг. Проигравший узнавал о своём удалении раньше, чем истекал его claim-after, etcd уходил в crash loop, а агент, которому было некого спросить, так и не читал арбитр и не возвращал член в кластер. Безопасность при этом не пострадала: проигравший не принял ни одной записи. Баг исправлен, сценарий перепроверен.
Отдельно интересен baseline без twok: на голом etcd после восстановления связи пара переизбирала лидера около 48 секунд. Похоже на backoff TCP-ретрансмиссий на peer-стримах, которые оставались открытыми во время разреза, но пока это лишь гипотеза.
Чего twok пока не умеет
twok сейчас в статусе research, и ставить его в прод не стоит.
Двойной отказ, когда выживший умирает раньше, чем вернулся проигравший, требует вмешательства человека: twok arbiter claim --accept-data-loss. Проигравший до возвращения продолжает отдавать serializable-чтения со старых данных, потому что twok фенсит записи, а не чтения и не ноду. И, как и в случае с threek, клиентов нельзя оставлять на проигравшем: нужно перечислять оба члена или маршрутизировать по площадке.
Что в итоге
Kubernetes действительно даёт хороший фундамент для отказоустойчивой платформы, но только для тех отказов, о которых он знает. Частичная недоступность сети, когда все живы, но не все видят друг друга, в его модель не укладывается, и каждый уровень — балансировка, доступ к API, etcd — пришлось учить отличать «Ready» от «работает».
Если вы строите что-то похожее, будем рады фидбеку, issue и PR.
Полезные ссылки
Автор: kvaps

