


Ночью воздухоразделительная установка похожа на декорацию к “Бегущему по лезвию”: колонны в подсветке, белый пар над испарителями, ровный гул компрессоров. Каждую секунду с семи таких площадок приходят 920 показаний датчиков. Наша работа была в том, чтобы ни одно из них не потерялось.
Проект выглядел понятным, и мы пришли на него в белом пальто. Для нуара это плохой выбор: в дождливом городе белое пальто первым собирает брызги из-под колес, и каждый поворот дела оставляет на нем пятно. Через пару месяцев простой заказ превратился в дело с ложными следами, молчаливыми свидетелями и уликами, которые врут.
Меня зовут Александр Волков, я руковожу проектами практики промышленной аналитики и IIoT в GlowByte. В 2025 году мы как интегратор вместе с Data Sapience, вендором платформы Industrial Ocean, строили технологический архив телеметрии для Air Liquide. Архив нужен для диагностики оборудования, от которой зависят безопасность на площадках и бесперебойные поставки газа клиентам.
На бумаге задача была простой: 7 площадок, 3 сервера PI System (промышленный архив, куда пишутся показания датчиков, дальше буду писать просто PI, не путать с ягодами) и 30 782 тега (тег — это один датчик или один сигнал). Нужно было четыре вещи: настроить сбор данных в реальном времени, загрузить историю и обвесить все метаданными, то есть понять, какой тег к какому оборудованию относится, и настроить передачу всего этого (как свежего потока, так и истории по запросу) в смежную систему для real-time диагностики. Мы это сделали за восемь месяцев командой в 3,5 FTE. В архиве сейчас 141,76 млрд строк с историей с июня 2013 года.
По дороге дело сделало пять поворотов, от ложного следа готового коннектора до подшипника на 6 млн градусов. Каждый раз казалось, что это последний шаг до финала. В итоге последний поворот оказался главным: архив теперь знает о прошлом больше, чем сам источник. Ниже все пять событий в том порядке, в каком они случились, а в конце — чек-лист, что проверить до старта, чтобы не повторять наш путь.
Заказ
Air Liquide — один из мировых лидеров в производстве технических газов: кислорода, азота, водорода, углекислоты, неона и других. На площадках работают компрессорные станции, воздухоразделительные установки, насосы и теплообменники, и все это пишет телеметрию в PI.
Неон в этой истории не только для атмосферы. Неоновый свет придумал один из основателей Air Liquide, инженер Жорж Клод. В 1910 году он показал на Парижском автосалоне две красные трубки по 12 метров, а неон для них получал попутно, на своих же установках сжижения воздуха. Так что у неон-нуара, если разобраться, заводское происхождение.
До проекта поверх данных работала зарубежная система предиктивной аналитики. Ее меняли из-за санкционных рисков: лицензии не продлить, поддержки нет, обслуживание могут прекратить в любой момент. Air Liquide заменил систему и заодно расширил объем и глубину анализируемых данных с предприятия.
Новую диагностику строил смежный вендор. И для нее требовалась надежная основа: слой данных, который быстро отдает и текущую телеметрию, и историю за любой период. За это отвечали мы.
Как все должно было работать
Путь данных простой:
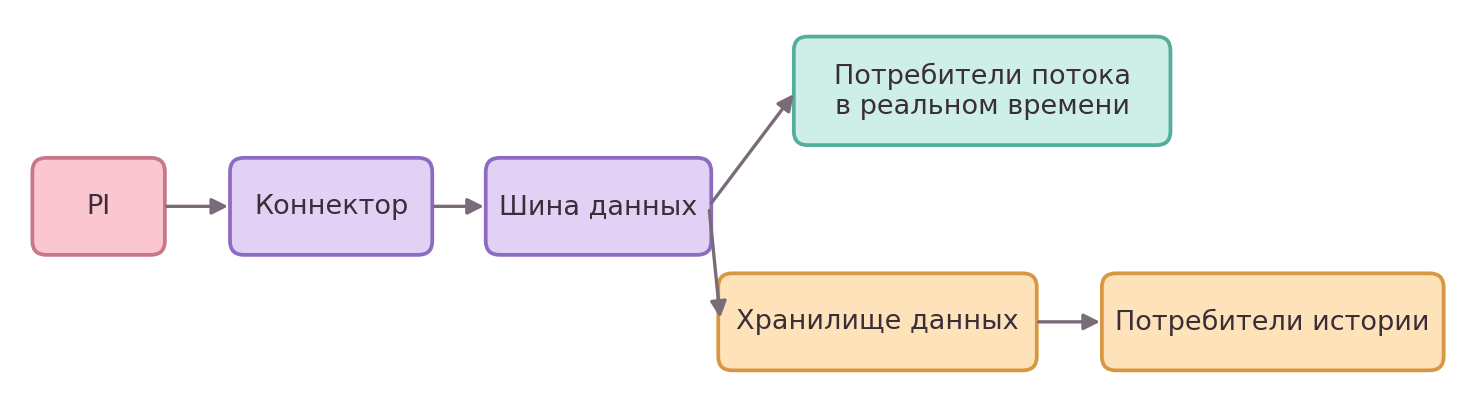
Транспорт мы проверили нагрузочным тестом еще в январе 2025 года. Для single-instance решения, которое на тот момент было типовым форматом поставки Industrial Ocean, ожидаемая нагрузка от поступающих данных превышала возможности основной пары “шина данных-хранилище” EMQX-InfluxDB. Благо к этому времени у нас как раз появилась версия под кластерное развертывание на Kubernetes с Kafka и ClickHouse, и их параметры с запасом перекрывали оценку. ClickHouse хорошо подходит для хранения больших объемов данных: на 1000 точек уходит 4,24 кБ, что важно при хранении многолетней истории. В нашем случае год данных со всех площадок занимает порядка 5 ТБ.
Причина, по которой необходимо забирать сырые данные из PI, без агрегирования или прореживания, заключается в их назначении: на основе собираемых данных осуществляется диагностика состояния оборудования. Температура подшипника на 2–3 минуты поднимается на 3–4 °C выше обычного разброса, до тревоги не доходит, но за неделю такое повторяется все чаще. В среднем за час этого скачка не видно совсем. А пропущенный износ подшипника на компрессоре может закончиться остановкой установки и перебоем в поставках газа.
Передать данные в целевую систему было самой спокойной частью. У платформы открытые API, она под такие интеграции и сделана, и первая интеграция прошла легко. Больше о ней сказать нечего, и это лучшее, что можно сказать об интеграции.
Так выглядел план. По нему ни одно показание не терялось на пути от датчика до архива. Планы в нуаре живут недолго.
Поворот первый: ложный след готового коннектора
Первый след вел к PI Web API: под него у Industrial Ocean уже был готовый коннектор. На практике оказалось, Web API на площадках как бы есть, но не везде и включить его можно не всегда.
Пришлось писать отдельный коннектор на PI SDK, что вылилось в две дополнительные недели интеграции и дополнительную виндовую машину в инфре (а вы думали, как? суровые промышленные либы под линукс не адаптируют…). PI SDK не умеет отдавать данные по подписке, только по запросу, зато за любой имеющийся в системе интервал времени. Коннектор опрашивает источник микробатчами примерно раз в минуту и за один запрос забирает все точки, записанные с прошлого опроса – то есть в одном батче по каждому тегу приходит не одна, а все записанные замеры. Некоторые теги меняются каждые 100–150 мс, и все изменения по ним мы получаем и записываем.
Данные в реальном времени пошли. Первое пятно на пальто оказалось небольшим, и я даже успел подумать, что дальше будет скучно.
Поворот второй: у каждого свидетеля свой темп
Начали догружать историю и выяснили, что источники, как свидетели на допросе, говорят каждый в своем темпе. Они держат разную нагрузку и отдают данные с разной скоростью, иногда в разы медленнее друг друга. Железо на площадках везде свое, каналы тоже.
Звучит очевидно. Мы тоже так думали, пока не прочувствовали это на собственном графике. Совет из нашего опыта: проверьте реальную скорость КАЖДОГО источника до того, как планировать завершение этапа.
Решение оказалось скучным, как и положено рабочему решению: подобрали частоту опроса и темп загрузки под каждый источник. История грузилась около 2,5 месяцев, с конца июня по сентябрь 2025 года, под постоянным контролем и сверками. Параллельно ребята начали настраивать метаданные.
История грузится, сверки сходятся, свежие данные качаются исправно. В нуаре это момент, когда герой наливает себе виски и выключает свет. Зря.
Поворот третий: опознание 30 тысяч тегов
Данные лежат в архиве, но пока это просто 30 тысяч рядов чисел. Показание, про которое неизвестно, с какого оно оборудования, для диагностики все равно что потеряно. Из надежных метаданных у заказчика был только код тега. Выглядит он как заклинание. Вот похожий, выдуманный, но устроенный так же, как настоящие:
ZK3_RM01-F207B.MTR_VT0418A.VAL
(все же понятно, правда?)
На самом деле – если знать, как читать, то это действительно почти паспорт датчика:
|
Фрагмент |
Что значит |
|
ZK3 |
площадка |
|
RM01 |
установка: сырьевая мельница, № 1 |
|
F207B |
оборудование: вентилятор 207, агрегат B |
|
MTR |
узел: электродвигатель |
|
VT |
что измеряем: вибрацию |
|
0418 |
номер точки измерения |
|
A |
основной датчик |
|
.VAL |
текущее значение (value) |
Для обычного IT это экзотика, а в промышленной аналитике — ежедневная работа. И размечать 30 тысяч тегов руками мы, конечно, не собирались. Для этого есть карты отображения: они собирают теги в модульные иерархические объектные модели, из которых складывается модель предприятия, технологической линии или производственного процесса.
Мы строили модели “снизу вверх”, от простых узлов и агрегатов к единицам оборудования и дальше к площадке. Сначала описываются типы оборудования (например, вентилятор или электродвигатель). Потом на эту структуру накладываются теги, и в системе появляется конкретная единица оборудования (например, вентилятор 207 сырьевой мельницы №1 с площадки ZK3). По такой модели проще ориентироваться и строить запросы к телеметрии.
Но система всегда немного живее схемы. Где-то вместо латинской M стоит русская М, и для человека это одна мельница, а для парсера — две разные. Где-то подчеркивание вместо дефиса, где-то пропущен сегмент или порядок частей другой, потому что площадку размечали в другие годы и другие люди. Кроме того, есть еще некоторые очень важные метаданные (например, единицы измерения), которые не всегда заполняются, и их стоит уточнять на данных. Автоматика закрыла большую часть тегов, остальное мы разбирали в полуручном режиме. В общей сумме на разбор тегов, заведение моделей и прочую обвеску метаданными у нас ушло 5 дней.
Разобранные коды мы используем и дальше, в том числе при построении базы знаний по оборудованию.
Тридцать тысяч досье разобраны, оборудование опознано, у каждого показания теперь есть имя. Можно переходить к анализу.
Поворот четвертый: подшипник на 6 миллионов градусов
Тут коллеги уже начали смотреть данные (в том числе новые, ранее в анализе не используемые). И нашли подшипник с температурой 6 млн градусов. Это горячее солнечной короны. Компрессор при этом работал штатно, так что версию с термоядерным синтезом в машинном зале мы отбросили сразу.
Подозреваемых было трое: датчик, наш коннектор и ClickHouse. Виновной оказалась запятая, точнее, ее отсутствие: в метаданных PI у части тегов был неверно указан тип значения. Числа читались как строки, по дороге терялась десятичная запятая, и температура в десятки градусов превращалась в миллионы.
Самое обидное пятно на пальто оставили наши же сверки: они этого не ловили. Мы сверяли архив с теми же данными и метаданными PI, то есть свидетель и проверяющий читали одну и ту же бумажку с одной и той же опечаткой.
Заказчику это не мешало: сам PI такие значения показывал нормально, а эти теги никто не анализировал. Обычная жизнь большой системы, где тысячи тегов годами настраивали разные люди. Мы попросили коллег из Air Liquide поправить тип в метаданных, и подшипник остыл до земных значений.
Из космоса вернулись на землю. Все сходилось, все работало, и ни одно показание по дороге не терялось. Оставался последний поворот, и он был самым важным.
Поворот пятый: свидетель меняет показания
Для сверки мы сделали отдельную утилиту, которая считает, сколько тегов расходится с источником. Через некоторое время она показала странную картину: за вчера сходится, за неделю назад — нет. За “сейчас” данные всегда сходятся. За прошлые периоды начинают расходиться, и чем дальше в прошлое, тем сильнее.
Сначала мы, конечно, искали ошибку у себя и заново допросили всех прежних подозреваемых: коннектор и логику загрузки, метки времени и часовые пояса, округления и тип чисел, пропущенные окна и сбои канала. Все исключили, но расхождение не уходило и выглядело все так же странно – количество точек совпадает, значения совпадают на свежих данных и расходятся на прошлом, причем загруженная часть архива сходилась как ни в чем не бывало, расхождение возникало только на том, что мы грузили в потоке.
Помогла не математика, а картинка. Положили графики одного тега из нашего хранилища и источника рядом и посмотрели глазами. Картина получилась примерно такая (на иллюстрации смоделированные ряды, а не данные заказчика):
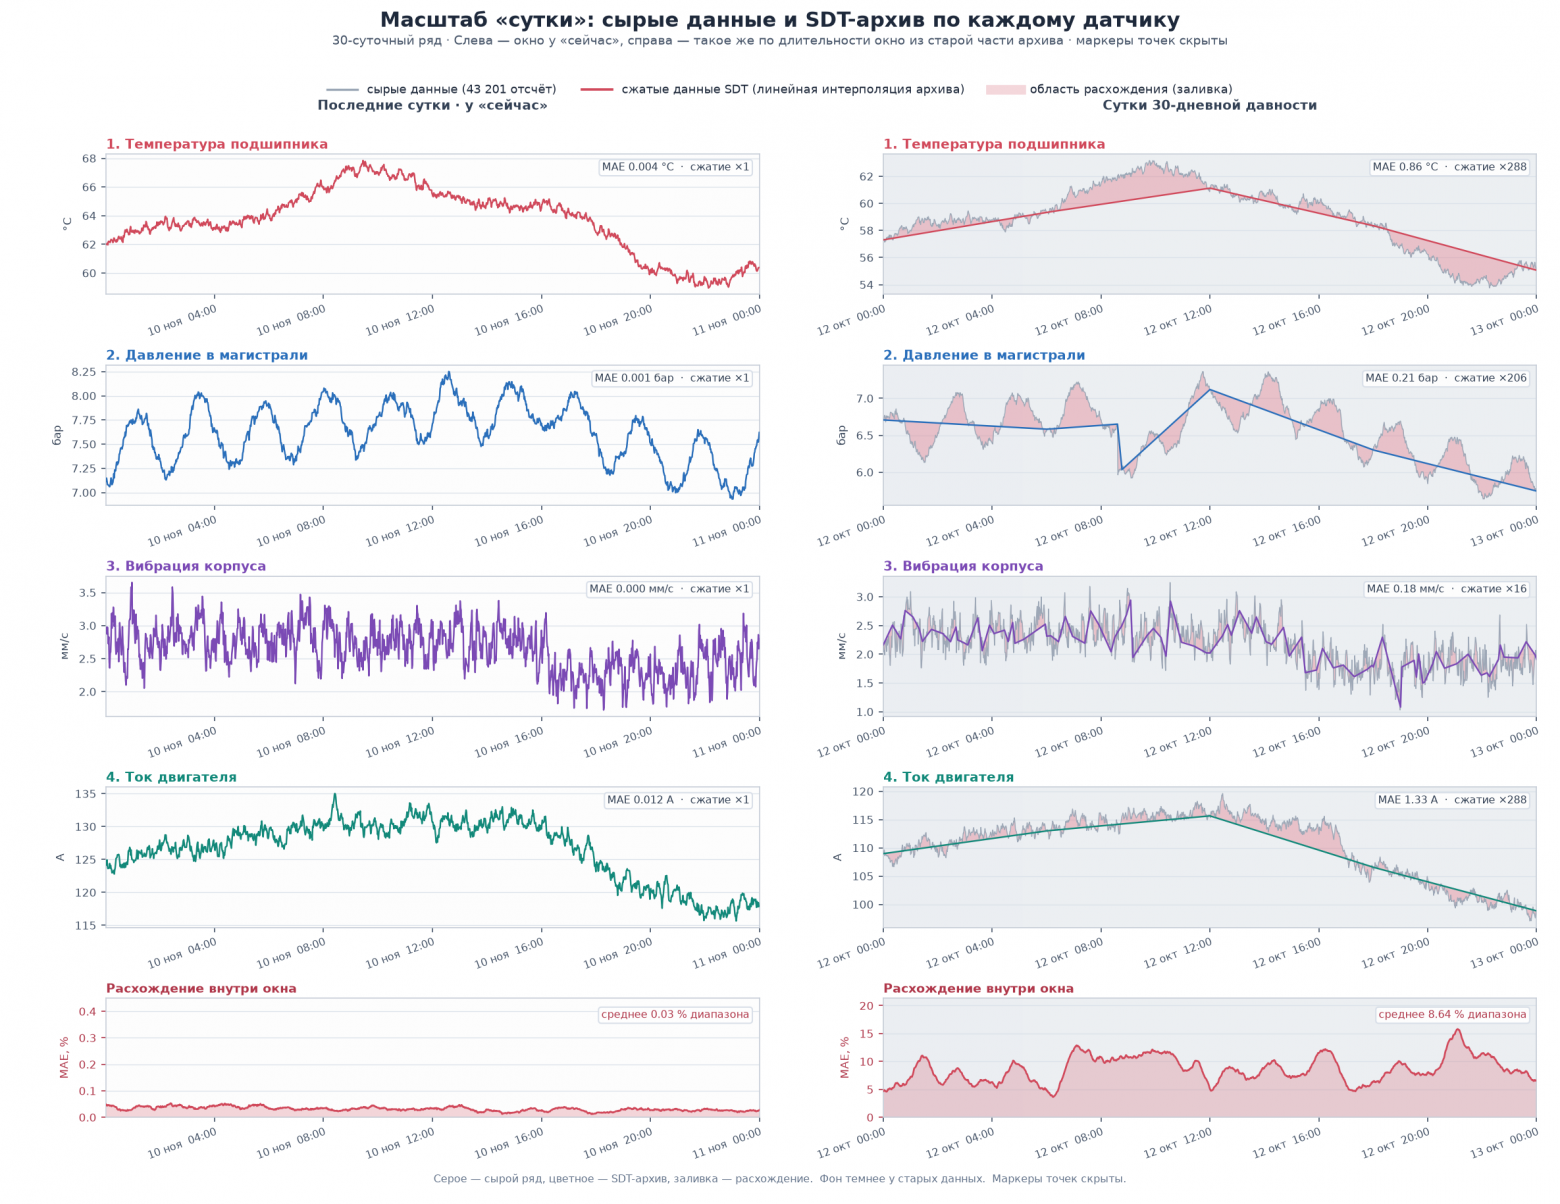
У нас сигнал “живой”, с честным шумом и мелкими колебаниями. В источнике – чем старше данные, тем более гладкими они выглядят. Архив мы загрузили уже сжатым, поэтому по нему всё сходилось, а вот свежие данные остаются в первозданном виде исключительно у нас, первоисточник их со временем огрубляет.
Как в “Бегущем по лезвию”, вопрос свелся к тому, чья память настоящая. Сырые точки остались только в нашем архиве.
Слово защите: свидетель не лгал
PI ничего не скрывал, он хранит историю по своим правилам. Более того, для целей мониторинга обработка данных PI прекрасен, его метод хранения помогает не отвлекаться на дребезг сигнала. Но для архива и расследования нам были важны точные значения. Между датчиком и приложением стоит historian, база временных рядов, и данные в нем лежат не так, как их выдает датчик:
-
Отсев на входе (exception)
Новое значение уходит в архив, только если оно изменилось больше порога или прошло максимальное время ожидания. -
Сжатие (compression, алгоритм “качающейся двери”)
Архив записывает точку, только если сигнал вышел за допустимый коридор вокруг прямой между предыдущими точками. Остальные выбрасываются безвозвратно. -
Восстановление при чтении
Недостающие значения система дорисовывает интерполяцией, соединяя записанные точки отрезками. Отсюда гладкий график: значение между точками вычислено, а не измерено.
Вдобавок один и тот же тег можно прочитать разными способами: записанные точки (recorded), значения на ровной сетке (interpolated), урезанный набор для графика (plot) или агрегаты за интервал (summaries). Каждый дает свою картину.
Почему расхождение растет именно с возрастом данных? Версий четыре:
-
Ступенчатое хранение
Подробные данные живут недолго, потом сворачиваются в усредненные. Для SCADA и многих историанов это обычная практика. -
Пересжатие
Со временем данные пересжимаются, и исходные точки заменяются более грубыми. Наблюдали мы именно такую картину, но в документации стандартного PI Data Archive такого механизма нет: там сжатие выполняется один раз при записи. Для этого заказчика версию проверяем по настройкам хранилища. -
Свежие данные еще не устоялись
Самая новая точка проходит сжатие позже, поэтому за последний час картина иная, чем за вчера. -
Менялись настройки тегов
Если допуск сжатия правили, старые и новые участки записаны с разной точностью.
Какая бы версия ни подтвердилась, данные, которые источник отдает сегодня, не равны тем, что он отдавал вчера. То, что historian свернул, не вернет никакой коннектор. Общий тренд остается, а короткие пики, быстрые колебания и точное время событий пропадают. Для отчетности этого хватает. Для диагностики нет: ей нужны как раз малые отклонения вроде того трехминутного скачка на подшипнике.
Если для диагностики нужны мелкие отклонения, данные надо забирать как можно раньше и как можно ближе к источнику, а не восстанавливать их из архива постфактум.
Дело закрыто. Почти
Под утро, как и положено в нуаре, дело было раскрыто. Почти: мотив главного свидетеля так и не установлен. Утро растянулось на восемь месяцев, а белое пальто к этому времени стало серым плащом, какой и полагается детективу.
Утилита сверки теперь знает, что сравнивать надо одинаковое с одинаковым: способ чтения, сетку времени и глубину данных.
Что проверить у источника до старта, чтобы пройти этот путь короче:
-
Интерфейсы
Какие способы доступа реально есть на каждой площадке и можно ли их включить. Готовый коннектор хорош, только если источник его поддерживает. -
Реальная скорость каждого источника
Замерить на живой выгрузке и заложить разный темп загрузки. -
Система именования тегов
Есть ли правило, насколько ему следуют и сколько исключений: кириллица вместо латиницы, разные разделители, пропущенные сегменты, отсутствующие метаданные. -
Типы значений в метаданных
Совпадает ли заявленный тип с реальным. Сверять стоит не только с источником, но и со здравым смыслом: 6 млн градусов на подшипнике — повод задуматься. -
Как источник хранит историю на разной глубине
Есть ли сжатие, какие допуски, хранятся ли подробные данные ограниченный срок. Сверить свой ряд с источником за последний час, вчера и месяц назад и посмотреть, растет ли расхождение.
Итоги проекта
Диагностике оборудования Air Liquide теперь есть в чем искать: история по семи площадкам с июня 2013 года, а с момента подключения — сырые точки, подробнее, чем в самом источнике. Значит, износ можно заметить раньше, чем он скажется на поставках.
Все, что разработали в проекте, вошло в Industrial Ocean и доступно другим клиентам: целью с самого начала было тиражируемое решение. Платформа собирает телеметрию с распределенных площадок, хранит ее с любой глубиной истории и дает строить поверх мониторинг, расчеты и ML-модели.
Каждую минуту в архив по-прежнему приходят данные с 30 000 датчиков. В источнике со временем часть из них “растворится, как слезы в дожде”. В архиве каждое значение остается таким, каким было записано. Туда же мы сдали и материалы дела.
Вместо эпилога — вопросы к тем, кто тоже тянет данные с производства. Как вы их забираете: в исходном виде или уже агрегированными? И как разбираете коды тегов: правилами, справочниками или руками? Поделитесь самым странным тегом, который вам попадался.
Очная ставка. 18 ноября в Москве пройдет Data Sapience Data Day 2026. На демозоне будет стенд Industrial Ocean: платформу можно опробовать лично и обсудить это дело с командой. Участие бесплатное, регистрация проходит модерацию: зарегистрироваться на Data Sapience Data Day.
Подписывайтесь на блоги Data Sapience и GlowByte на Хабре, а также на Telegram-канал Data Sapience.
Автор: alexander_volkov

