


36 недель. Столько, по моему мнению, занимает путь от нуля до выхода на рынок ML-инженером. Не 2-3 месяца, как обещают курсы, — чуть дольше. Зато на выходе у вас будет фундамент, с которым можно пройти не только собеседования, но и испытательный срок.
В этой статье — весь маршрут по неделям: что учить, в каком порядке, сколько на это уходит времени и что можно смело отложить до первого оффера. Это текстовая версия первого выпуска моей серии «Roadmap ML 2026» на YouTube: видео.
Сразу оговорюсь. Устроиться ML-щиком можно и за месяц. Но на испытательном сроке будет очень тяжело, особенно если IT для вас — совершенно новая область. Я предлагаю другой подход: фундаментальная база, нацеленная на прохождение собеседований и комфортную работу на позиции ML-инженера. При этом всё лишнее я стараюсь выкидывать, а тупиковые ветки обрубать.
Во-первых, так выше шанс пройти испытательный срок и закрепиться на работе. Во-вторых, такой фундамент — прочная база для дальнейшего самостоятельного развития в ML.
Немного о себе: меня зовут Ян Шмидт, я ML-инженер в British Petroleum и параллельно готовлю ребят разного начального уровня к работе ML-специалистами на рынке СНГ и за рубежом. За два года через моё менторство прошло больше 60 человек, больше 15 из них уже работают в ML — в российских и зарубежных компаниях. Всё, что ниже помечено как «по моему опыту», — именно оттуда, а не из исследований рынка.
Кто идёт в ML в 2026 году
Прежде чем проходиться по маршруту, посмотрим, кто вообще выбирает по нему идти. С сентября 2025 по сентябрь 2026 мне пришло 114 анкет на менторство. Я прочитал каждую и вручную разметил бэкграунд, уровень и цели.
Это не срез всего рынка, а люди, которые пришли именно ко мне. Но картина, по-моему, показательная. Подробнее — в посте
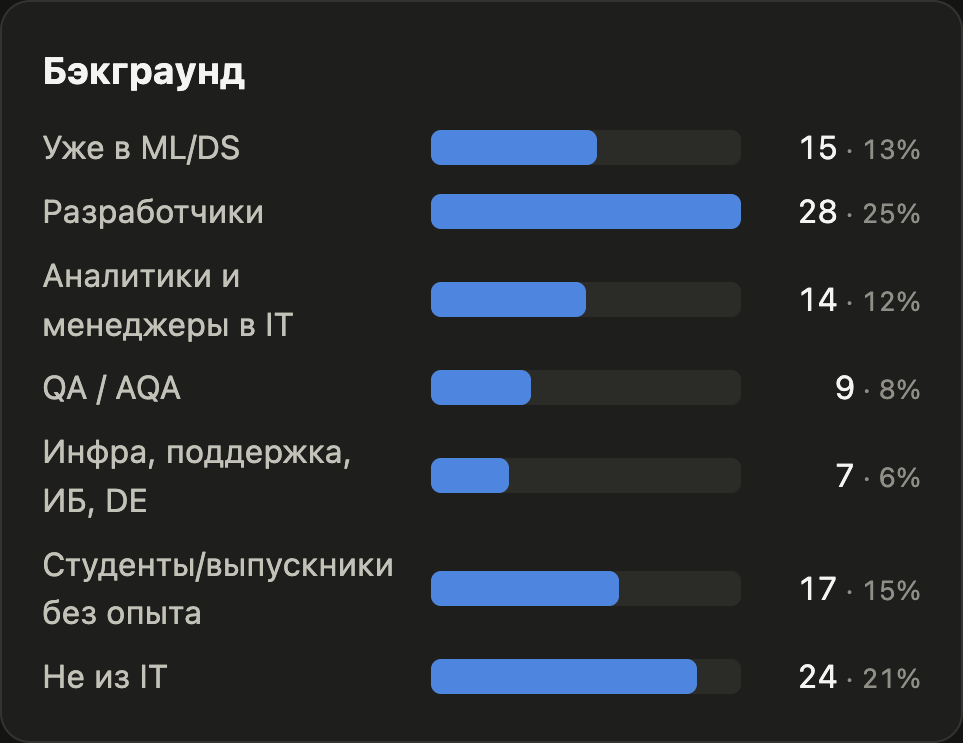
Кто приходит:
-
64% уже работают в IT. Самая большая группа — разработчики, четверть всех заявок: Go, фронтенд, Java;
-
21% вообще не из IT — инженеры-строители, врачи, биологи, маркетологи, экономисты;
-
15% — студенты и выпускники без опыта;
-
и только 13% уже работают в ML — приходят за грейдом или чтобы натренировать навык прохождения собеседований.
Возраст — от 17 до 56 лет, каждый седьмой старше 35. Заявки пришли из 19 стран, почти 70% — из России (Москва — 38 человек, Петербург — 17), дальше Казахстан, Беларусь, Испания, Таиланд и даже США, Мексика и Аргентина.
Зачем им ML. 52% — интерес к задачам и науке, 38% — «за этим будущее». Про деньги прямо говорят 26%, но в целях деньги всплывают уже у 36%. И 10% боятся сокращений и замены ИИ.
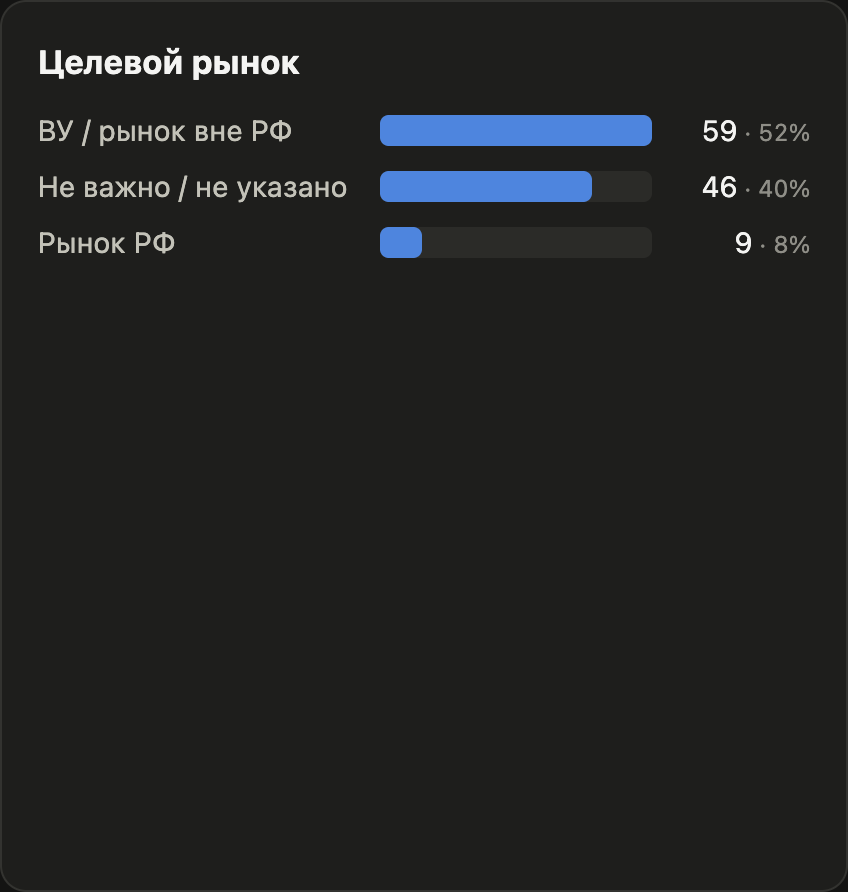
Главный тренд — валютная удалёнка (ВУ). С сентября 2025 по февраль 2026 на зарубежный рынок целился 31% кандидатов, с марта — уже около 60%. За весь год 52% хотят ВУ, 40% всё равно где, и только 8% явно выбирают рынок России. Меньше всего на зарубеж целятся студенты: им сначала нужен хоть какой-то первый оффер.
И главная проблема — английский. Свободно им владеют 40% всех кандидатов, а среди тех, кто хочет на ВУ, — 46%. То есть больше половины будущих «валютчиков» пока читают с переводчиком или знают язык на базовом уровне.
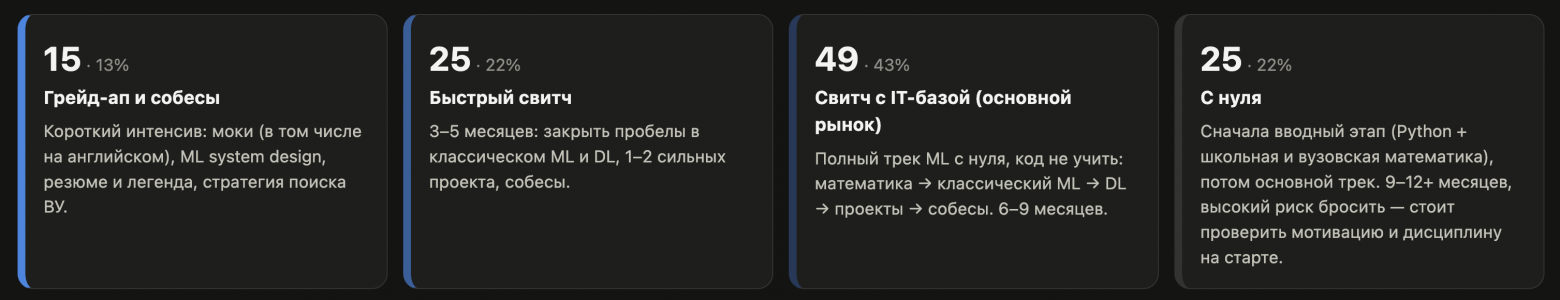
С чем приходят. 22% — почти с нуля (нет IT-опыта, Python около нуля). 43% — основной поток: IT-база есть, а ML и математика с нуля. Ещё 22% — база хорошая, нужно доучить и упаковать. И 13% уже практикуют ML. По времени 89% готовы учиться больше 15 часов в неделю.
Если собрать всё вместе, типичный кандидат выглядит так: 26 лет, живёт в России, уже работает в IT — чаще всего разработчиком. Python знает, а ML и математику начинает почти с нуля. Готов учиться 15–30 часов в неделю и хочет оффер — желательно на ВУ.
И сразу развею миф: «в ML меньше конкуренции и проще попасть» — нет. Порог входа выше, чем в аналитику или бэкенд. Одна из причин — высшая математика, которая часто становится главным страхом и мешает вообще начать. Поэтому и нужен маршрут, который обрубает ненужные ветки и ведёт к концентрированной базе — той, что встречается почти на каждом ML-собеседовании и в реальных рабочих проектах.
Карта: 6 этапов
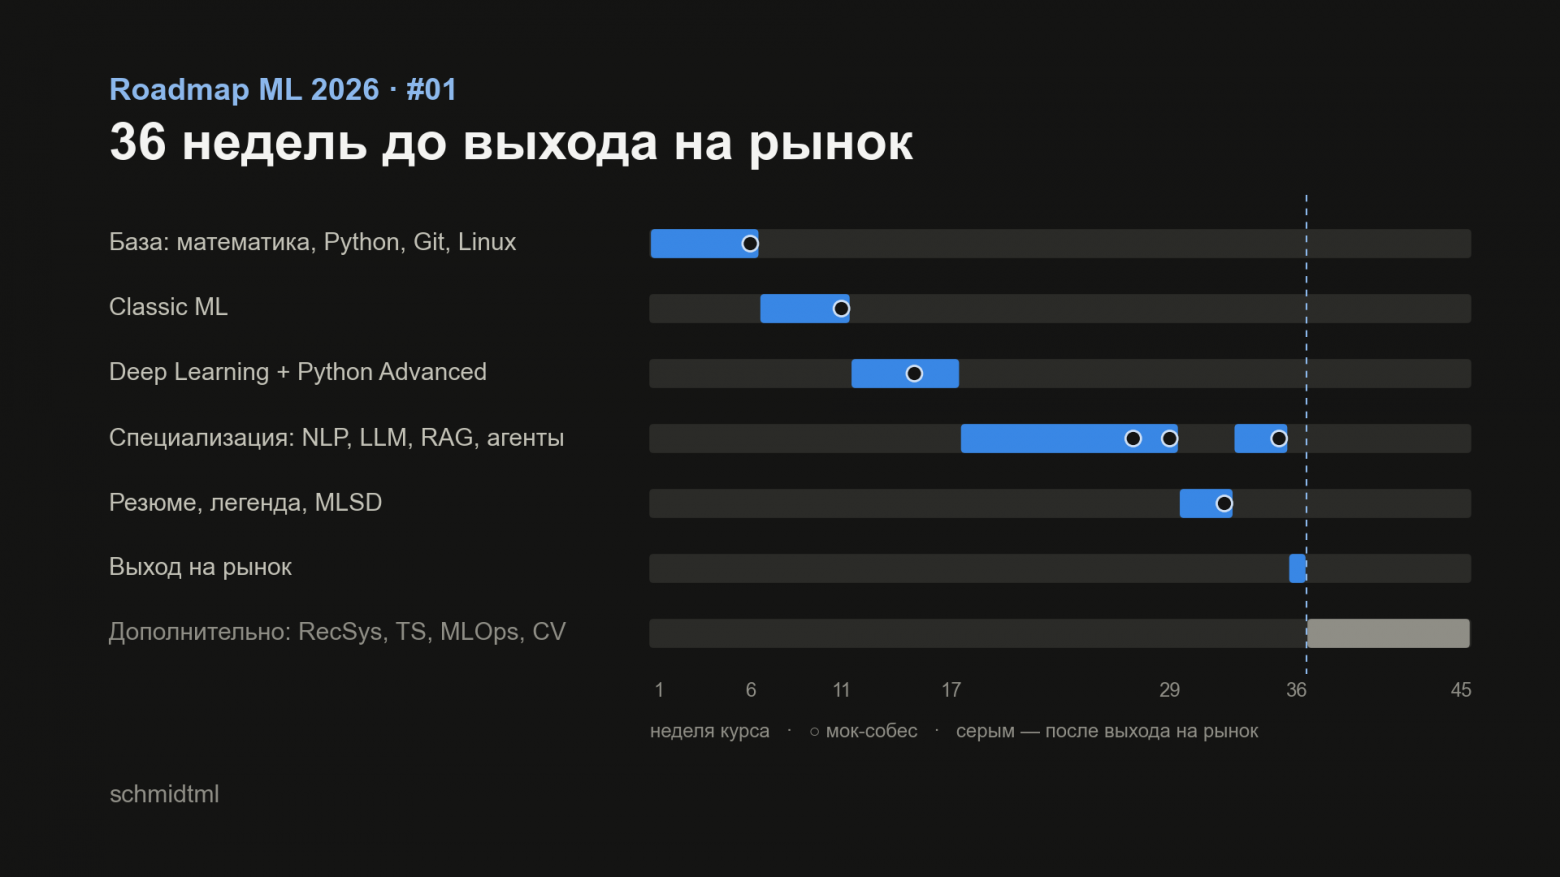
Весь путь — это шесть этапов:
|
№ |
Этап |
Недели |
Мок-собеседование |
|---|---|---|---|
|
1 |
База: математика, Python, Git, Linux |
1–6 |
неделя 6 — Python |
|
2 |
Classic ML |
7–11 |
неделя 11 — Classic ML |
|
3 |
Deep Learning + Python Advanced |
12–17 |
неделя 15 — Deep Learning |
|
4 |
Специализация: NLP, LLM, RAG, агенты |
18–29, 33–35 |
недели 27 (NLP), 29 (RAG), 35 (агенты) |
|
5 |
Резюме, легенда, ML System Design |
30–32 |
неделя 32 — резюме, легенда, MLSD |
|
6 |
Выход на рынок |
36 |
— |
|
+ |
Дополнительно: RecSys, Time Series, MLOps, CV |
37–45 |
— |
Кружки на схеме — мок-собеседования. После каждого крупного блока стоит проверить знания так, как это делают на настоящем собесе.
Цифры плана:
-
45 недель, из них 36 обязательных. Остальные 9 — дополнительные темы, к ним можно вернуться уже после выхода на рынок;
-
нагрузка — примерно 18 часов в неделю, в сумме около 650 часов (точнее, 646) на обязательную часть;
-
по ходу — 7 мок-собеседований.
Сколько идти лично вам
Сроки зависят от старта. Цифры ниже — моя личная оценка по опыту менторства, от первого занятия до выхода на работу.
|
Стартовый уровень |
Срок |
Что делать |
|---|---|---|
|
С нуля: нет IT-опыта и математики |
9–12+ месяцев |
Сначала вводный этап: Python + школьная и вузовская математика, потом основной трек |
|
Есть IT-база, ML и математика с нуля |
6–9 месяцев |
Полный трек: код учить не надо — математика |
|
Сильная база |
3–5 месяцев |
Закрыть пробелы, сделать 1–2 сильных проекта и идти на собеседования |
|
Уже работаете в ML |
— |
В основном собеседования и рост грейда |


Всё упирается в то, сколько времени вы готовы вкладывать и с каким бэкграундом приходите: в зависимости от этого 36 «условных» недель могут сократиться в разы — или растянуться.
Учитывайте сезонность. Ближе к зиме и в первый месяц после Нового года вакансий заметно меньше. Закладывайте это, когда планируете выход на рынок.
Как учиться
До того как начать, стоит разобраться, как вообще учиться.
-
Ведите конспекты — в Notion, Obsidian или любом другом удобном формате. Я советую Obsidian: все заметки хранятся у вас на компьютере.
-
Ошибки. Раньше все гуглили и находили ответ на Stack Overflow — сейчас это быстрее делает нейросеть.
-
Редактор кода. VS Code бесплатный, Cursor — с нейросетью внутри, $20 в месяц. Мне Cursor более чем хватает. Также можно посмотреть в сторону Claude и Codex.
Этап 1. База: математика, Python, Git, Linux
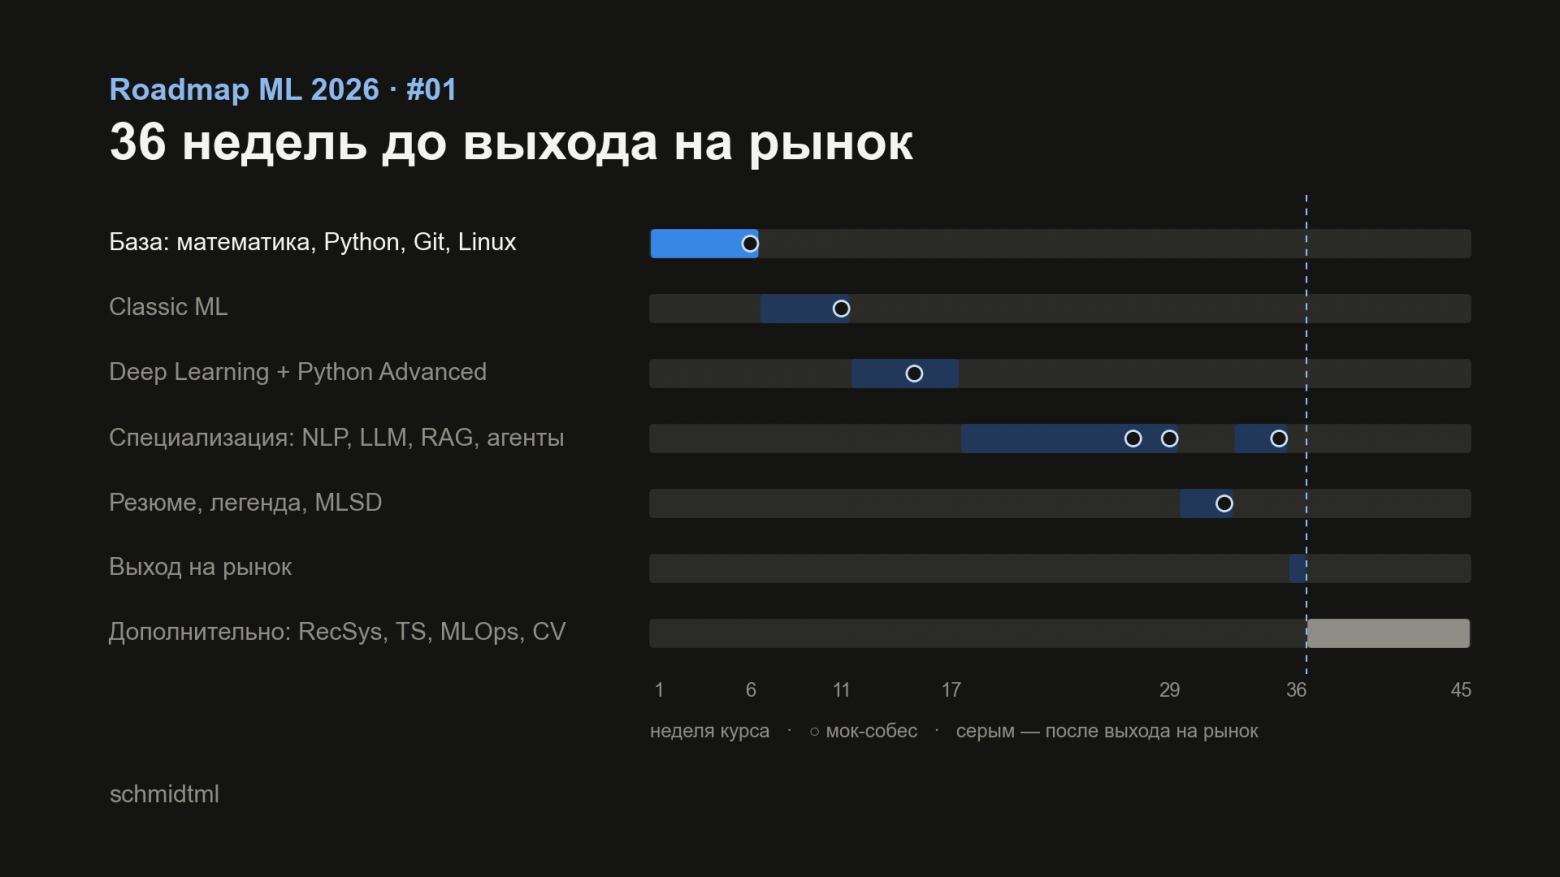
Недели 1–6. Здесь четыре предмета параллельно: математика, Python, Git и Linux.
Почему именно они? Python и математика — самый первый фильтр на любом ML-собеседовании. Вас могут попросить объяснить базовые понятия из математики, прочитать кусок кода, написать функцию или класс, провести код-ревью. Это не обязательно задача с LeetCode или Codeforces — но без базы пройти уже не так просто.
Математика: 16 блоков за 4 недели
|
Неделя |
Раздел |
Темы |
|---|---|---|
|
1 |
Пререквизиты |
Нотация: суммы и произведения, принадлежность, кванторы, индикаторы, argmin/argmax, нормы, логарифмы |
|
1–2 |
Алгебра |
Векторы, скалярное произведение, матрицы, тензоры; векторные пространства, базис, линейная (не)зависимость; ранг; определитель, собственные числа и векторы, SVD |
|
2 |
Математический анализ |
Функции одной и нескольких переменных, предел, непрерывность; производные и частные производные, экстремум, градиент; метрика и норма |
|
3–4 |
Теорвер и матстат |
Случайные величины и распределения (нормальное, Бернулли, Пуассона…); матожидание, дисперсия, условная вероятность, теорема Байеса; выборка, bootstrap, гипотезы, доверительные интервалы, ошибки I и II рода, t-test, A/B-тест; квантили, ковариация, корреляция; ЦПТ и закон больших чисел |
|
4 |
Численные методы |
Постановка задачи оптимизации, градиентный спуск и его проблемы, принцип максимума правдоподобия |
|
4 |
Теоретическая информатика |
Энтропия и перекрёстная энтропия |
Каждый блок — набор отдельных тем: например, векторы и матрицы — это две разные темы.
Какой минимум нужен по математике? Звучит сложно, на практике проще.
-
Переводите обозначения на человеческий язык. Вектор — это направленный отрезок, набор чисел. Матрица — табличка чисел. Строго говоря, матрица задаёт линейное преобразование из n-мерного пространства в m-мерное, но для начала хватит того, что это табличка.
-
Интуиция производной и градиента: куда и как быстро меняется функция.
-
Статистика: как принимать решения, когда есть неопределённость.
-
Градиентный спуск, максимум правдоподобия и кросс-энтропия — прямая база под функции потерь в машинном обучении.
Подробный разбор математики для ML с примерами — в моей статье про математику для ML.
Python: три части
-
Python Base — недели 1–4: синтаксис, типы данных, функции, итераторы и генераторы, файлы и контекстные менеджеры, декораторы, исключения, ООП и основные библиотеки — numpy, pandas, matplotlib.
-
Python Algorithms — неделя 5: сложность по времени и памяти, типовые подходы.
-
Python Advanced — позже, на неделях 16–17. Почему так — расскажу в этапе 3.
Алгоритмы: узнать подход, а не вызубрить
Типовые подходы: хеш-таблица, два указателя, скользящее окно, стек и очередь, DFS/BFS, динамическое программирование. Важно: эти алгоритмы не надо зазубривать и прорешивать сотни задач на LeetCode и Codeforces.
Главный навык скрининга — не вспомнить алгоритм наизусть, а узнать его в условии задачи. Прочитали формулировку — поняли, какой подход нужен. Или получили решение от нейронки — но тогда нужно уметь его объяснить по тому коду, который выдала LLM. Поэтому полностью пропускать этот шаг не стоит, но и тратить на него больше 1–2 недель я не рекомендую.
По моим наблюдениям, алгозадачи на собеседованиях постепенно уходят на второй план — встречаются, например, вайб-код собеседования. Да, и такое бывает.
Git и Linux
-
Git: важно не заучить команды, а понять, что такое репозиторий, коммит, дифф и ветка — что именно сохраняется и зачем.
-
Linux: уверенно работать в терминале и хотя бы несколько раз своими глазами увидеть основные команды — файлы, пути, поиск, копирование и перемещение, скачивание с серверов.
Позже, на неделях 12–14, Linux добирается до того, что нужно для обучения моделей: процессы, tmux, SSH, scp/rsync, nvidia-smi, OOM и чеклист перед запуском обучения.
Как понять, что база освоена
На шестой неделе — мок-собеседование по Python. Там проверяют не только синтаксис. Отвечать нужно по схеме: короткий ответ  уточнение
 пример
 сложность
 крайние случаи. И объяснять, почему вы выбрали именно такое решение, где код может сломаться и как его проверить.
Этап 2. Classic ML
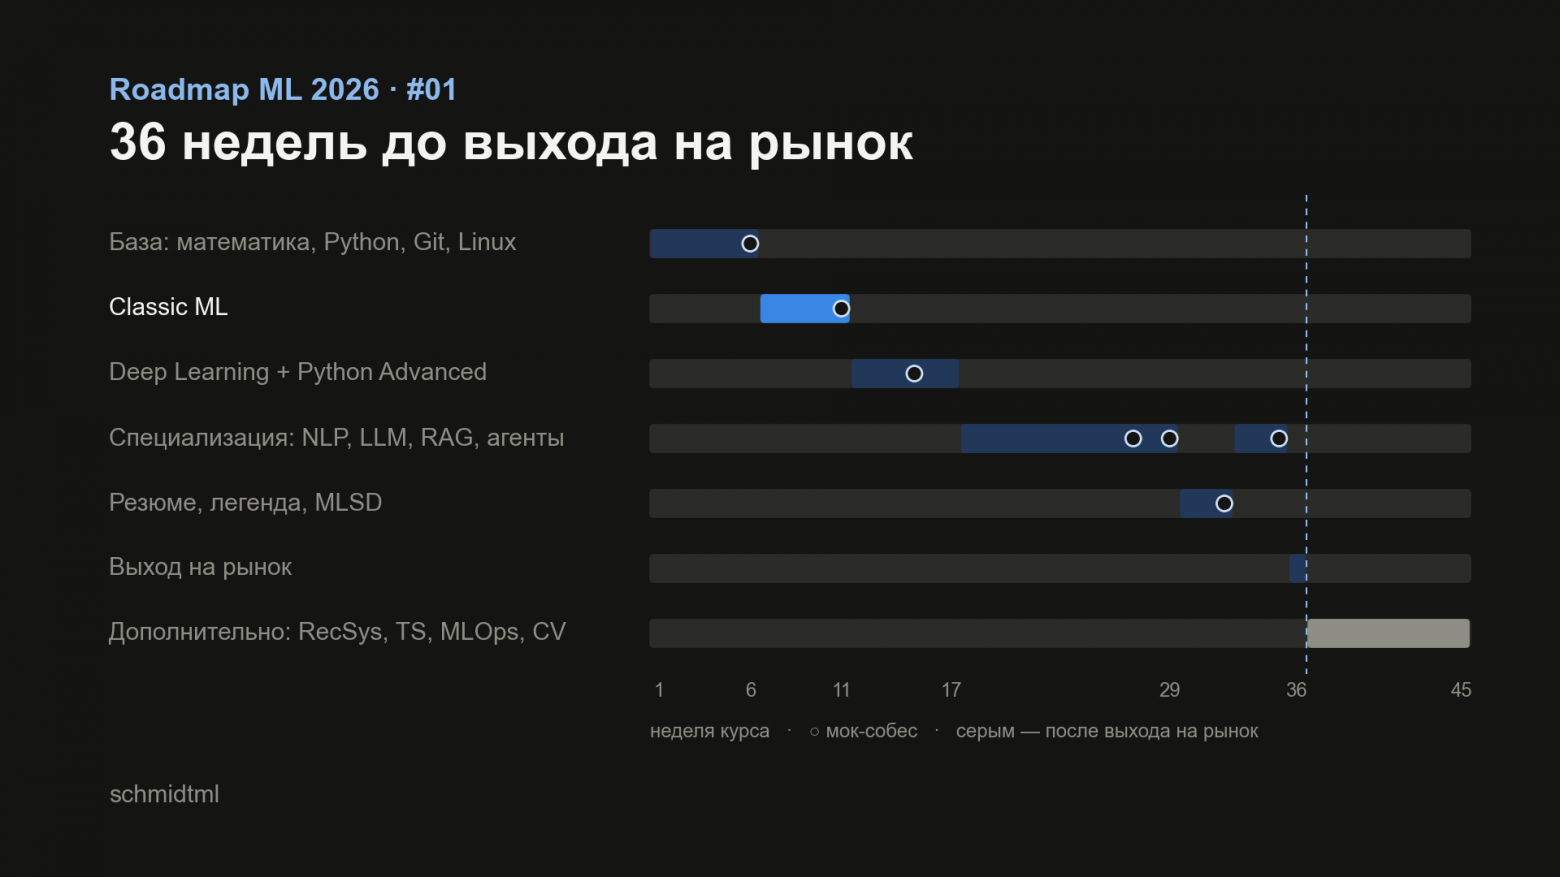
Недели 7–11. Модели на табличных данных: регрессия, классификация, кластеризация, деревья, бэггинг, бустинг. Вопросы по Classic ML на реальных собеседованиях встречаются очень часто: любят спрашивать про различия метрик и лоссов для классификации и регрессии, про бэггинг и бустинг и многое другое. А по моему опыту, большая часть задач в бизнесе — табличные.
Classic ML — шесть блоков. Идём строго по порядку: каждый опирается на предыдущий.
|
Неделя |
Блок |
Ключевые темы |
|---|---|---|
|
7 |
Постановка задачи и метрики |
Обучение с учителем, классификация и регрессия, функции потерь и эмпирический риск, метрики бинарной и многоклассовой классификации, метрики регрессии |
|
8 |
Валидация |
Кросс-валидация, стратификация, k-Fold, train/validation/test, bias-variance, регуляризация, EDA, предобработка и кодирование признаков, пайплайн классической модели |
|
8 |
Линейные модели и деревья |
Логистическая регрессия, решающие деревья, критерии ветвления, регуляризация деревьев, bagging |
|
9 |
Ансамбли |
Random Forest, градиентный бустинг, XGBoost / CatBoost / LightGBM, stacking и blending |
|
9 |
Кластеризация |
Метрики кластеризации, KMeans, DBSCAN, иерархическая кластеризация, KNN |
|
10 |
Понижение размерности и финальный блок |
Наивный Байес, SVM, PCA, t-SNE, UMAP |
Первое, что нужно разложить по полочкам, — разница между функцией потерь и метрикой. Loss оптимизирует модель. Метрика отвечает на вопрос, насколько хорошо модель работает для человека или бизнеса. Для любой задачи вы должны уметь назвать: что здесь объект, что таргет, какие признаки, какой loss и какая метрика.
Минимум по Classic ML:
-
Честная валидация: кросс-валидация, стратификация, отложенная выборка — и главный вопрос: где может возникнуть утечка данных (leakage) и чем она плоха;
-
bias-variance: почему модель переобучается и как это заметить;
-
разница между бэггингом, бустингом и стекингом;
Вы освоили Classic ML, если можете пройти кейс на примерах задач классификации, регрессии или кластеризации на табличных данных целиком — от сырых данных до выбранной модели и метрик — и объяснить, почему ваша схема валидации честная.
Этап 3. Deep Learning и Python Advanced
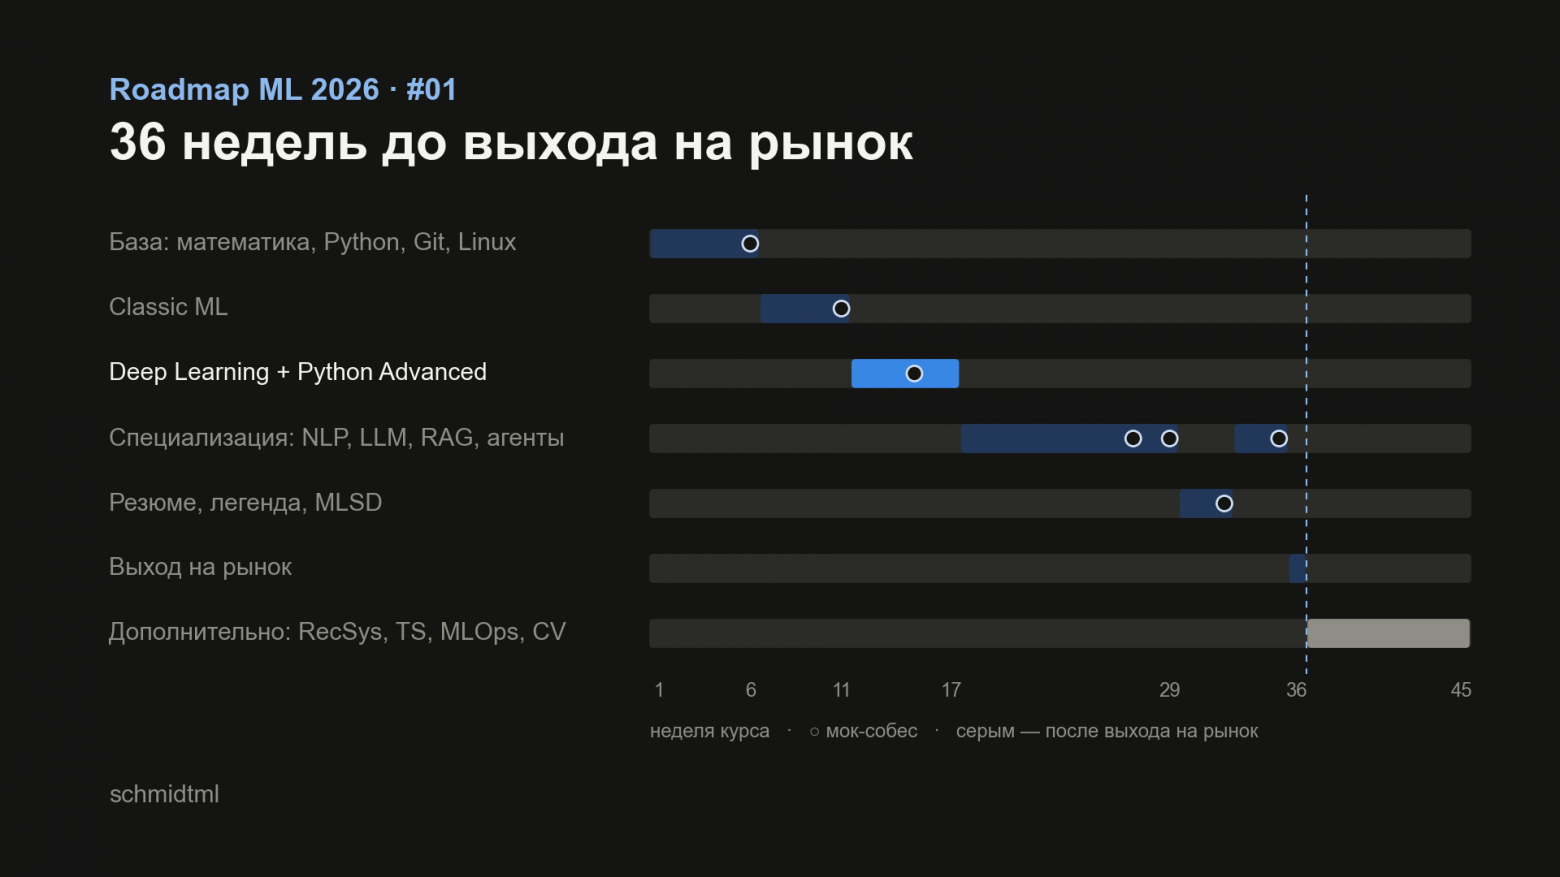
Недели 12–15 — Deep Learning, параллельно доделываем Linux и GitHub. Недели 16–17 — продвинутый Python.
Часть алгоритмов из Classic ML здесь приобретает другую окраску, плюс появляются понятия, которые сейчас постоянно используются и на работе, и на собеседованиях.
|
Неделя |
Блок |
Ключевые темы |
|---|---|---|
|
12 |
Оптимизаторы |
Перцептрон, функции активации, прямой и обратный проход, SGD, Momentum, AdaGrad, RMSProp, Adam, AdamW |
|
13 |
Гиперпараметры и инициализация |
Переобучение и недообучение, инициализация весов, fine-tuning, warm-up и schedulers, data drift и concept drift |
|
13 |
Регуляризация |
Batch Normalization, Dropout |
|
13 |
Свёрточные и рекуррентные сети |
Свёртка, pooling, взрыв и затухание градиентов, остаточные связи, RNN / LSTM / GRU, обучение на одной и нескольких GPU, экономия видеопамяти |
|
14 |
Механизм внимания |
Эмбеддинги, attention, self-/cross-/multi-head attention, causal и masked attention, сложность внимания |
|
14 |
Трансформеры |
Архитектура, позиционное кодирование, encoder-only и decoder-only модели, Pre-Norm vs Post-Norm, увеличение контекста |
Минимум здесь такой:
-
как сеть учится: обратное распространение ошибки и оптимизаторы;
-
почему она переобучается и что с этим делать;
-
и главное — attention и трансформер. На трансформере построены почти все современные языковые модели, поэтому, по моему мнению, это самый важный блок этапа. Его обязательно спросят на собеседовании, и он обязательно встретится на работе.
Проверка этапа — мок-собеседование по Deep Learning на 15-й неделе. Не прошли с первого раза — это нормально: разбираем ошибки и пересдаём.
Почему Python Advanced стоит именно здесь
Недели 16–17: память и конкурентность (сборщик мусора, GIL, threading, multiprocessing, async), ООП и типизация (abc, dataclass, Pydantic), профилирование, линтеры, виртуальные окружения.
После Deep Learning кода становится больше, и писать его нужно как инженер, а не как студент. Нейросети обычно учатся долго, и в процессе случается всякое: утекает или переполняется память, обработка данных идёт слишком медленно. Нужно понимать, где в коде узкие места, как их отследить и по возможности оптимизировать.
Этап 4. Специализация: NLP, LLM, RAG, агенты
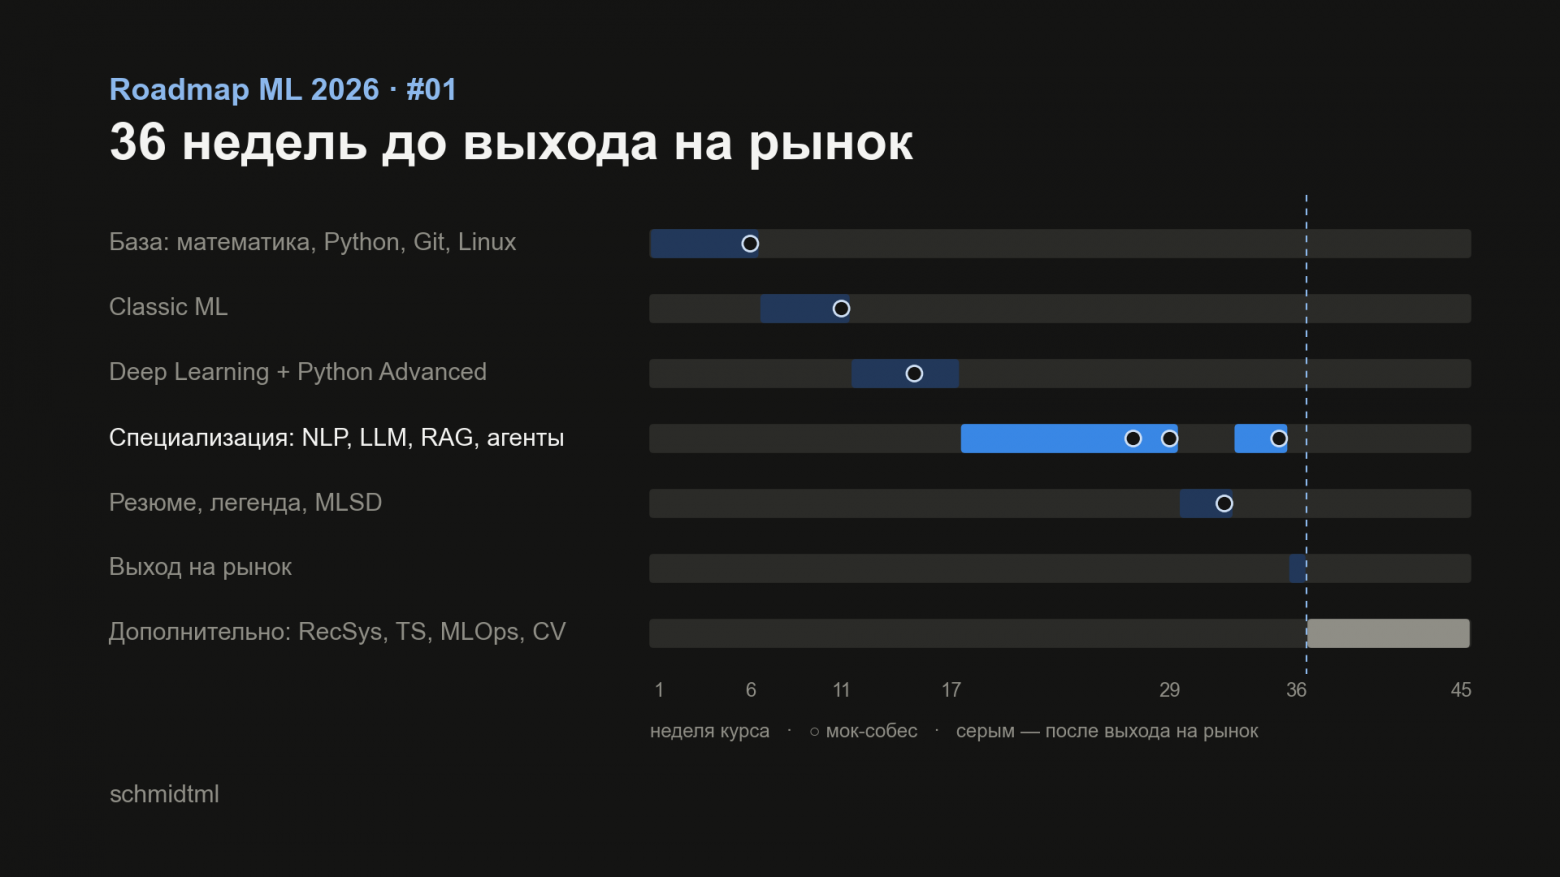
Здесь вы выбираете одно направление: NLP, компьютерное зрение, рекомендательные системы или MLOps. В базовом плане это NLP и большие языковые модели — по моему мнению, в 2026 году на них самый большой спрос.
NLP-трек занимает недели 18–35 — это самый длинный этап, потому что материала очень много:
|
Недели |
Трек |
Что внутри |
|---|---|---|
|
18–21 |
NLP Base |
Как превратить текст в числа: Bag of Words, TF-IDF, BM25 |
|
21–22 |
Инструменты |
Docker, GitHub Advanced, GitHub Workflow (CI) |
|
23 |
NLP Advanced и обзор LLM |
MQA/GQA, RoPE, RMSNorm, MoE; обзор семейств моделей — Llama, Qwen, Mistral, DeepSeek и других |
|
24–26 |
Оптимизация LLM |
Дистилляция, квантизация (GPTQ, AWQ, GGUF), speculative decoding, continuous batching, KV-cache, LoRA и QLoRA, Flash и Paged Attention |
|
27 |
Мок-собеседование |
NLP Base / Advanced / Optimization |
|
28–29 |
RAG + мок |
Чанки, загрузка документов, векторный поиск и векторные базы, выбор эмбеддеров, гибридный поиск, reranker, метрики RAG |
|
33–35 |
Агенты + мок |
Structured Output, tool calling, ReAct, LangChain / LangGraph / LlamaIndex, observability, мультиагентные системы, MCP, память, prompt и context engineering |


Оптимизация LLM — проще говоря, как запустить большую модель дешевле и быстрее. По моему опыту, это спрашивают далеко не на каждом LLM-собеседовании. Но пропускать раздел целиком не стоит: базовые термины вроде квантизации, KV-cache и LoRA с большой вероятностью спросят на интервью.
Если сроки сильно поджимают, раздел оптимизации можно оставить на потом.
RAG — когда модель отвечает не «из головы», не из того, чему она научилась, а по вашим документам: нарезка на чанки, векторные базы, гибридный поиск.
Агенты — когда модель сама вызывает инструменты: tool calling, скиллы, MCP, фреймворки, наблюдаемость, мультиагентность, работа с памятью и контекстом. Сейчас это очень популярная тема: много позиций связано именно с разработкой агентных и мультиагентных систем.
Docker и продвинутый GitHub стоят посередине NLP, на неделях 21–22. Это нужно, чтобы ваши проекты можно было запустить на любой машине и показать работодателю, передать другим командам на тестирование и так далее.
Если вам ближе другое направление — компьютерное зрение, рекомендательные системы, временные ряды или MLOps, — они тоже есть в плане, дополнительными неделями 37–45. Про каждое будет отдельный выпуск серии.
Проверки на этом этапе — три мок-собеседования: на 27-й неделе по NLP, на 29-й по RAG и на 35-й по агентам.
Этап 5. Резюме, легенда, ML System Design
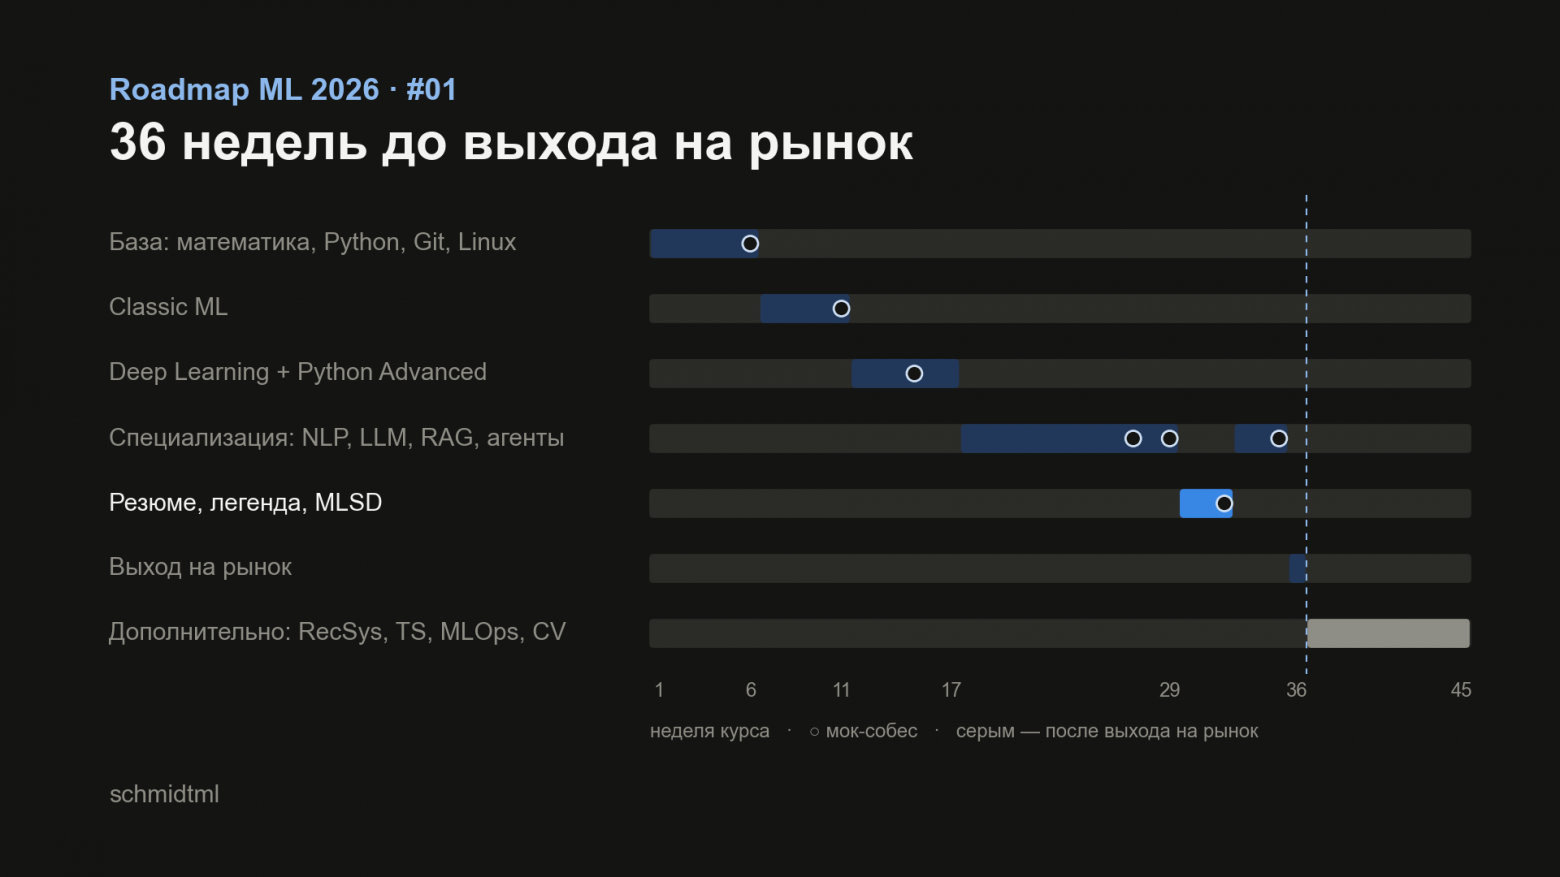
Обратите внимание: в плане резюме стоит на 30-й неделе — ещё до агентов, а не в самом конце. Упаковываться вы начинаете, пока доучиваетесь.
Упаковка — это резюме, легенда, ML System Design, поиск вакансий и даже подготовка к испытательному сроку. Легенда — это, по сути, убедительный нарратив о вашем профессиональном опыте.
-
Неделя 30 — резюме и легенда.
-
Неделя 31 — ML System Design по проектам из вашего резюме. То есть: как бы вы спроектировали систему, о которой рассказываете на собеседовании. По моему опыту, такие вопросы задают и джунам, и миддлам, и особенно синьорам.
-
Неделя 32 — мок-собеседование: резюме, легенда и MLSD.
Этап 6. Выход на рынок
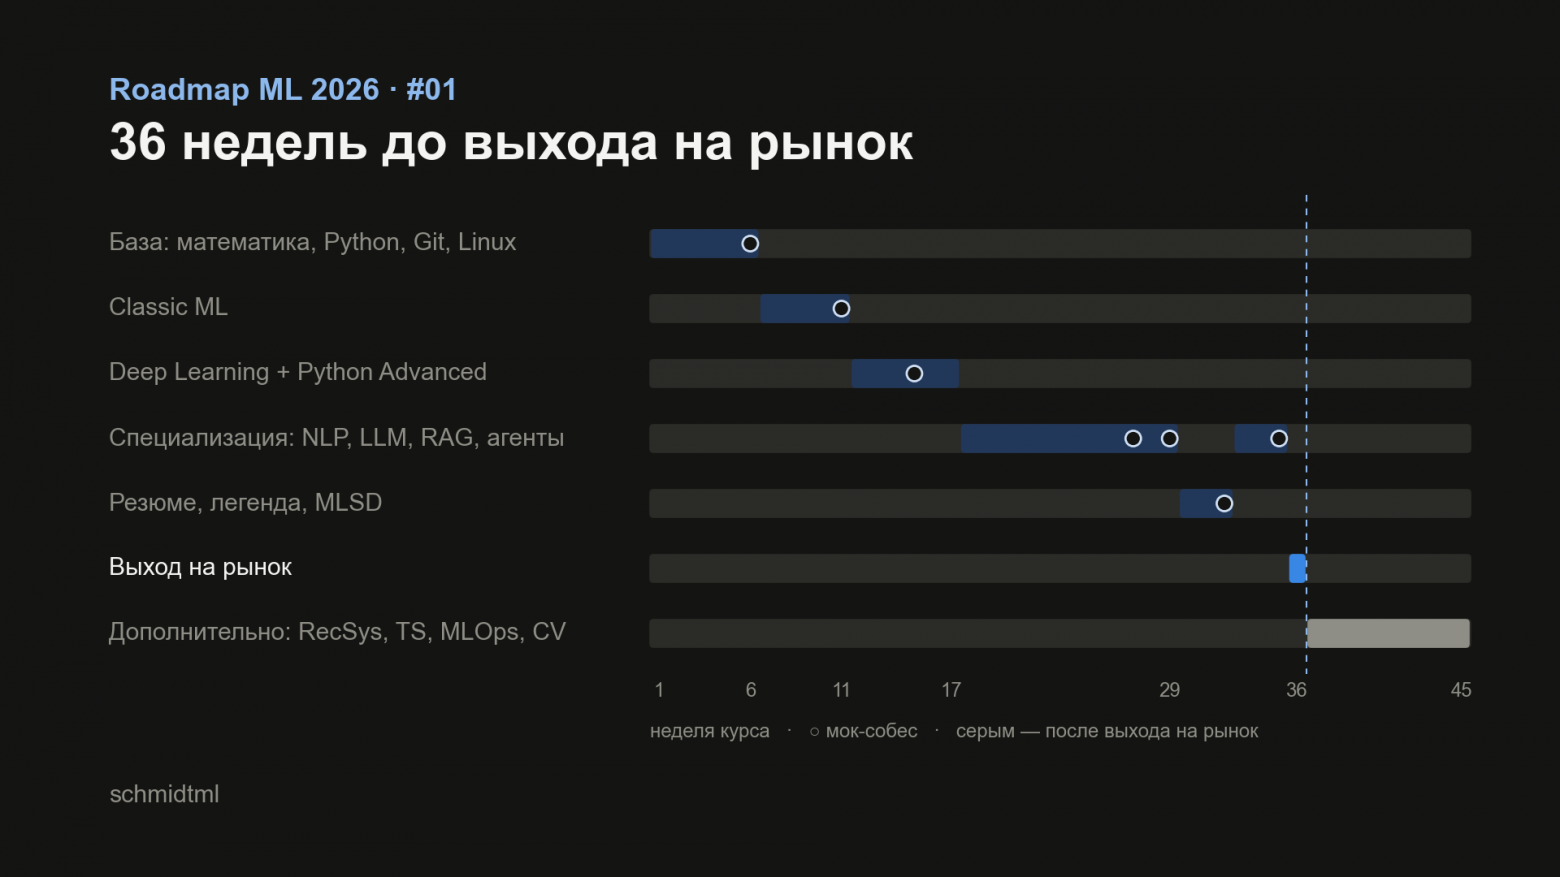
Неделя 36 — то, ради чего всё затевалось. HeadHunter, LinkedIn и другие площадки с вакансиями, вопросы по конкретным компаниям, алгоритмические задачи, вопросы HR, вопросы, которые стоит задать интервьюеру в начале и в конце собеседования, роли в Data и ML, словарь IT-сленга — и даже как оформить ИП или самозанятость.
И важно: оффер — это не финиш. За ним ещё испытательный срок — это тоже часть пути, и к нему тоже нужно готовиться.
Весь план по неделям
|
Неделя |
Что делаем |
Часов |
Мок |
|---|---|---|---|
|
1 |
Старт: математика, Python и GitHub |
20 |
|
|
2 |
Математика, Python и GitHub Base |
20 |
|
|
3 |
Математика, Python и Linux |
17 |
|
|
4 |
Завершение Python Base и математики |
20 |
|
|
5 |
Python Algorithms: сложность и типовые подходы |
20 |
|
|
6 |
Подготовка к мок-собесу |
10 |
Python |
|
7 |
Classic ML: постановка задачи, losses и метрики |
18 |
|
|
8 |
Classic ML: валидация, табличный pipeline и деревья |
24 |
|
|
9 |
Classic ML: ансамбли и кластеризация |
24 |
|
|
10 |
Classic ML: финальный блок |
7 |
|
|
11 |
Подготовка к мок-собесу |
10 |
Classic ML |
|
12 |
Deep Learning: оптимизаторы |
20 |
|
|
13 |
DL, Python Advanced и GitHub |
20 |
|
|
14 |
DL: attention, трансформеры и генеративные модели |
18 |
|
|
15 |
Подготовка к мок-собесу |
10 |
Deep Learning |
|
16 |
Python Advanced: память и конкурентность |
20 |
|
|
17 |
Python Advanced: ООП, типизация и профилирование |
20 |
|
|
18 |
NLP Base: классические подходы |
20 |
|
|
19 |
NLP Base: эмбеддинги и нейросетевые подходы |
20 |
|
|
20 |
NLP Base: языковые модели и токенизация |
20 |
|
|
21 |
NLP Base: BERT/GPT, GitHub Workflow и Docker |
20 |
|
|
22 |
Инструменты: Docker и GitHub Advanced |
24 |
|
|
23 |
NLP Advanced и обзор LLM |
24 |
|
|
24 |
Оптимизация LLM I |
20 |
|
|
25 |
Оптимизация LLM II |
20 |
|
|
26 |
Оптимизация LLM III |
20 |
|
|
27 |
Подготовка к мок-собесу |
10 |
NLP Base / Advanced / Optimization |
|
28 |
RAG |
20 |
|
|
29 |
Подготовка к мок-собесу |
10 |
RAG |
|
30 |
Резюме и легенда |
20 |
|
|
31 |
MLSD по проектам из резюме |
20 |
|
|
32 |
Подготовка к мок-собесу |
10 |
Резюме, легенда, MLSD |
|
33 |
Агенты I |
20 |
|
|
34 |
Агенты II: память, промптинг и фреймворки |
20 |
|
|
35 |
Подготовка к мок-собесу |
10 |
Агенты |
|
36 |
Выход на рынок: профили, площадки, подготовка к собеседованиям |
20 |
|
|
|
Итого обязательная часть |
646 |
7 |
|
37 |
Дополнительно: рекомендательные системы |
18 |
|
|
38 |
Дополнительно: временные ряды |
12 |
|
|
39 |
Дополнительно: MLOps — Kubernetes и Kafka |
16 |
|
|
40 |
Дополнительно: MLOps — облака и базы данных |
16 |
|
|
41 |
Дополнительно: MLOps — трекинг экспериментов (MLflow, W&B, ClearML, TensorBoard) |
14 |
|
|
42 |
Дополнительно: MLOps — мониторинг (Prometheus, Grafana) |
12 |
|
|
43 |
Дополнительно: классическое CV |
16 |
|
|
44 |
Дополнительно: CV на Deep Learning — задачи и метрики |
18 |
|
|
45 |
Дополнительно: CV на Deep Learning — генерация, мультимодальность, архитектуры |
18 |
|
Правило первого прохода: что отложить
Главное правило, чтобы не утонуть в материале: при первом проходе учите только ядро — обязательный минимум каждой темы. Всё углублённое, дополнительное и исследовательское пропускайте и возвращайтесь к этому потом. В моём роадмапе такой фильтр отсекает больше двухсот тем из 789 — и все они спокойно могут подождать.
Что можно отложить до первого оффера — в плане это недели 37–45:
-
рекомендательные системы;
-
временные ряды;
-
MLOps дальше Docker — Kubernetes, Kafka, облака, трекинг экспериментов, мониторинг;
-
компьютерное зрение, если вы идёте в NLP.
Что важно именно в 2026 году:
-
LLM, RAG и агенты — они уже в обязательной части плана;
-
Docker и Git — тоже; полезно понимать и остальные части из раздела MLOps: как проводить трекинг экспериментов (MLflow), мониторинг моделей в продакшене (Loki, Grafana, Prometheus); Linux — основные команды (
nvidia-smi,htop,tmux,screen) -
английский — с первого дня, если вы целитесь в зарубежные компании. Для устройства в СНГ учить английский дополнительно не обязательно. Если с ним всё в порядке, дополнительно учить его не стоит — но очень полезно пройти несколько мок-собеседований на английском (если целитесь на зарубежную работу).
По возможности проводите мок-собеседования (пробные собеседования) со своими друзьями/знакомыми/товарищами, которые уже находятся в сфере ML. Обычно все на это охотно соглашаются — и вам помочь, и самим вспомнить детали из собеседований, потренироваться.
Если таких знакомых не имеется, можно походить по различным IT-сообществам и поспрашивать у людей, кто готов на такой пробный собес (например, better data community, ods.ai, rockaux — и любые другие)
Три частые ошибки
Вот, что я чаще всего вижу у учеников:
-
Учить всё подряд. Человек в первый же проход лезет в углублённые темы — и через месяц всё ещё сидит в матанализе.
-
Учиться без проверки. Пока не отвечаешь вслух, кажется, что всё понятно. Мок-собеседование быстро показывает, где остались трудности.
-
Откладывать английский «на потом». Из тех, кто хочет в зарубежную компанию, свободно говорят меньше половины. Качайте английский параллельно с ML с первого дня.
-
Излишне детально изучать отдельные темы. Может появиться соблазн углубиться в определенные темы за подробностями, которые могут завлечь и увести далеко в ненужную сторону. Чтобы не тратить драгоценное время, рекомендую впитывать лишь 70-80% верхнего слоя материала, чтобы не тратить большую часть усилий на оставшиеся 30-20%, которые не принесут особой пользы. Можно будет вернуться к этим деталям, если очень хочется, позже, после устройства.
Как понять, куда углубляться, а какие темы можно пропустить? Для этого можете воспользоваться настоящим roadmap-ом. Он отсечет лишние пути, способные увести в дебри и украсть много вашего времени без особого профита на пути в освоении ML и получении оффера.
Как тренироваться
Проверяйте себя не чтением, а делом:
-
решайте задачи по каждой теме. Практические задачки можно генерировать нейросетью — ChatGPT, Claude и другими;
-
собирайте небольшие проекты на реальных данных. В открытом доступе полно датасетов, на которых можно обучить модели для классификации, регрессии, кластеризации и других задач;
-
регулярно устраивайте мок-собеседования — с друзьями, которые тоже переходят в ML, или попросите знакомого ML-щика погонять вас по самым частым вопросам.
И главный совет: проговаривайте решения вслух. В задачах по Python: идея  сложность
 крайние случаи — и только потом код. В ML-задачах: почему выбрана именно эта модель, какие у неё плюсы и минусы, с какими данными вы работаете, какую задачу решаете, какие метрики выбрали. Вы должны уметь интерпретировать своё решение.
Зачастую это важнее, чем умение написать весь код с нуля с закрытыми глазами. Код сегодня почти все пишут с нейронками — компании могут даже выдать вам оплачиваемую подписку на Codex, Cursor или Claude. А вот понимание, что и почему вы делаете, по-прежнему проверяют на собеседовании.
Итог
База  Classic ML
 Deep Learning
 специализация
 резюме и MLSD
 выход на рынок. 36 недель, если идти по плану, около 18 часов в неделю и 7 мок-собеседований по дороге.
Это первый выпуск серии «Roadmap ML 2026». Дальше будут отдельные разборы по NLP и большим языковым моделям, RAG и агентам, компьютерному зрению, рекомендательным системам, временным рядам, MLOps — и отдельно про выход на рынок.
-
Видео-версия этого роадмапа: YouTube
-
Интерактивная карта со всеми темами и неделями лежит в моём Telegram-канале в этом посте
Что дальше?
Чтобы сэкономить время и не утонуть в материале, можно написать мне в Telegram — вместе определим ваш уровень и составим план под ваш старт. Подробнее — в профиле.
Есть вопросы?
Пишите в комментариях: на каком вы сейчас этапе и сколько часов в неделю готовы учиться? И какой раздел роадмапа разобрать подробнее в следующих статьях? Спасибо!
Автор: versechorus

