


Полный перевод эссе The Decoherence Trap. Авторский текст опубликован под лицензией CC BY 4.0. В русской версии переведены текст и надписи на схемах, а интерактивные иллюстрации адаптированы для статичного просмотра. Авторский текст не сокращён.
Примечание переводчика. Первое лицо и оценки в основном тексте принадлежат автору. Подписи под иллюстрациями, пояснения к статичной версии и явно обозначенные примечания добавлены при подготовке перевода.
Коротко
В этом эссе я ввожу понятие декогеренции, то есть накопления в системе моделей, которые по отдельности вполне работоспособны, но несовместимы друг с другом или дублируют друг друга. В такой системе основные затраты на изменения приходятся на согласование этих моделей и предотвращение непредвиденных побочных эффектов.
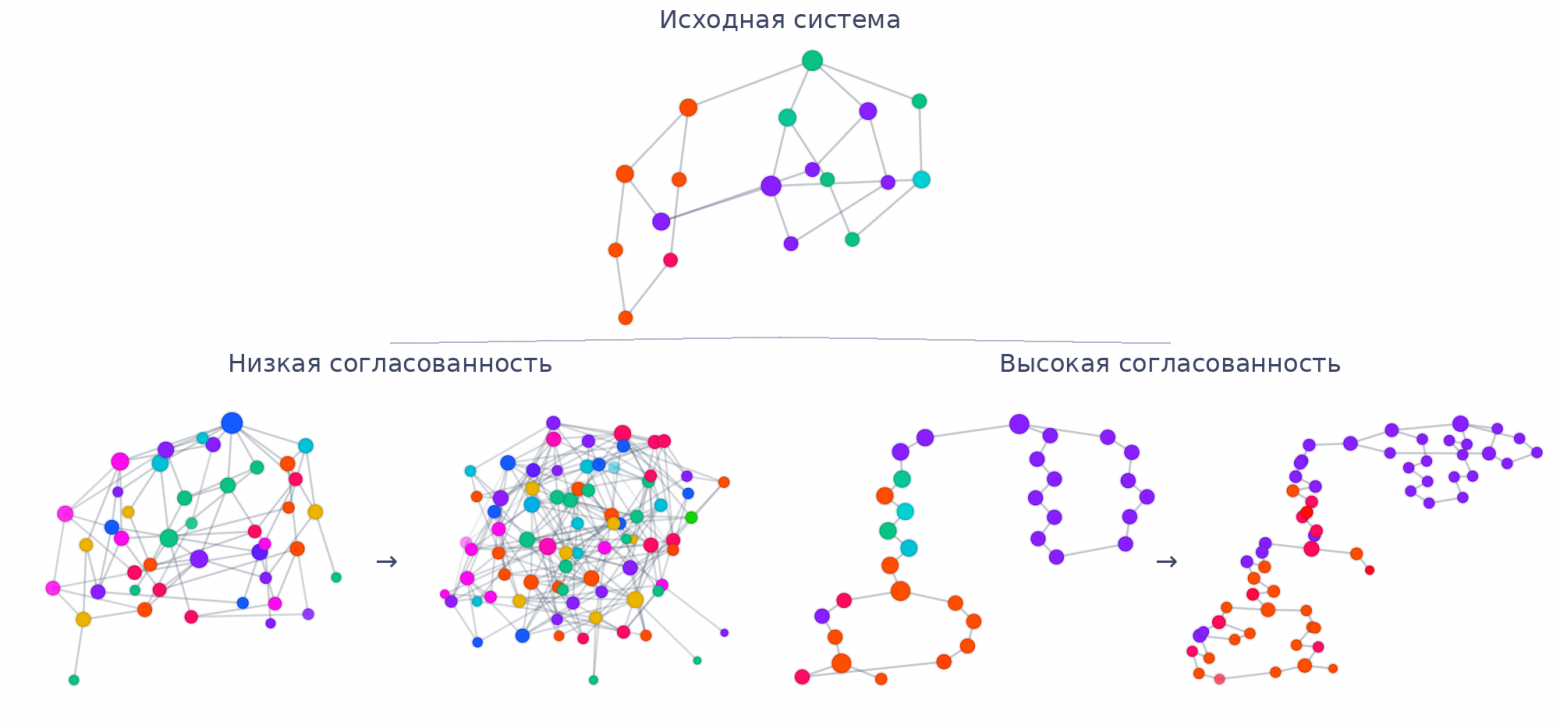
Два направления развития одной системы. Слева нарастает декогеренция, справа сохраняется согласованность. Статичная композиция исходных схем автора.
Иными словами, это то, что происходит, когда низкопробная мешанина заглушает полезный сигнал в бескрайнем море шума.
Декогеренция нарастает тем быстрее, чем быстрее меняется система, а чем меньше в ней согласованности, тем сильнее ускоряется этот процесс. Так возникает неуправляемый экспоненциальный рост. Явление это не новое. Люди всегда противостояли ему, вдумчиво ища способы добиваться большего меньшими средствами и объединяя разрозненные подходы и модели в связное целое. Однако повсеместное использование ИИ сейчас порождает декогеренцию с такой скоростью, что долго так продолжаться не может.
Хорошая новость в том, что это исключает пугающий сценарий неуправляемого рекурсивного самосовершенствования, того самого взрыва интеллекта, при котором кривая роста взмывает вверх раньше, чем кто‑нибудь успевает отреагировать. Декогеренция не даёт ИИ совершенствоваться в изолированном «пузыре» и ограничивает скорость его развития за пределами этого пузыря. Плохая новость в том, что мы на всех парах несёмся к другой катастрофе, декогеренционному коллапсу.
Представьте здание, скажем небольшой офисный центр. При строительстве в нём использовали трубы, которые со временем изнашиваются и в конце концов требуют замены. Это обычный инфраструктурный долг, или, как принято говорить, естественный износ.
Теперь предположим, что к моменту замены труб вам нужно перейти на новый стандарт. Возможно, изменились строительные нормы, старые трубы просто перестали выпускать или новые оказались намного лучше и удобнее в обслуживании. Это обычный долг, связанный с развитием технологий, который возникает из‑за необходимости обновляться и переходить на новые решения по мере технического прогресса.
Есть и третий вид долга, который может возникнуть в зависимости от того, как именно вы переходите от старых труб к новым. Рассмотрим следующие варианты.
-
Закрыть здание и заменить все трубы сразу. Это дорогой способ, который серьёзно нарушает привычную работу, поскольку пользоваться зданием во время ремонта нельзя, а всю замену нужно оплатить сразу. Зато к концу ремонта переход будет полностью завершён.
-
Закрывать этажи по очереди и менять трубы на каждом из них. В целом это меньше мешает работе, но обходится несколько дороже, потому что платить всё равно нужно заранее, а поддержание нормальной работы здания во время ремонта требует дополнительных затрат на труд.
-
Менять трубы по мере необходимости, когда они начинают выходить из строя. Этот вариант мешает меньше всего и позволяет распределить затраты во времени, заменяя всю систему постепенно, одним небольшим ремонтом за другим.
Большинству людей третий вариант кажется очень привлекательным. Он позволяет поддерживать нормальную работу и растянуть расходы на обслуживание. И если можно поступить как с кораблём Тесея [1] и менять трубы по одной, почему бы так и не сделать?
Ну, хотя бы потому, что это создаёт декогеренцию.
А декогеренция — с большим отрывом худший вид технического долга.
Эволюция
Корабль Тесея как раз помогает понять истинный масштаб декогеренции. Мы умеем строить деревянные корабли и умеем строить стальные. Если чинить судно по одной детали, используя тот же материал, как в исходном мысленном эксперименте, оно останется работоспособным, а все заложенные в него конструктивные решения сохранятся.
Но умеем ли мы строить все промежуточные варианты между деревянным кораблём и стальным? Можно ли, например, постепенно заменяя детали парусного военного корабля, превратить его в современный эсминец? Причём так, чтобы на каждом шаге он оставался работоспособным, хотя бы в каком‑то смысле этого слова?
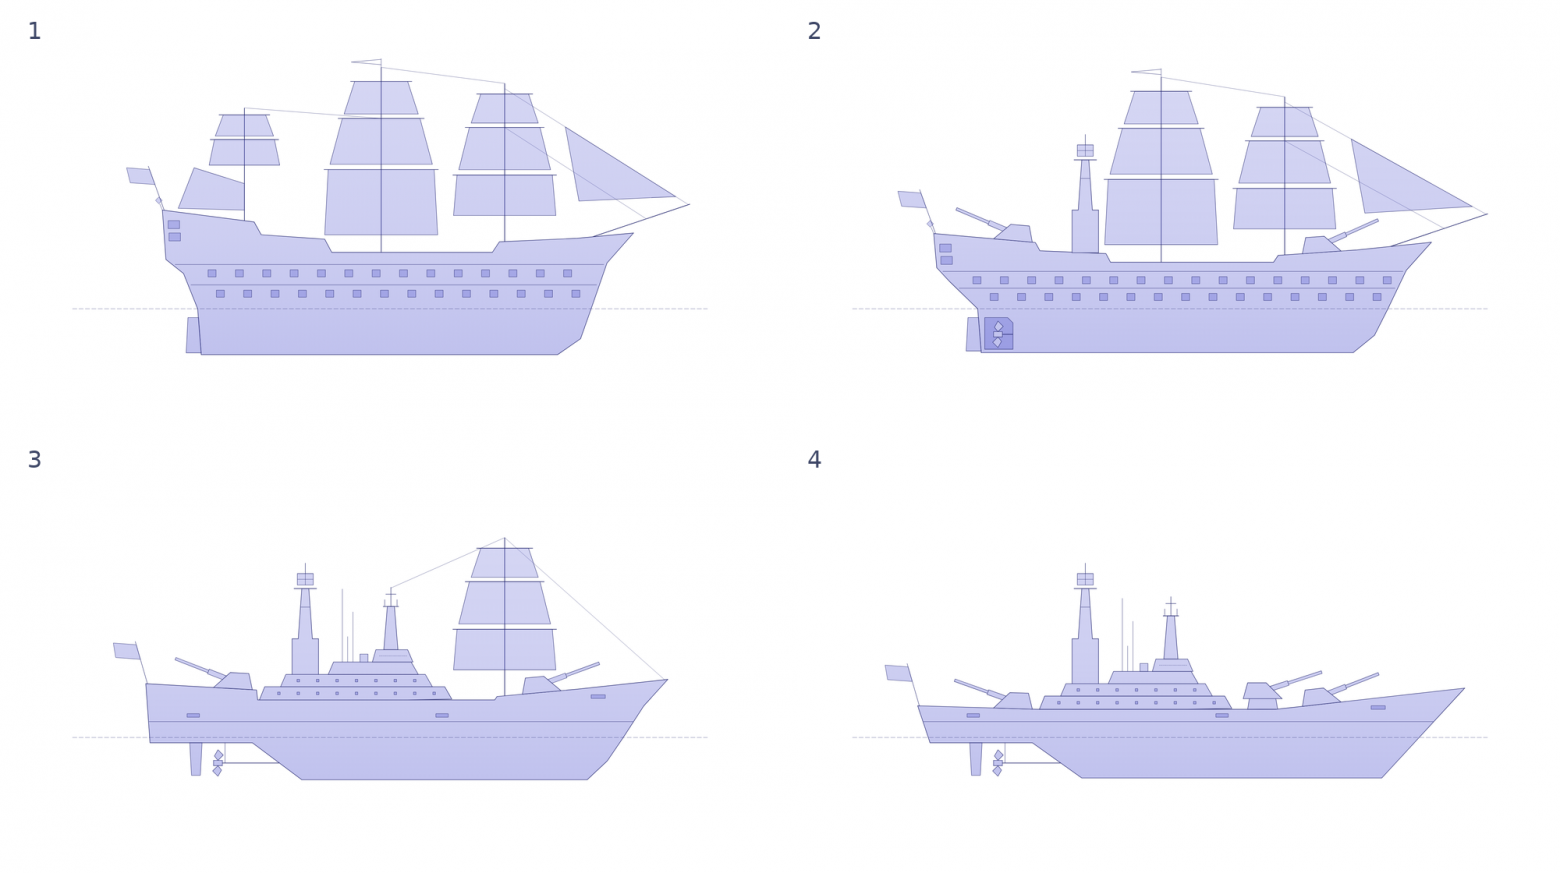
Исходный корабль Тесея, промежуточные гибриды и конечная конструкция. Четыре иллюстрации оригинала собраны в одну последовательность.
Не скажу, что ответом будет безоговорочное «нет». Если проявить достаточно фантазии и привлечь лучшие умы, какой‑нибудь путь, я уверена, найдётся. Но это потребует изобретательности, навыков и мастерства. Потребует внимания к деталям. И, что особенно важно, вам наверняка захочется довести переход до конца, потому что судно, наполовину оставшееся парусным военным кораблём и наполовину ставшее эсминцем, в современном бою, скорее всего, проявит себя не лучшим образом.
Вернёмся к трубам. В строительстве эта стратегия встречается постоянно. Когда труба лопается, вызывают сантехника, вскрывают стену, подбирают решение для конкретного участка, а затем всё снова заделывают. Если повезёт, сантехник оставит подробные записи. Если не повезёт, через несколько лет какой‑нибудь бедолага вскроет эту стену и спросит себя: «Что здесь, чёрт возьми, происходит?»
Теперь представьте, как всё это повторяется год за годом, пока мы постепенно меняем трубы во всём здании. В результате получится лоскутная смесь старых и новых труб, значительно более сложная, чем каждая из двух систем по отдельности. У каждого стыка, у каждой подогнанной по месту заплатки будет своё уникальное, малоизученное сочетание нагрузок и свойств. Чтобы до конца в нём разобраться и с ним работать, нужен специалист, знающий обе системы.
На первый взгляд всё нормально. Трубы работают, какая разница, как именно? Если заплатка хорошая, кому какое дело?
А что произойдёт, если мы захотим, например, построить пристройку?
В рамках мысленного эксперимента допустим, что воду в пристройку нужно подвести через часть уже существующего здания, используя имеющиеся трубы. И, что особенно важно, для этого придётся повысить давление воды во всей системе.
Возникает вопрос: безопасно ли повышать давление?
Если бы все трубы относились к типу A или к типу B, даже после многократных ремонтов и замен отдельных участков ответить было бы несложно. Обе системы хорошо изучены, для обеих есть инструменты и методики расчёта допустимых нагрузок, и люди постоянно выполняют такие расчёты.
Но если перед нами неизвестная смесь двух систем, для ответа внезапно требуется намного более глубокий анализ. Любая заплатка способна изменить результат, даже на противоположном конце здания, ведь всё взаимосвязано.
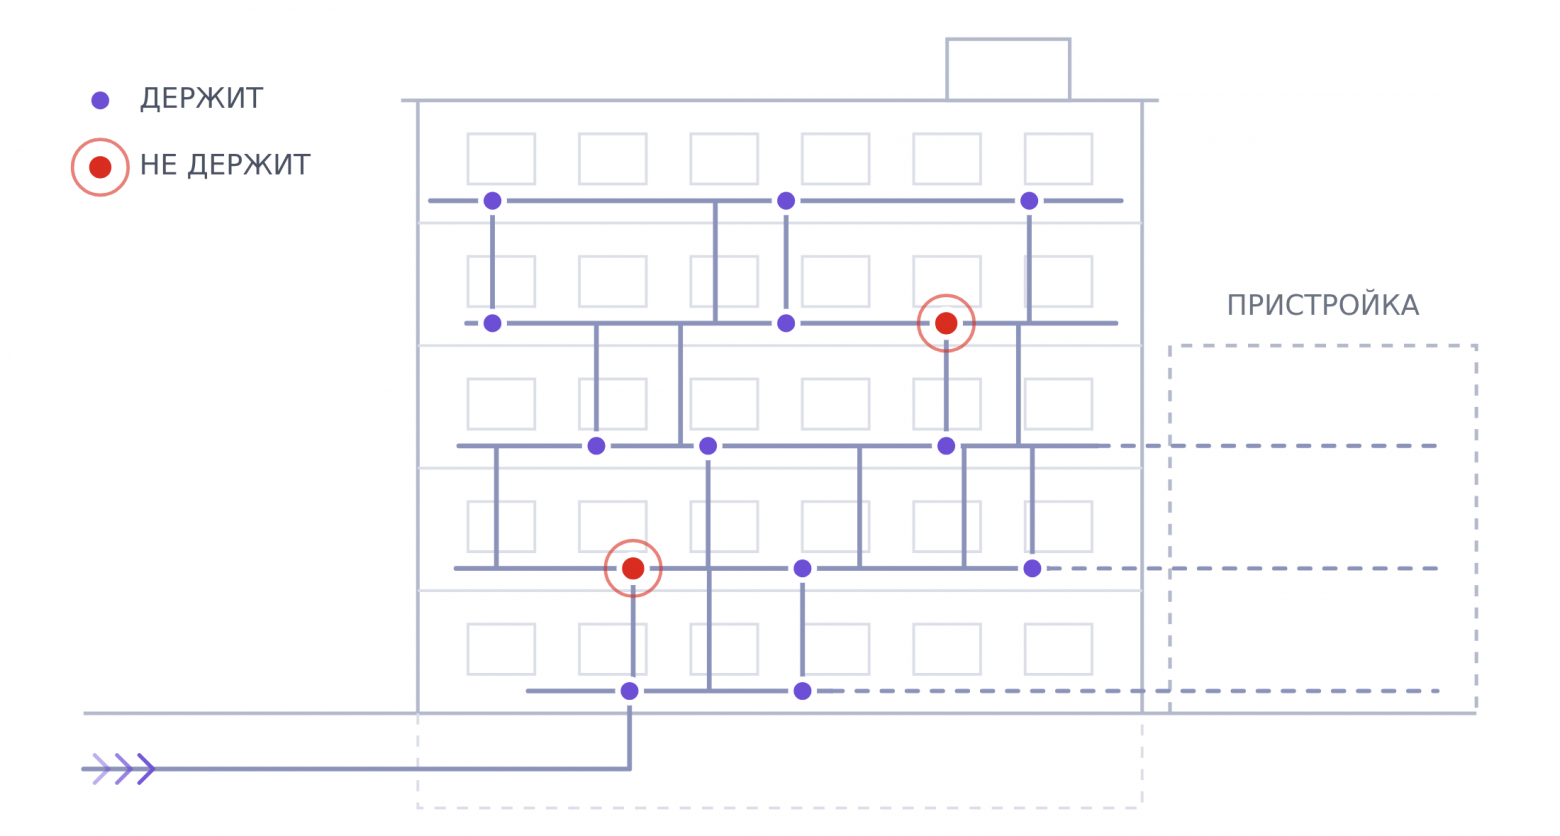
Увеличение давления затрагивает всю систему. Нестандартные стыки между разными типами труб становятся самостоятельными источниками риска.
Именно здесь становится видна настоящая сложность декогеренции. Чтобы менять рассогласованную систему, нужно гораздо больше знаний и мастерства, чем для работы с каждой из исходных систем по отдельности. Инженеру приходится намного тщательнее прослеживать связи и разбираться в её устройстве, потому что изменения могут иметь непредвиденные последствия. (И да, я считаю сантехников инженерами, уж точно не в меньшей степени, чем разработчиков. Вы видели, как они на ходу разбираются с силами давления в сливных трубах? Впечатляет.)
Это совсем не простая задача, и лучше с ней не торопиться. Но стороннего наблюдателя, который не представляет себе глубину проблемы, такая медлительность может раздражать. Обычно ведь на этом этапе всё легко. Почему в этот раз так долго?
В такой ситуации руководство часто начинает давить на специалиста, требуя закончить быстрее. Но под давлением он не начинает проводить полный анализ быстрее, а просто останавливается раньше и делает то, что, по его убеждению, должно сработать. Не самый аккуратный стык, нестандартная деталь, может быть, дополнительные меры защиты на всякий случай.
Однако недоделанная работа запускает цепную реакцию. Конкретное изменение получается менее качественным и делает систему более хрупкой и сложной. Значит, следующее потребует ещё больше внимания и размышлений, а если давление на инженера останется прежним, он выполнит работу ещё хуже.
Картина уже довольно неприятная, и в ней можно различить своего рода экспоненциальный рост сложности. Но погодите, дальше хуже! Рассмотрим следующий уровень декогеренции, когда второй переход начинают, не закончив первый.
Лабиринт
С программным обеспечением, в отличие от здания или других систем физического мира, есть одна трудность. Оно как бы невидимо.
Программисты каждый день ходят по коридорам кодовых баз. Мы так часто успешно проходим этот лабиринт, что знаем каждый угол и каждый поворот. И когда наши маршруты удлиняются, когда в них становится больше коридоров, тупиков и потайных люков, мы чувствуем это сразу, почти интуитивно.
Лабиринт, по которому разработчик проходит каждый день. Анимация исходной схемы заменена статичным кадром.
Но объяснить это людям, которые даже не видят лабиринта и не ходят по нему вместе с вами каждый день, трудно. Когда приходит время погасить часть техдолга, сделать маршруты короче и менее извилистыми, убедить начальство в необходимости такой работы бывает непросто, даже если руководители когда‑то давно сами бродили по лабиринтам. В конце концов, никто из них не знает вашего лабиринта. Они не знают, с какими испытаниями вы сталкиваетесь всякий раз, когда в него входите.
А вот наш знакомый сантехник может показать владельцу здания абсурдность происходящего с трубами куда нагляднее.
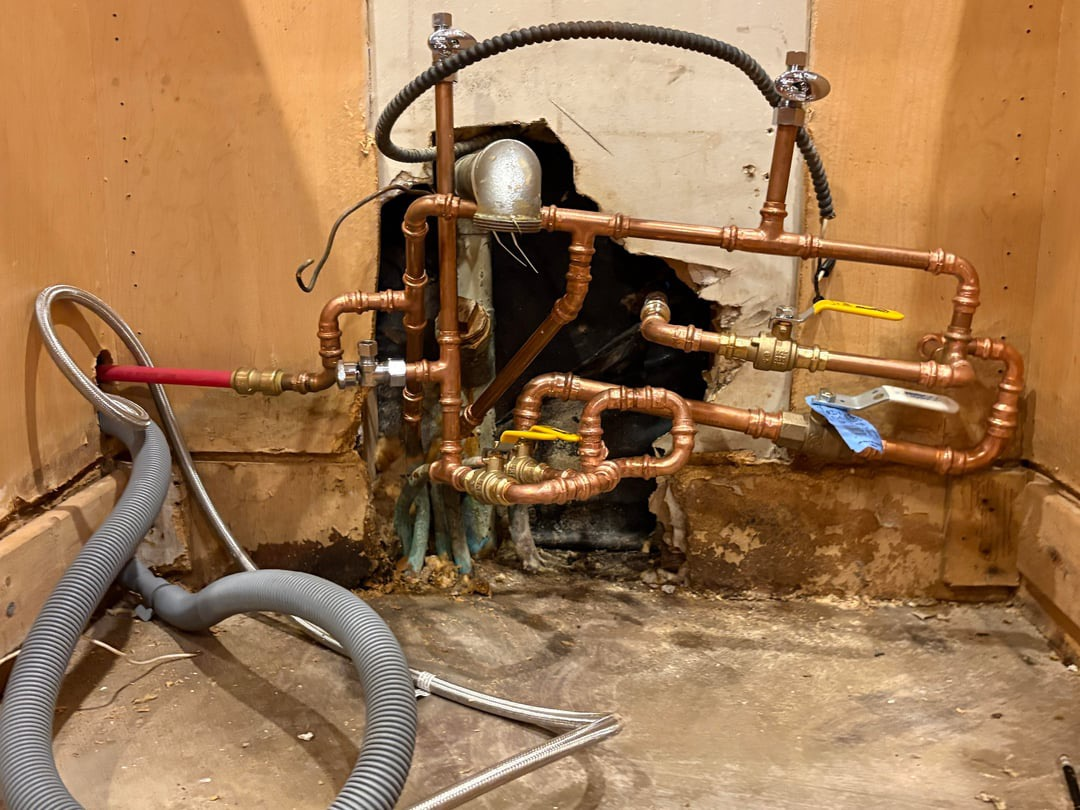
Фотография из r/Plumbing: «Не слишком ли я придираюсь к сантехническим работам в моём новом доме?» [2]
Когда мы начинаем смешивать больше двух систем, хаотично добавляя со временем всё новые заплатки, сложность лабиринта взрывается. Она становится комбинаторной, ведь теперь приходится учитывать A → B, A → C, B → C, A → B → C, C → B → A и так далее.
Конечно, отчасти можно оградить инженеров от этой сложности. Можно выработать лучшие практики, использовать инструменты и фреймворки для изоляции одной части системы от другой (например, поставить в трубы редукционный клапан). Но неизбежно наступает момент, когда даже лучшие инженеры, даже самые умные люди уже не способны безопасно ориентироваться в лабиринте.
Возможно, им это удаётся в 80 или 90 процентах случаев. Но однажды они свернут не туда,
забудут оставить за собой путеводную нить и застрянут
в необъятном лабиринте,
который растёт без конца,
опережая каждый их шаг,
вечно.
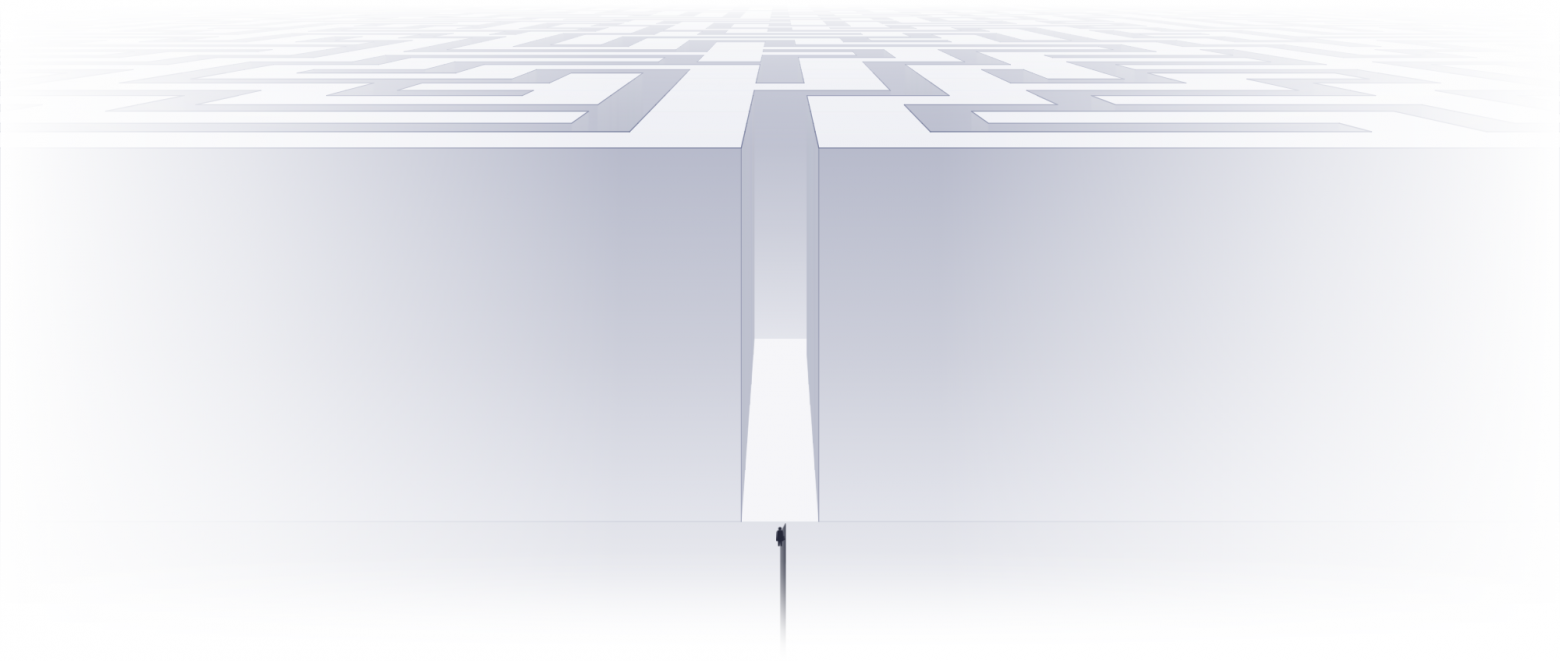
Ловушка декогеренции: система становится слишком большой и запутанной, чтобы её можно было охватить целиком.
Это и есть ловушка декогеренции. Лабиринт растёт и растёт, пока не поглотит вас целиком и не оставит блуждать во тьме. Пока не станет таким огромным, что на его прохождение уйдут целые жизни.
Во всяком случае, человеческие. А как насчёт ИИ?
Симуляция
Люди устают и упираются в физические ограничения, а рои автономных агентов могут работать круглосуточно, сообща и без устали картографируя лабиринт, как и положено послушным маленьким роботам. Если проблема в масштабе, разве нельзя просто добавить вычислительных мощностей и на этом успокоиться?
Всё зависит от того, с какой сложностью мы столкнулись. Как она растёт?
-
Растёт линейно вместе с общим размером кодовой базы?
-
Или растёт экспоненциально, так что каждое изменение повышает вероятность того, что следующее добавит ещё больше сложности?
В первом случае да, по мере роста задачи можно добавлять агентов и дата‑центры и решать её примерно в прежнем темпе. Но во втором дополнительные мощности позволят лишь продвинуться немного дальше, прежде чем лабиринт разрастётся настолько, что пригрозит поглотить все вычислительные ресурсы Земли (и космоса, если планы SpaceX [3] осуществятся).
По моему опыту, верен второй вариант. Когда сантехник вскрывает стену и видит мешанину, ему непонятно, что перед ним. Он может взять трубу типа A, может взять трубу типа B, а может, не разобравшись, добавить вообще новый тип. С кодом это верно в ещё большей степени.
Это можно увидеть в простой симуляции ниже. В ней граф представляет кодовую базу (или другую сложную систему), где:
-
Узлы обозначают компоненты.
-
Размер узла соответствует размеру компонента.
-
Цвет узла показывает преобладающую в нём парадигму, то есть «тип» решения, будь то материал труб, конструкции кода или разновидность системы.
-
Рёбра обозначают связи между компонентами.
Здесь показана запись нескольких запусков. Полную симуляцию, в которой можно менять настройки и наблюдать за результатом, вы найдёте здесь.
Примечание к статичной версии. Веб‑проигрыватель заменён авторскими последовательностями кадров для двух противоположных сценариев; они приведены ниже.
Участник симуляции, представляющий разработчика, реализует «фичу», обходя случайный участок графа и затем изменяя его. Базовое поведение этого разработчика задаёт коэффициент согласованности (coherence factor).
-
Низкий коэффициент означает, что разработчик наскоро разбирается в задаче и принимает решения с ходу. Он предпочитает простые решения, не учитывает окружающий контекст и в целом усложняет граф.
-
Высокий коэффициент означает, что разработчик тратит больше времени и внимательнее обдумывает каждую задачу, поэтому с большей вероятностью вносит менее сложное изменение или даже уменьшает сложность.
Поначалу разработчик с низким коэффициентом продвигается очень быстро по сравнению с более вдумчивым коллегой. Но изменения графа влияют и на его обход. Продвижение замедляют три фактора.
-
Большее число связей у узла (его степень). Чтобы понять влияние соседних узлов на текущий, приходится хотя бы частично учитывать контекст каждого из них, а это дополнительная нагрузка.
-
Переходы между цветами. Переключение между парадигмами при реализации фичи требует дополнительных усилий, поскольку нужно заново разобраться в каждой парадигме и в том, как они связаны.
-
Длина пути. Чем больше связей и переходов, тем выше вероятность, что маршрут придётся продлить. Разработчику нужно читать больше кода и чаще возвращаться к уже просмотренному, чтобы собрать весь необходимый контекст. Путь может расти, пока не охватит всю систему. Иными словами, чтобы изменить хоть что‑нибудь, потребуется понять всё.
Если построить график числа реализованных фич в зависимости от времени и коэффициента согласованности, получится картина со знакомой любому инженеру золотой серединой.
Примечание к статичной версии. Интерактивный график «Золотая середина» доступен в оригинале статьи. Его численная кривая здесь не воспроизведена. Ниже сохранено авторское объяснение трёх режимов работы системы.
В этой золотой середине система относительно согласованна, и мы целенаправленно вкладываемся в то, чтобы она такой оставалась. В ней есть несколько преобладающих парадигм, но достаточно и вариативности, чтобы со временем всё могло меняться и адаптироваться. При этом мы не пытаемся довести до совершенства каждую мелочь.
Выше золотой середины мы прилагаем огромные усилия, чтобы каждый новый узел вписывался в существующие парадигмы, и устраняем сложность при любой возможности. Это требует намного больше времени и замедляет работу над фичами, но даже в худшем случае оставляет нам очень согласованную систему, которую можно относительно быстро развивать дальше.
Ниже золотой середины начинается обрыв. Кодовая база экспоненциально усложняется, и мы очень быстро теряем скорость. Если коэффициент согласованности отрицательный и о поддержании согласованности вообще не заботятся, время выпуска фичи растёт, по‑видимому, без каких‑либо пределов.
Можно также посмотреть, как разные стратегии со временем влияют на систему в зависимости от её исходного состояния. Если начать с очень согласованной системы и выбрать стратегию, преимущественно разрушающую согласованность (коэффициент +0,2, при котором какие‑то усилия по её сохранению всё же предпринимаются, но короткие пути тоже используются), то граф поначалу будет деградировать медленно, а затем пройдёт несколько переломных точек и окажется в ловушке.
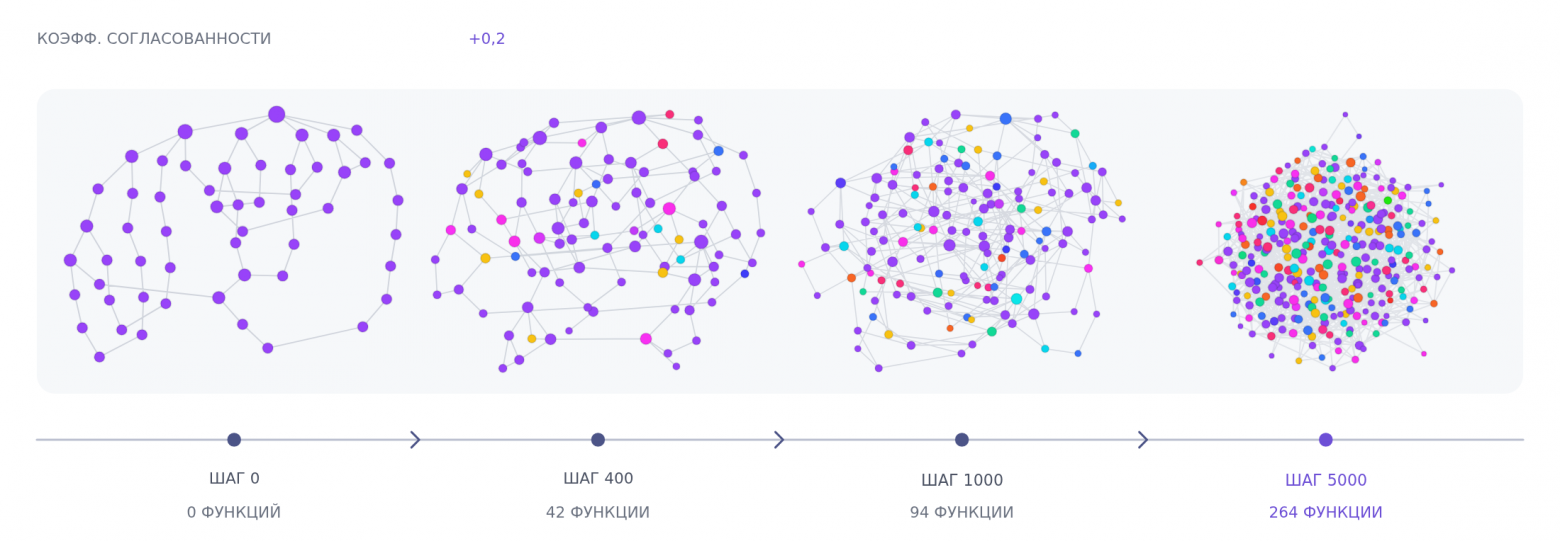
Коэффициент согласованности +0,2. Шаги 0, 400, 1000 и 5000; реализовано соответственно 0, 42, 94 и 264 фичи. Последовательность статичных состояний из оригинала.
Напротив, если взять изначально рассогласованную систему и последовательно вкладываться в восстановление её согласованности, можно переломить тенденцию и ускориться.
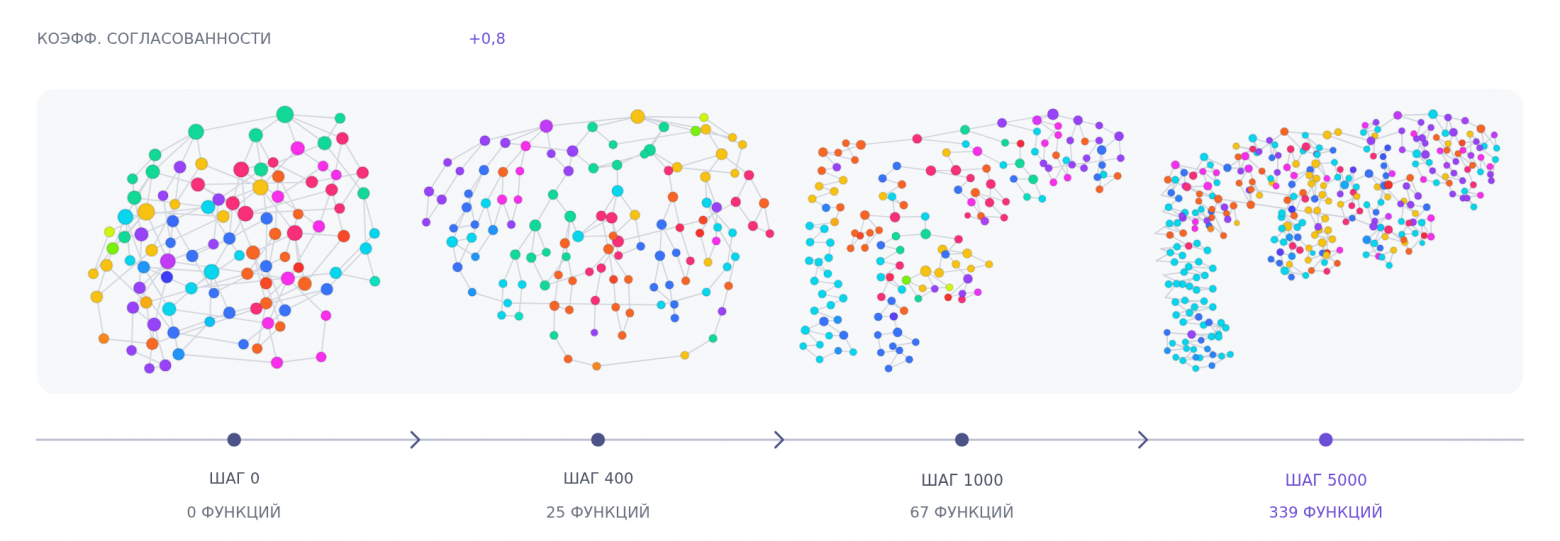
Коэффициент согласованности +0,8. Шаги 0, 400, 1000 и 5000; реализовано соответственно 0, 25, 67 и 339 фич. Последовательность статичных состояний из оригинала.
Критики могут заметить, что веса в этой симуляции выбраны произвольно и она не доказывает, что реальные сложные системы будут развиваться именно так. Я этого и не утверждаю.
Симуляция показывает, что такая кривая может возникнуть из простых правил и локальных решений. Те, кто меняет систему сегодня, способны облегчить или затруднить работу тем, кто будет менять её завтра. Это очевидная истина, но, на мой взгляд, её последствия легко упустить, если нельзя буквально увидеть сложность, как в физическом мире с его трубами, проводами и осязаемым оборудованием.
Итак, вернёмся к вопросу об агентах. Могут ли они работать с такими системами и сохранять согласованность? Или со временем всё же вносят декогеренцию, пусть даже понемногу? Здесь нужно учитывать ещё один принципиальный риск. Декогеренция растёт не с течением времени, а с изменениями.
Если сегодня построить рассогласованную систему, затем десять лет её не менять, а потом вернуться, она будет ровно настолько же рассогласованной, насколько вы её оставили. В ней могут возникнуть другие виды технического долга, но к декогеренции они отношения не имеют. Декогеренция увеличивается или уменьшается, только когда в систему вносят изменения.
А если вы очень быстро вносите много изменений, декогеренция тоже может нарастать очень быстро. Даже совсем небольшой прирост на каждом шаге способен выйти из‑под контроля раньше, чем мы это заметим.
С этим явлением мы сталкиваемся намного, намного дольше, чем существует разработка с помощью агентов. Во всех компаниях, где я когда‑либо работала, декогеренции было огромное количество. Менее опытные инженеры и инженеры под давлением тоже склонны со временем её усиливать, так что люди здесь далеко не безупречны.
Более того, я рискну предположить, что большинство компаний находится заметно ниже золотой середины и живёт в постоянном цикле:
-
Декогеренция нарастает настолько, что ни одну фичу уже нельзя закончить в разумный срок.
-
На её уменьшение бросают значительные силы.
-
Усилия дают результат, и фичи снова начинают выходить в медленном, но приемлемом темпе.
-
Работу не доводят до конца. А если доводят, то до золотой середины всё равно не дотягивают. Ресурсы и внимание переключают на другое, и система снова начинает терять согласованность.
И так по кругу. Одни компании восстанавливают согласованность быстрее других и дольше поддерживают эти усилия. Очень немногим удаётся постоянно держаться в золотой середине, но для этого нужна инженерная культура, последовательно нацеленная на высокое качество (на ум приходит Apple; что бы вы ни говорили о нынешнем состоянии macOS, я в любой день предпочту её Windows).
Вопрос в том, действительно ли агенты уже сейчас справляются с этим лучше, чем обычная инженерная команда с её сложившейся культурой. Причём существенно лучше?
Пока подтверждений этому мы не видели. Скорее, первые исследования указывают в противоположную сторону.
Гарвардское исследование [4], охватившее 718 компаний, показало, что внедрение агентов для программирования увеличило объём написанного кода на 30%, но не дало измеримого прироста объёма завершённой работы. Вместо этого дополнительный код скапливался на ревью. Проверка пул‑реквестов занимала на 49% больше времени, а число возвращённых на доработку почти удвоилось.
Исследование Университета Карнеги — Меллона [5] по open‑source‑проектам, внедрившим Cursor, обнаружило резкий рост скорости разработки, который оказался недолговечным, и увеличение сложности кода, которое, напротив, сохранилось. Причём сама эта дополнительная сложность стала одной из главных причин последующего замедления.
Наконец, анализ более 300 тысяч коммитов, созданных ИИ, в более чем 6 тысячах репозиториев [6] показал, что примерно каждый одиннадцатый коммит, а для некоторых ассистентов до каждого седьмого, добавлял хотя бы одну проблему с качеством. Почти четверть этих проблем до сих пор остаётся в коде.
Больше кода, тот же объём завершённой работы и больше сложности после каждого изменения.
Прогресс
Теперь разберём главное возражение, аргумент о техническом прогрессе. Звучит он примерно так:
Первое поколение агентов будет писать код более низкого качества, но пока он «достаточно хорош», агенты всё равно смогут заменить людей в большинстве задач программирования. А мы сможем выстроить процессы вокруг них в расчёте на то, что в будущем появятся более способные агенты.
По сути, это история автоматизации времён промышленной революции, когда первые текстильные машины действительно работали гораздо хуже людей, но со временем догнали их. Как отмечал Кори Доктороу [7], промышленники наперегонки внедряли автоматизацию, потому что она позволяла подчинять работников более жёсткой дисциплине и сосредотачивать власть в своих руках за счёт рабочих и общества. Нескольким поколениям пришлось мириться с гораздо худшими условиями труда и товарами более низкого качества. [8] [9]
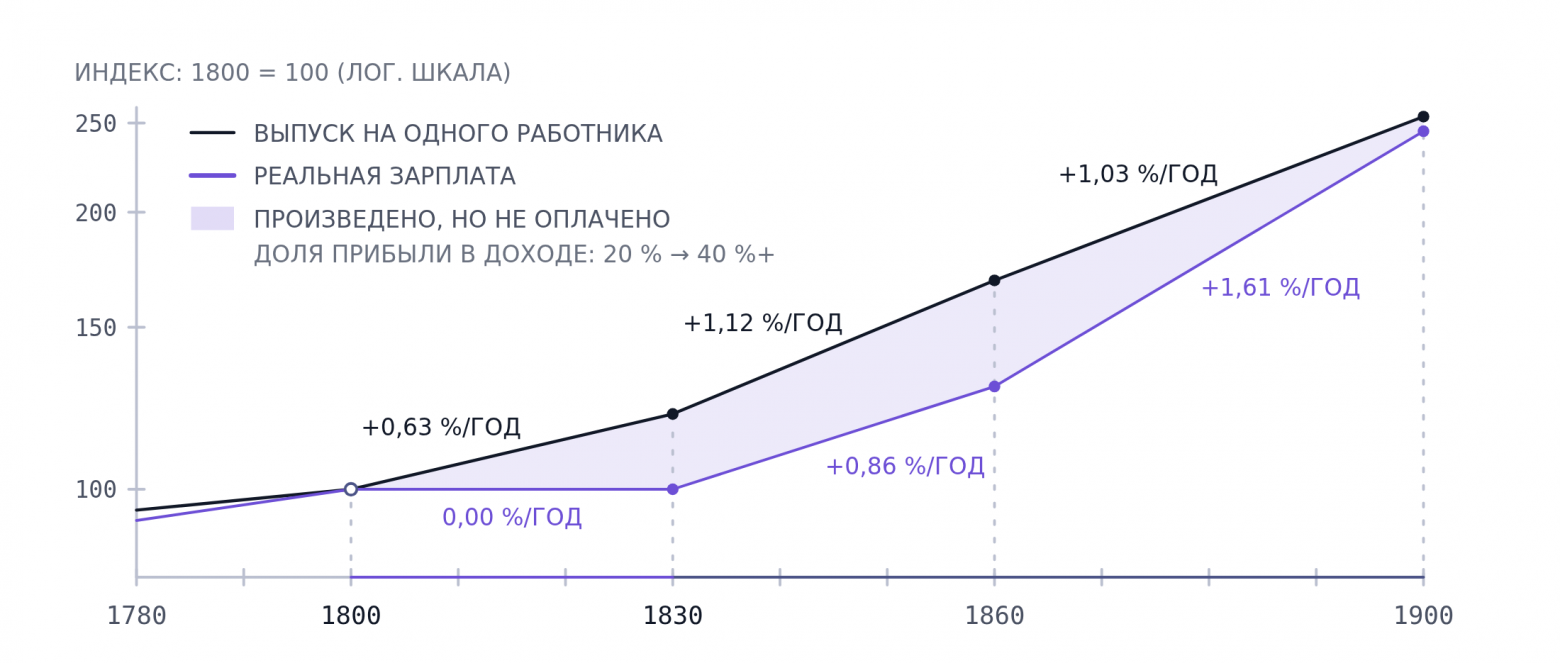
«Пауза Энгельса»: выпуск на работника и реальная заработная плата росли не одновременно. Исходный авторский график по работе Роберта Аллена [9]; подписи переведены.
Но я хочу развить эту мысль, потому что для текстильной промышленности такой подход сработал по одной принципиальной причине. Машины выпускали продукцию хуже, но она соответствовала минимально допустимому уровню качества.
Сами машины при этом были очень хорошо спроектированы для своих задач. Недавно я разговаривала с инженером‑механиком, который с восторгом отзывался о качестве этих поколений станков, о том, как хорошо они работали и как долго служили. Да, возможно, они гнали низкосортную продукцию, но делали это быстро, без устали и много‑много лет, пока их не сменяло следующее, немного улучшенное поколение. И, что принципиально, пока машина работала, декогеренция не увеличивалась. Износ — да. Смена поколений технологий — да. Но не декогеренция.
И вот в чём загвоздка. Этот аргумент предполагает, что код аналогичен ткани, то есть служит конечным продуктом, за который пользователи готовы платить. Но никто не хочет покупать код. Люди хотят покупать приложения.
Иными словами, код — не ткань, а ткацкий станок. Всякий раз, когда отрисовывается экран, отправляется форма или обновляется запись, производится тот самый «продукт», который выпускает код. Именно поэтому программное обеспечение оказалось настолько прибыльным, ведь каждый дополнительный клиент не требует дополнительных накладных расходов. Сырьём служат биты и байты, представленные электрическими сигналами в микросхемах, а продуктом становятся информация и процессы, закодированные в этих битах.
Более точная аналогия получилась бы, если бы мы каким‑то образом вернулись в прошлое и создали не просто ткацкий станок, а машину, которая проектирует ткацкие станки. Которая сама разрабатывает следующие поколения текстильного оборудования, полуавтономно или, возможно, полностью автономно. Ничего подобного прежде не существовало, и в истории автоматизации у этого нет прецедентов.
Это и есть мечта о рекурсивном самосовершенствовании. О взрыве интеллекта, о технологической сингулярности [10]. Именно такая мечта изначально стояла за ИИ.
И как обстоят дела на этом пути?
Сингулярность
Что ж, планка успеха понемногу сдвигается. В мае 2026 года Том Рид, скептически относящийся к теории взрыва интеллекта, предложил термин «сингулярность Гудхарта» [11]. Так он обозначил ограничения ИИ, который совершенствуется внутри изолированного пузыря, не получая новых данных о реальном мире. В основе лежит закон Гудхарта [12]:
Когда показатель становится целью, он перестаёт быть хорошим показателем.
Мэрилин Стратерн, перефразируя Чарльза Гудхарта.
В сентябрьской публикации Том Дэвидсон, старший научный сотрудник Forethought [13], признал, что нехватка данных замедлит прогресс [14], когда ИИ достигнет того, что он называет «потолком человеческого качества». В этот момент лучших примеров человеческой работы для обучения уже не останется, и ИИ придётся самому создавать данные, превосходящие по качеству всё существующее. Дэвидсон много писал о моделях скорости взлёта ИИ, а на его работах основывались более поздние прогнозы, прежде всего сценарий AI 2027 [15].
Поэтому даже небольшое колебание в позиции Дэвидсона заслуживает внимания. Но он утверждает, что речь об однократном замедлении, а не о непреодолимой стене. В целом сторонники быстрого взлёта по‑прежнему считают, что ИИ сможет рекурсивно совершенствовать себя самостоятельно, располагая сравнительно небольшим количеством данных, и что этот процесс может выйти из‑под контроля в изолированном дата‑центре и привести к рождению сверхинтеллекта.
Они рассчитывают на так называемый взрыв интеллекта за счёт программного обеспечения (Software Intelligence Explosion, SIE) [16]. В тексте Дэвидсона о нехватке данных есть один тонкий момент, на котором во многом держится этот аргумент:
Вместо сред обучения с подкреплением, в которых ИИ учится создавать программные продукты для реального мира, он должен строить среды, обучающие его создавать ПО лучше любого, существующего в реальном мире.
Сразу скажу, я считаю это возможным! Придумывать сложные задачи и проверять ответы на них проще, чем решать эти задачи. Уже сегодня эксперты‑люди создают среды обучения с подкреплением, которые дают данные выше потолка человеческого качества. Качество данных не упрётся в этот потолок.
Давайте разберёмся.
Дэвидсон говорит, что ИИ должен уметь создавать ПО лучше всего существующего в реальном мире, находясь в значительной степени в изоляции от него. Для этого ИИ понадобится построить среду обучения с подкреплением [17], которая позволит получить такое ПО. В общих чертах процесс выглядит так:
-
Определить цель.
-
Определить набор допустимых действий.
-
С помощью алгоритма опробовать множество способов достижения цели.
-
Измерить, насколько близко удалось подойти к цели и насколько хорош выбранный способ.
-
Найти лучший способ или несколько лучших способов.
Чтобы произошёл такой взрыв интеллекта, ИИ должен самостоятельно проделывать весь этот цикл, открывая всё более совершенные алгоритмы обучения. Именно это и важно. Речь не о более качественном ПО самом по себе, а о более качественных алгоритмах обучения и совершенствования.
Аргумент о сингулярности Гудхарта, по сути, состоит в том, что для большинства значимых задач реального мира ИИ, изолированный в дата‑центре, не сможет пройти этот цикл из‑за этапа измерения. Чтобы придумать лучший автомобиль, ракету или микросхему, можно построить симуляцию и испытывать идеи в ней, но результаты всё равно придётся проверять в реальном мире. Иначе по мере того, как конструкции будут становиться всё более экстремальными, вы будете всё дальше уходить от реальности. Необходимость проверки ограничивает скорость и существенно замедляет процесс.
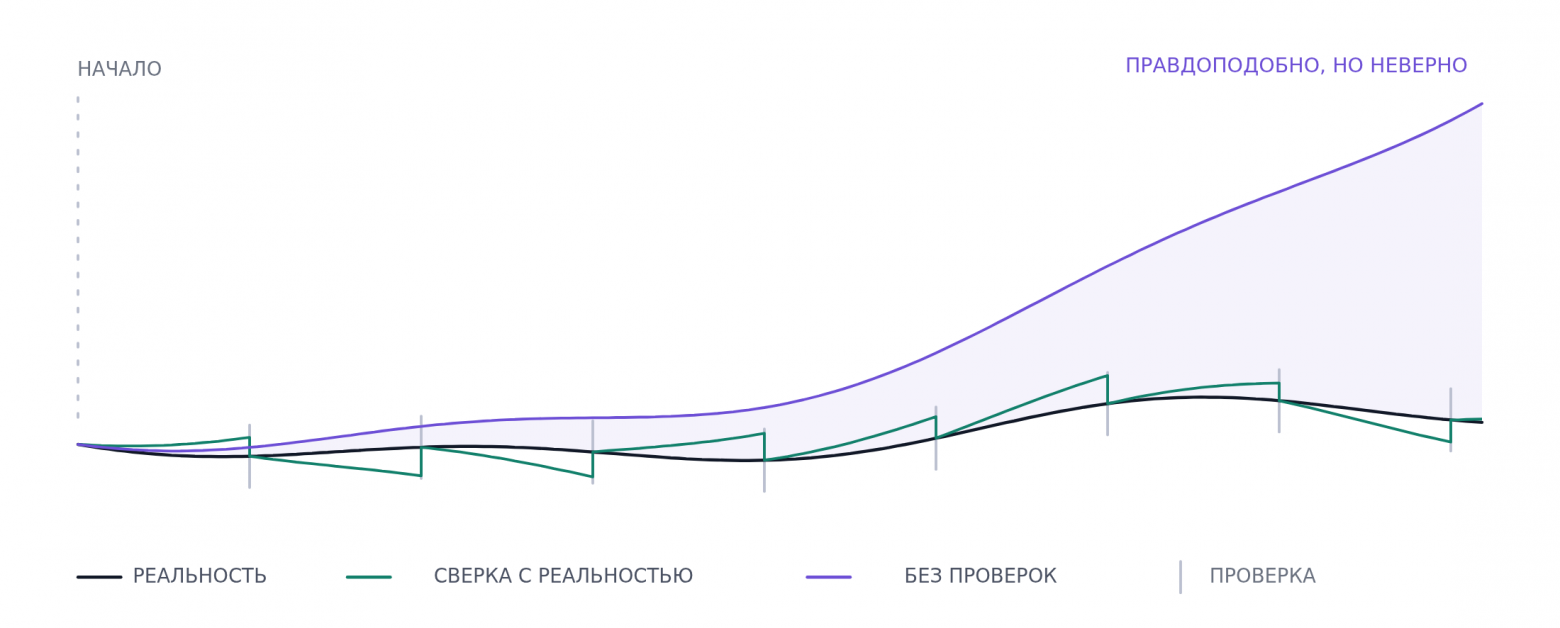
Без сверки с реальностью модель постепенно от неё отдаляется. Периодические проверки позволяют корректировать отклонение.
Но для некоторых областей это неверно, о чём Дэвидсон и говорит во второй части цитаты. В таких играх, как го или шахматы [18], правила игры задают весь мир, а условия победы чётко определены. Поэтому можно работать изолированно, находить всё более сильные стратегии, а также улучшать алгоритмы их поиска. То же верно для более сложных игр, например StarCraft [19] или Dota [20].
Но это игры, и такой подход возможен потому, что условия победы ясны и просты, а правила или среда сильно ограничены. Чтобы получить взрыв интеллекта, нужно применить эти методы к чему‑то по‑настоящему значимому, причём проверить результат внутри пузыря дата‑центра, не сверяясь с внешним миром.
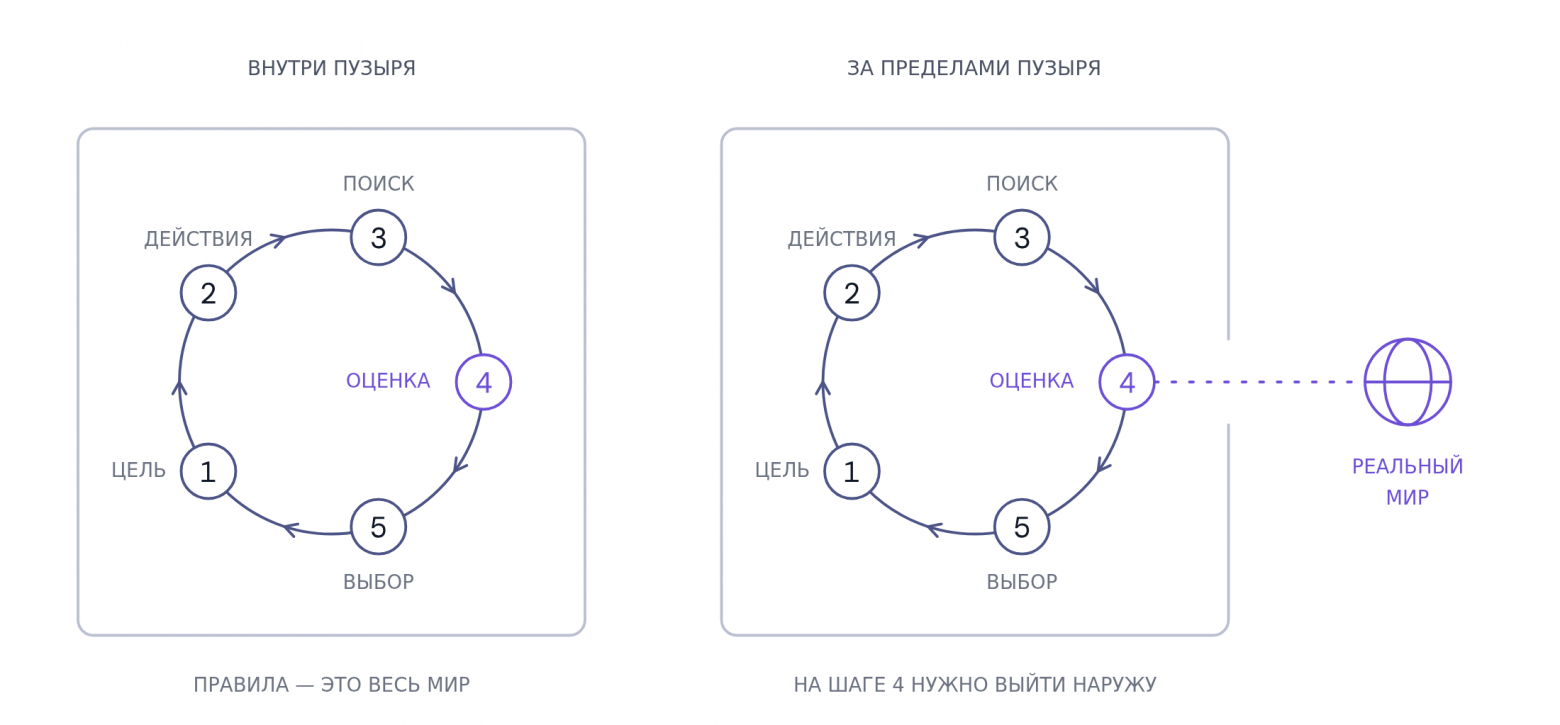
В игре все этапы цикла, включая оценку результата, доступны внутри среды. Для задач реального мира этап проверки выходит за её пределы.
И здесь мы подходим к программному обеспечению. Мне кажется, сторонники SIE так ухватились за него именно потому, что видят в нём способ преодолеть этот разрыв. ПО может работать изолированно, и тестировать его в изоляции легко и быстро. Это идеальные условия для создания среды обучения с подкреплением, и они считают, что со временем мы сможем построить такую среду, которой не потребуется сверяться с реальным миром.
В конце концов, это же софт. Он ведь может почти всё, правда?
Нетрудно понять, почему людям Кремниевой долины эта мысль кажется такой естественной. Мы гордимся своим интеллектом и умением решать большие задачи. Значительная часть обучения компьютерным наукам посвящена логическому доказательству свойств программ, алгоритмов и тому подобного. Завершится ли программа? Будет ли быстрым этот алгоритм сортировки? Насколько быстрым? Будет ли система безопасной и не упадёт ли ни в одном из всех мыслимых случаев?
Мы привыкли так думать о задачах и привыкли к мысли, что у программного обеспечения нет границ. Технологии завоевали мир, поэтому кажется естественным предположить, что если научить машину писать код, то со временем она научится сама совершенствоваться в программировании.
А потом, в конце концов, машина тоже завоюет мир.
Что делает программное обеспечение лучше
Но при таком взгляде совершенно упускается согласованность, хотя именно она делает ПО хорошим.
Поясню. Программное обеспечение служит инструментом для достижения цели в реальном мире. До этой цели может быть много промежуточных ступеней и уровней абстракции, но в конечном счёте успех определяется тем, насколько хорошо ПО помогает её достичь.
Возможно, вы подумаете: хорошо, но если программа уже есть и задачу решает, разве нельзя взять её результат за ориентир? А затем позволить ИИ искать всё более эффективные способы получить тот же результат?
Если понимать «лучше» как что‑то простое и легко измеримое, например число строк кода, скорость, потребление памяти или эффективность, то да. Все эти показатели важны, но если сделать их целью, мы получим маленькое, быстрое и полностью рассогласованное ПО.
Код становится быстрее, когда выполняет меньше работы, а обходиться без части работы он может лишь за счёт предположений об остальной системе. Например, что этот список уже отсортирован, а то значение никогда не равно нулю. Каждое такое предположение создаёт скрытую связь, которую никто не задокументировал. Оптимизированный нативный код не случайно прячут за абстракциями. Он нужен для производительности, поэтому мы запираем его в «коробке», не позволяя его допущениям просачиваться наружу. Если писать так весь код, получится клубок. (В JavaScript, например, несколько логически разных классов объединяют в один, чтобы сохранить мономорфность горячих участков кода [21]. Это всегда та ещё морока, но она окупается, пока ничего не приходится трогать.)
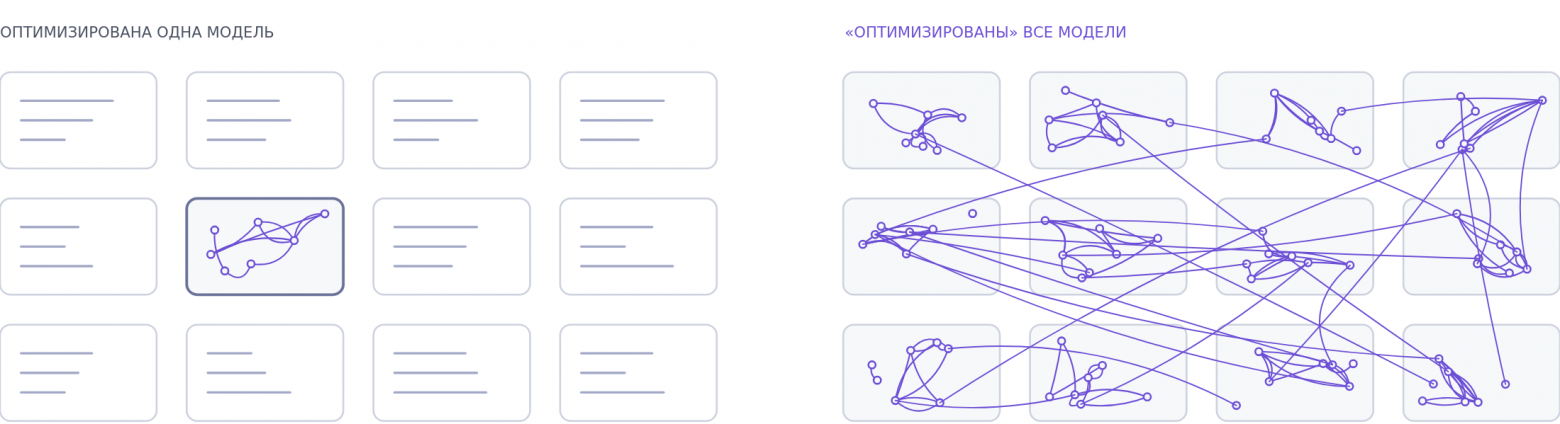
Оптимизированный участок можно изолировать за границей абстракции. Если же вся система устроена как такой участок, скрытые зависимости переплетаются повсюду.
Всё было бы нормально, если бы программы требовалось написать один раз и больше никогда к ним не возвращаться. Но на практике так не бывает, потому что программное обеспечение подобно кораблю Тесея, который перестраивают без конца. Приложения, библиотеки и фреймворки должны развиваться вслед за меняющимися условиями реального мира. Эти условия меняются по мере того, как мы переустраиваем общество, узнаём новое о природе и раздвигаем пределы возможного.
Поэтому хорошее ПО способно адаптироваться со временем. Вы можете взять уже накопленный технологический капитал (всё программное обеспечение, написанное раньше) и быстро собрать из него новые сочетания, чтобы на ходу решить новые задачи.
Адаптивным его делает согласованность. Большинство крупных достижений в программировании и качестве ПО было связано с её повышением, а проверить, действительно ли система стала согласованнее, можно только через обратную связь из реального мира.
Рассмотрим это на конкретном примере futures [22].
Futures существенно упрощают асинхронное программирование. До них существовало множество способов работать с асинхронностью, и всё это предсказуемо превращалось в хаос. Точнее, в рассогласованную мешанину из множества локально разумных способов делать одно и то же, которые никак не стыковались друг с другом.
Разработчикам приходилось жить в этой мешанине и осторожно, вдумчиво переключаться между всеми разновидностями асинхронности, сосуществовавшими в одном приложении. Стоило пропустить шаг или что‑нибудь забыть, и появлялись трудноуловимые ошибки. По мере того как множились колбэки, усложнялось приложение и росло число асинхронных операций, само чтение кода превращалось в фильм ужасов.
Идея futures появилась в 1970-х и состояла в том, чтобы временно представлять ещё не полученное значение специальным объектом. Первая конкретная реализация появилась в MultiLisp в 1985 году. Но в массовую разработку futures пришли лишь в 2000-х, когда в Java их добавили в 2004 году. А по‑настоящему популярными стали в 2010-х, с появлением в JavaScript промисов, которые можно объединять в цепочки, и Task в C#. [22]
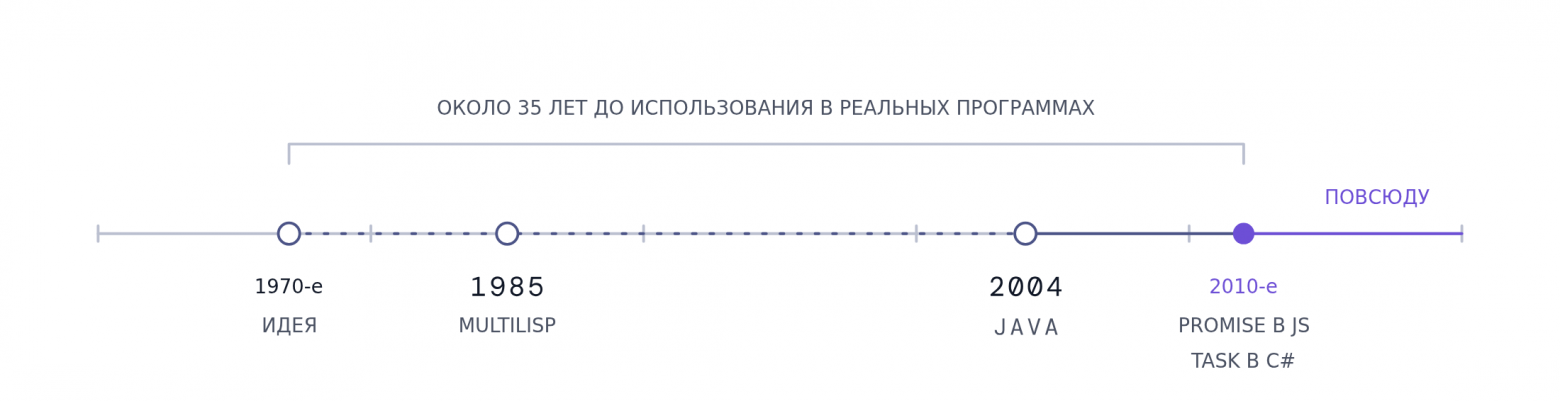
Путь от идеи будущего значения до массового применения занял десятилетия и прошёл через MultiLisp, Java, а затем JavaScript и C#.
Основных причин было две.
-
Первые API для futures работали, но были неуклюжими. Future можно было передавать между частями программы, однако попытка прочитать значение блокировала выполнение, поэтому приходилось внимательно выбирать момент чтения. Кроме того, от одной future нельзя было независимо строить разные цепочки, и разветвлять дальнейшие вычисления было непросто.
-
Futures дают заметные накладные расходы. Каждый раз приходится создавать объект‑обёртку, отслеживающий состояние, вместо того чтобы, например, просто сохранить указатель на функцию.
Но со временем мы нашли удобные API, устранили шероховатости и поняли, что дополнительные расходы оправданы, потому что благодаря futures проще рассуждать о больших системах и соединять их части (удешевление вычислений и памяти тоже не помешало).
Вернёмся к ИИ.
Чтобы создавать более качественное ПО для ИИ, нужно уметь проверять, действительно ли оно лучше. Причём, как мы уже говорили, проверять это нужно внутри пузыря. Проверять за его пределами нельзя, иначе мы снова упрёмся в ограничения скорости, которые задаёт мир.
Что же можно проверять внутри?
Мы сузили круг до трёх областей:
-
Игры.
-
Программное обеспечение.
Игры далеко нас не уведут, потому что они не привязаны к реальным задачам, которые нам важны. Поэтому перейдём к ПО.
Как мы установили, хорошее программное обеспечение согласованно. Но как измерить согласованность?
Нужно взять абстракцию и посмотреть, насколько хорошо она работает в разных контекстах и как сильно приходится перекраивать код, чтобы приспособить её к каждому из них. Поскольку выходить из дата‑центра нам запрещено, сделать это можно только двумя способами.
Применить её ко всему существующему ПО. Это поможет лишь до определённого предела, поскольку даже хорошая работа со всеми существующими программами не позволяет узнать, будет ли абстракция так же хороша для всех будущих. Колбэки и циклы событий даже не были широко распространены, пока графические интерфейсы не стали нормой, а ранние веб‑серверы всё ещё использовали потоки и традиционный параллелизм. Поэтому ценность futures не была очевидной, пока мы не создали и не исследовали всё многообразие программ, составляющих веб. Мы будем переобучаться на уже известных программах. Сегодня результат может выглядеть идеально согласованным, а первая же новая задача, которая в него не впишется, потребует обходного решения.
Создавать новое ПО. В теории это можно попробовать, но на практике нельзя просто генерировать программы, которые кажутся полезными, чтобы расширить обучающую выборку. Повторю, ПО служит инструментом для достижения цели в реальном мире, и если время от времени не проверять его полезность, можно сильно оторваться от реальности.
Помимо этой основной проблемы есть и другой важный критерий согласованности. Нужно понять, насколько хорошо абстракция или концепция выдерживает проверку временем, разными контекстами и меняющимися требованиями. Стандарт может прекрасно выглядеть на бумаге и даже хорошо работать в одной среде, например на настольных компьютерах, но оказаться совершенно непригодным для мобильных устройств или масштабных облачных систем.
Потребовалось бы генерировать не только ПО, которое кажется полезным, но и правдоподобные сценарии его эволюции, чтобы увидеть, как оно адаптируется, что происходит, когда обновляются не все, когда люди (или агенты) отстают либо решают пойти другим путём, когда вся экосистема систем постоянно меняется, словно движущаяся мишень.
Можно сколь угодно хорошо научиться повышать согласованность уже существующего ПО. Но чтобы научиться лучше работать с ПО, которого у нас ещё нет, нужно либо дождаться, пока реальный мир создаст новые программы, либо создать их самим, испытать в реальном мире и дождаться, пока они пройдут определённый путь развития. Оба варианта требуют выходить из пузыря и возвращаться обратно.
Теперь соберём всё вместе.
-
Мы можем создать ИИ, который, оставаясь внутри пузыря, делает ПО быстрее, компактнее и эффективнее, чем это удаётся людям.
-
Но мы не можем создать ИИ, который повышает согласованность ПО выше человеческого уровня, не выходя из пузыря, по причинам, изложенным выше.
-
Поскольку без выхода наружу ИИ не может проверить, стало ли ПО лучше в общем смысле, он не может определить, действительно ли улучшает свои алгоритмы обучения или просто уходит от реальности.
-
Мы снова приходим к сингулярности Гудхарта.
Уже это забивает гвоздь в крышку гроба быстрого изолированного SIE. Но можно подойти к вопросу и с другой стороны, причём этот аргумент применим также к другим разновидностям взрыва интеллекта.
-
Любая разновидность взрыва интеллекта требует, чтобы ИИ исследовал и улучшал собственное ПО или оборудование, а каждое новое поколение опиралось на улучшения предыдущего.
-
В каждом поколении существует некоторая вероятность внести декогеренцию, поскольку ИИ строит или расширяет системы за пределами своего текущего понимания.
-
Если ИИ движется слишком быстро, декогеренция накапливается быстрее, чем он успевает её устранять. В результате общий уровень его возможностей перестаёт расти или снижается.
-
Если же ИИ проверяет и подтверждает все свои результаты, скорость ограничивается его способностью собирать данные об окружающем мире.
-
Исправить это более совершенными алгоритмами обучения, созданными в полной изоляции, нельзя, потому что ИИ не с чем сверять их качество (см. первое доказательство выше).
Как выглядит сбой из третьего пункта, показывает следующий график, адаптированный из модели Этха и Дэвидсона, представленной в их работе о SIE [16]. В их прогнозе кривая роста взмывает вверх ещё до пятого месяца. На графике ниже исходная модель сохранена, но добавлено предположение, что стоимость каждого изменения удваивается по мере накопления проделанной работы. Именно так выглядит декогеренция в человеческих кодовых базах.
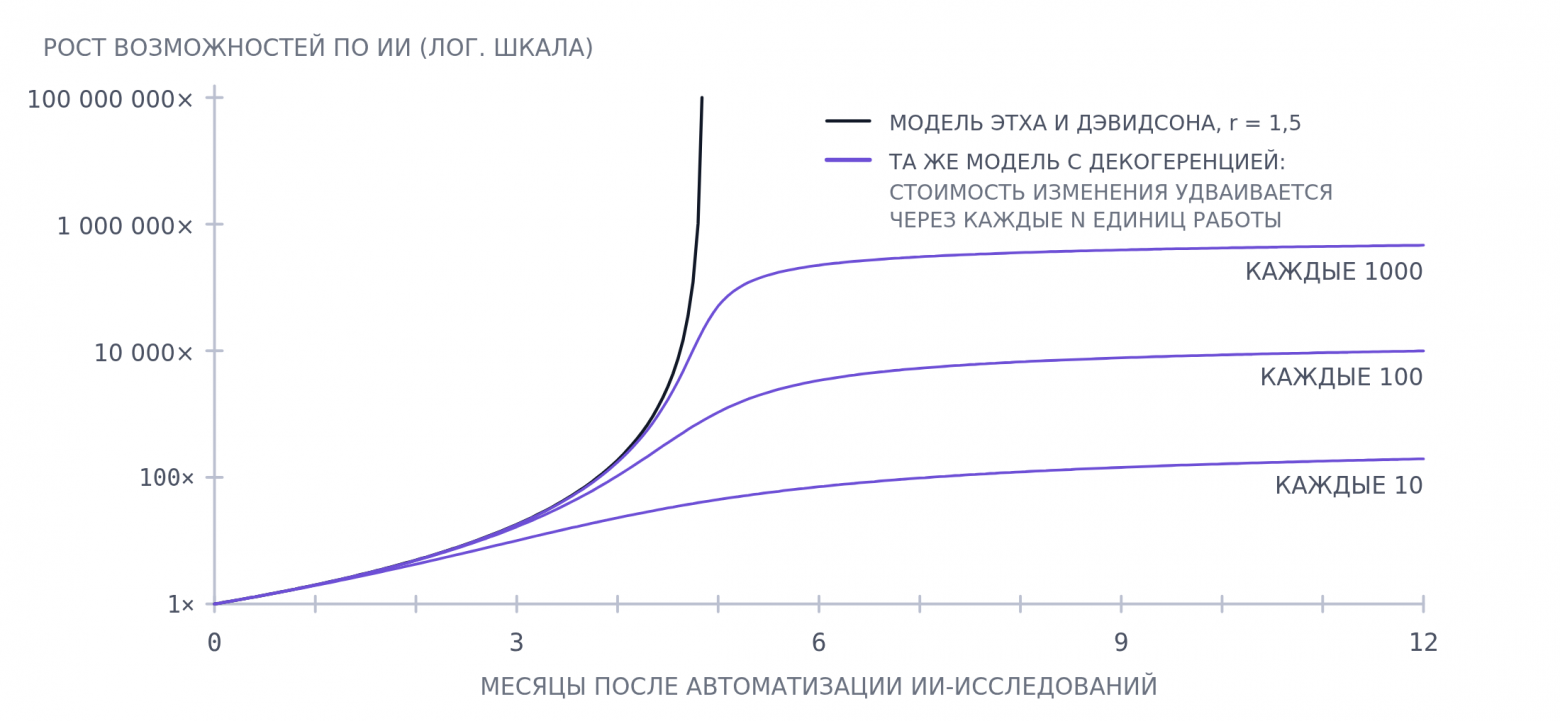
Авторская адаптация модели Этха и Дэвидсона. По вертикали используется логарифмическая шкала, по горизонтали отсчитываются месяцы после автоматизации исследований ИИ. Дополнительные кривые показывают сценарии удвоения стоимости изменения через каждые 1000, 100 и 10 единиц работы. Это иллюстрация модельного допущения, а не эмпирический прогноз.
Если это верно и ИИ не может обойти декогеренцию, то в конечном счёте его скорость ограничивает реальность. Не то чтобы он никогда нас не превзойдёт, но до действительно значимого превосходства ещё далеко. И даже достигнув его, ИИ всё равно придётся выполнять всю работу, которой требует реальность, подчиняясь тем же физическим и информационным ограничениям, что и мы.
Дэвидсон утверждает, что собрать достаточно данных можно легко, просто записывая выполнение реальных задач:
Если весь мир объединится, чтобы сделать это быстро, много времени не потребуется. Для каждой профессии тысяча человек могла бы записывать свои экраны и носить на голове видеокамеры, и за четыре месяца ИИ получил бы опыт, эквивалентный трёмстам годам работы.
Такой подход в корне недооценивает сложность мира. Если мы ожидаем, что машина сможет совершенствовать себя бесконечно, ей недостаточно хорошо двигать курсор по экрану или распознавать объекты на видео. Ей нужно глубоко понять сам мир. Необязательно переживать его так же, как человек, но необходимо получать информацию того же рода, смотреть с той же точки зрения, измерять неуловимые свойства и тонкости, которые не зафиксируешь одной лишь записью экрана и видеопотоком.
Она должна уметь находить связи между вещами, которые поначалу кажутся совершенно не связанными. Что и подводит нас к последней теме.
Математика
Есть ещё математика, где, в теории, результаты можно проверять внутри пузыря, удостоверяясь в корректности доказательств. Если ИИ способен совершенствоваться в математике, не выходя наружу, значит, он может разработать более совершенный алгоритм обучения в целом. Тогда, возможно, аргумент в пользу SIE всё‑таки остаётся в силе.
Но математика в некотором смысле произвольна. Мы сами принимаем множество решений о том, как она устроена и что в ней полезно. Например, ноль не всегда признавали полноценным числом. На признание мнимых чисел ушли столетия, а их четырёхмерные родственники, кватернионы, казались Льюису Кэрроллу настолько абсурдными, что, как предполагают, он высмеял их в сцене чаепития у Безумного Шляпника [23].
Сегодня мы принимаем такие вещи как данность, хотя они вовсе не настолько очевидны или естественны, как нам кажется. Они получили широкое признание лишь после того, как нашли практическое применение и дали результаты, в которых прослеживалось содержательное соответствие реальному миру.
Похожая история произошла с булевой алгеброй, той фундаментальной математикой, на которой держатся вычисления. Почти столетие её тоже считали экзотическим разделом математики. Джордж Буль впервые опубликовал её [24] в 1847 году, однако практических применений у неё не было, и её изучали как диковинку формальной логики, а не как инструмент серьёзной инженерии.
Её значение стало ясно лишь в 1930-х, когда Клод Шеннон работал в MIT над релейным управлением дифференциального анализатора Вэнивара Буша. С булевой алгеброй он познакомился раньше, во время учёбы в университете, на занятиях по философии [25]. Работая со схемами, Шеннон понял, что она идеально их описывает. В магистерской диссертации «Символический анализ релейных и переключательных схем» [26] он установил эту связь в 1937 году. Дальнейшее, как говорится, всем известно.
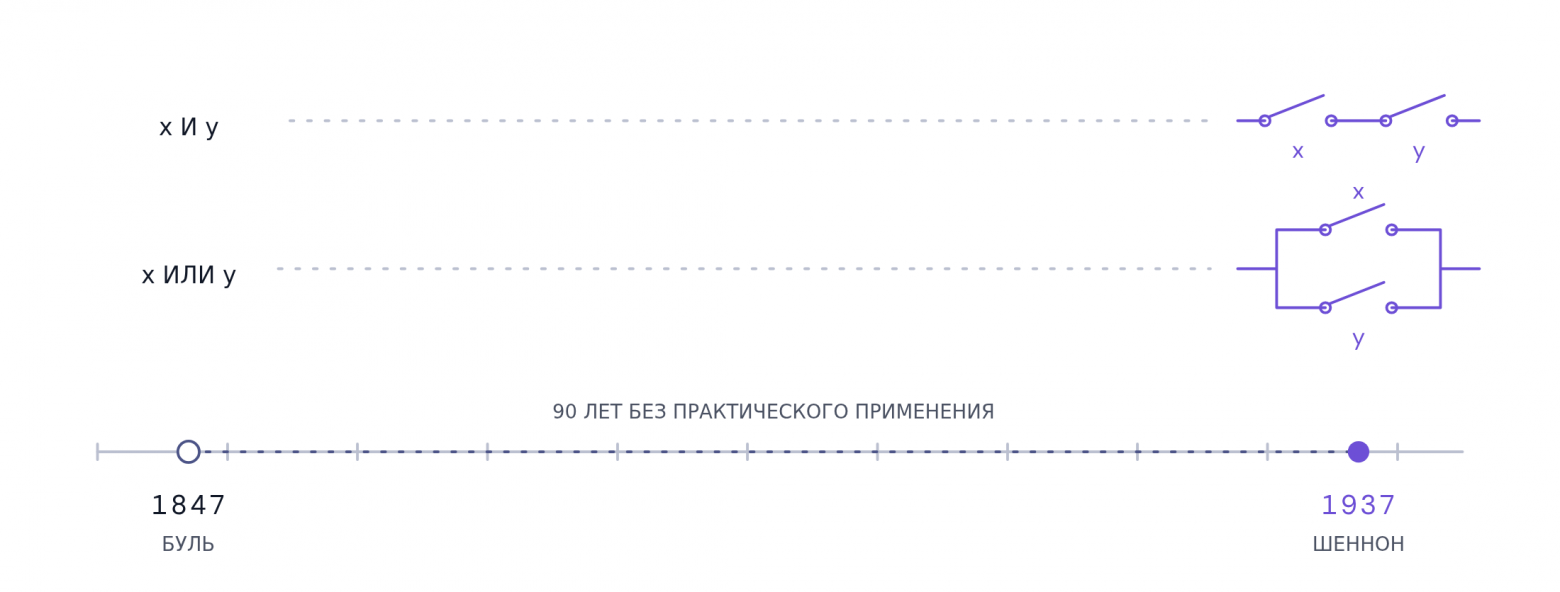
От алгебры логики Буля (1847) до её применения к электрическим переключательным схемам у Шеннона (1937) прошло около 90 лет.
Буль не просто выдумывал математику ради самой математики. Он интуитивно чувствовал, что открытые им свойства и созданная система когда‑нибудь окажутся важными. Он полагал, что открывает законы человеческого мышления. Возможно, в этом он несколько заблуждался, но идея оказалась достаточно интересной, чтобы логики и философы изучали её и передавали дальше, пока Шеннон не познакомился с ней и не продолжил работу.
Сумел бы Шеннон обнаружить эту связь в эпоху ИИ? Если бы не стоял в комнате, полной реле, перед реальной задачей, которая подсказывает, куда смотреть, а перебирал бесконечные стопки доказательств, по отдельности верных, но в целом лишённых смысла?
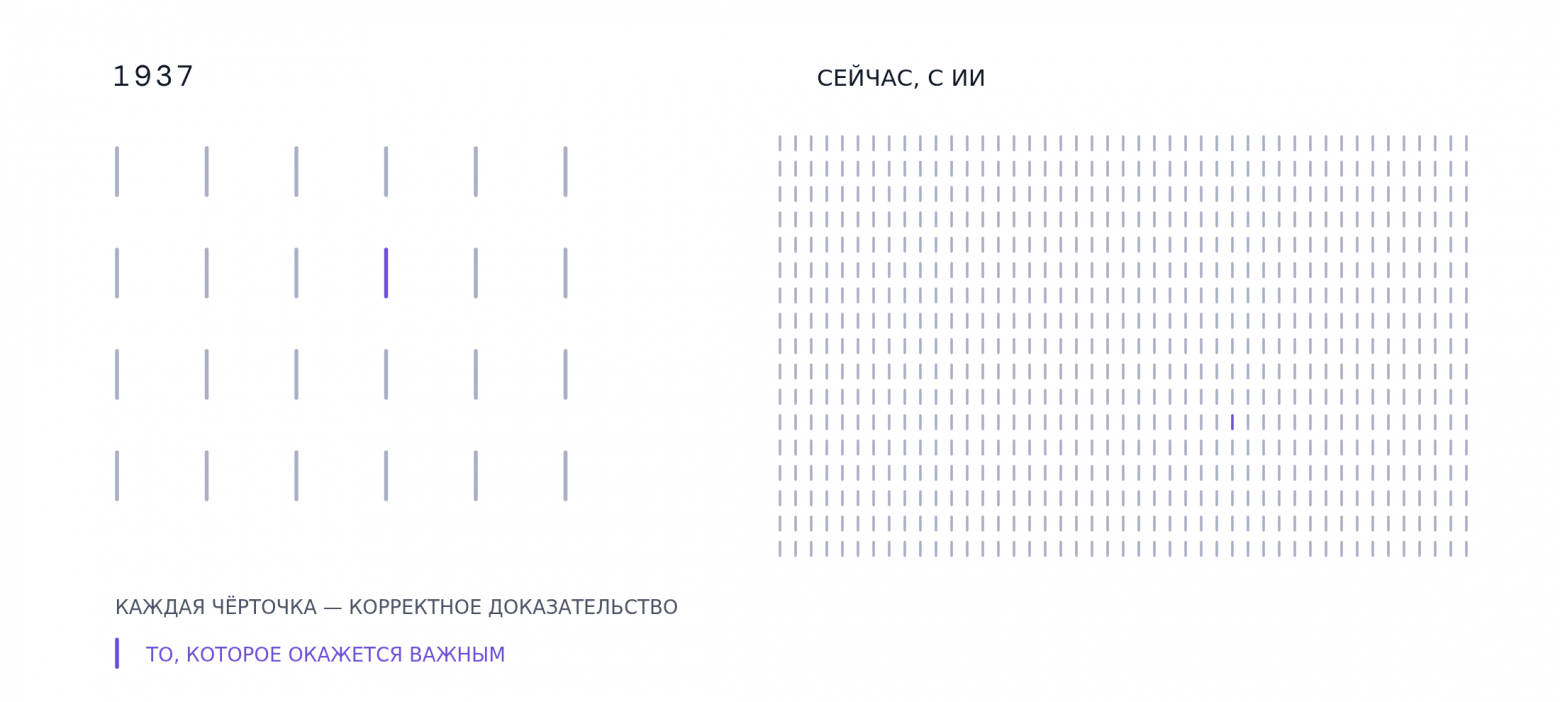
Производить верные утверждения и находить среди них значимые связи не одно и то же.
В отрыве от реальности можно определить бесконечное множество логических и математических систем и чрезвычайно хорошо научиться строить и исследовать эти гипотетические конструкции. Но чтобы определять, имеют ли они значение, нужен другой навык, который нельзя улучшить внутри пузыря.
Математики уже обеспокоены этим расхождением. В сентябре 2026 года двадцать пять лауреатов Филдсовской премии, включая Теренса Тао, подписали декларацию [27]. В ней они утверждают, что решение задач служит лишь косвенным показателем настоящей цели математики, понимания, а массовое производство верных утверждений способно истощить почву, на которой вырастают новые идеи.
Что случится, когда эта почва будет истощена полностью?
Коллапс
Чтобы создавать согласованность, нужно долго и неустанно трудиться. Исследовать каждую щель, заглядывать под каждый камень. Лезть в грязь реальности и позволять ей затекать в сапоги, пока вслепую нащупываешь все способы, которыми мир вокруг тебя может складываться и перекраиваться, без конца, но так, чтобы он не поглотил тебя целиком.
Дело не только в решении задач. Нужно ещё понять, какие задачи мы вообще пытаемся решить.
Понять все эти задачи и найти единое решение, которое справляется с каждой, не превращаясь в стремительно разрастающийся лабиринт сложности.
И это подводит меня к последней мысли.
Текст баннера: «Красивый, увлекательный Linux от DHH с агентами. Гибкая ОС для эпохи агентов. Вайб‑кодьте любые изменения, настройки и исправления».
В последнее время немало говорили об Omarchy [28]. Многим он нравится, а многие другие, скажем так, скептически относятся к дистрибутиву Linux, в котором агенты поставлены во главу угла. Проект очень быстро двинулся в эту сторону и, похоже, превращается из изначально задуманного аккуратного набора настроек по умолчанию в полноценный дистрибутив с собственной сборкой ядра [29].
Сразу оговорюсь, что эксперименты на периферии экосистемы важны. Возможность делать форки, исследовать идеи, свободно выяснять, что работает, а затем возвращать результаты сообществу во многом и делает открытое программное обеспечение столь успешным.
Но здесь я начинаю тревожиться.
Тревожусь, что где‑то по пути мы могли забыть, что все вместе поднимаемся на одну гору. Что именно создание согласованности сделало наше сообщество таким успешным и устойчивым, позволило вычислительной технике продвинуться так далеко и так быстро.
В 1980-х, 1990-х и на протяжении 2000-х каждая компания поддерживала собственный стек. На каждом сервере был свой набор зависимостей, скриптов, версий ОС и всего прочего. В обычной компании требовалась целая команда только для того, чтобы всё продолжало нормально работать.
Во время войн операционных систем [30] фрагментация была ещё сильнее. У Unix не было очевидного преемника, а Windows отвоёвывала позиции, предлагая совершенно другую парадигму. Где бы мы оказались сегодня, если бы тогда не появился Linux и не объединил вокруг себя стареющую экосистему *nix? (Да, я знаю, что существовала FreeBSD и могла занять это место. На самом деле я спрашиваю, что было бы, если бы движения свободного ПО не возникло вообще.)
Платили бы мы лицензионные отчисления при каждом запуске контейнера в облаке?
Сколько стартапов так и не смогли бы появиться просто из‑за стоимости эксплуатации собственного стека?
Из‑за этой фрагментации каждая система со временем начинала казаться устаревшей и неповоротливой. Вся экосистема была рассогласованной, и значительная часть работы последних двух десятилетий заключалась в повышении её согласованности (и в присвоении части созданной ценности через SaaS‑продукты, но я забегаю вперёд).
Боюсь, сейчас мы можем заниматься чем‑то вроде подсечно‑огневого земледелия, отбрасывая накопленную согласованность ради того, чтобы заново создавать каждую зависимость, подгонять под себя каждую программу и разрастаться во все стороны ради краткосрочных задач.
И не замечать, что всё это время забегаем всё глубже в ловушку.
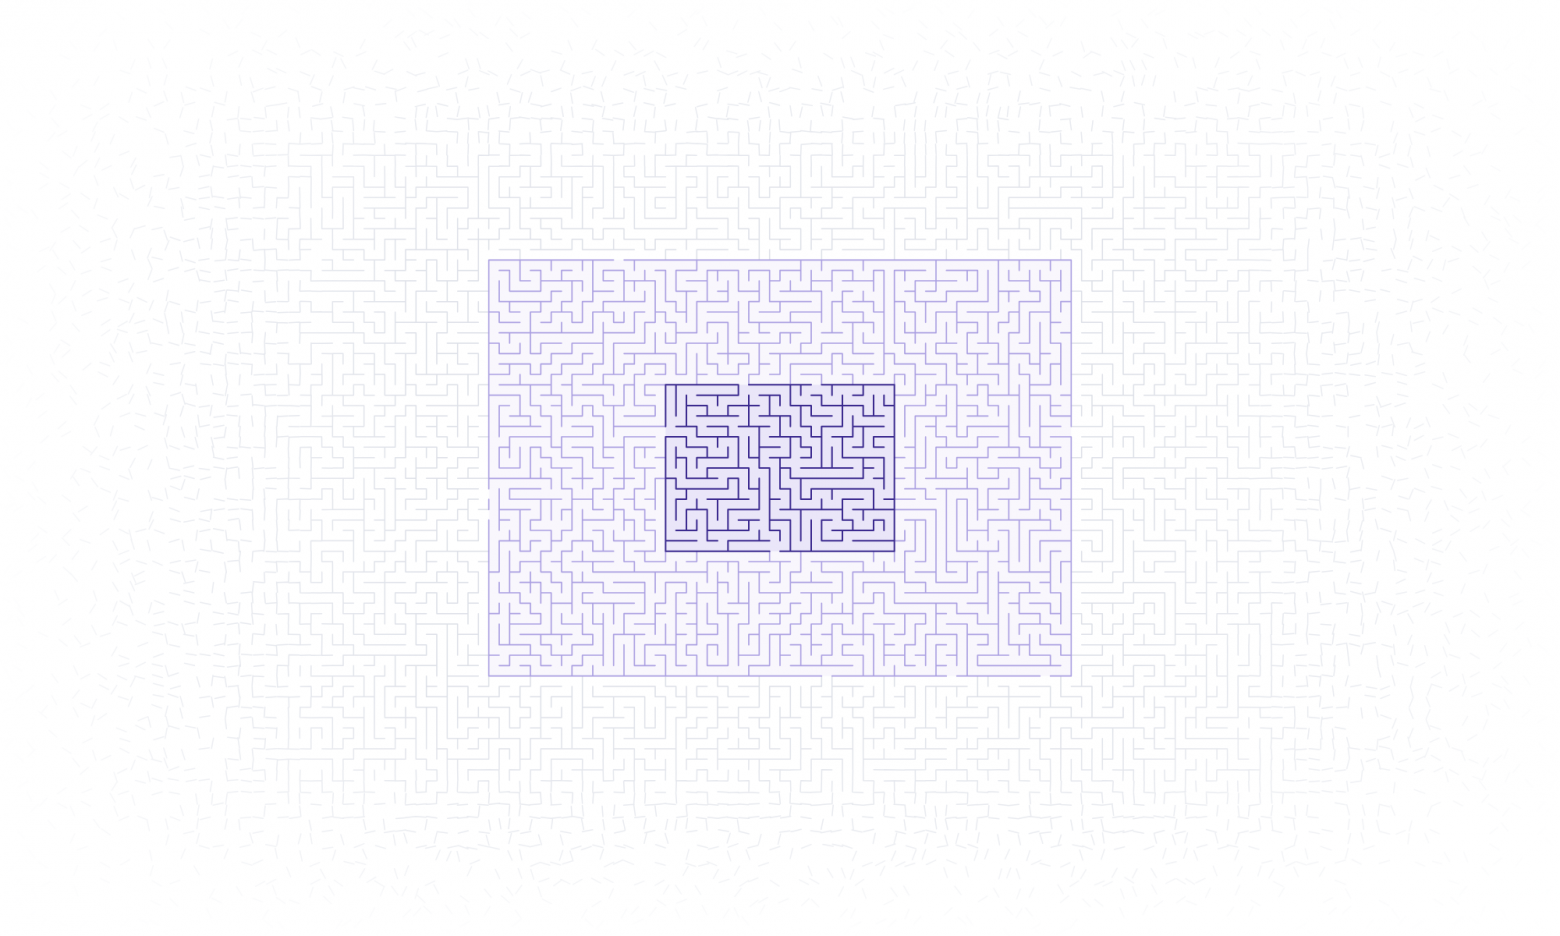
Внутренняя область доступна людям. Более крупную систему могут обслуживать агенты, но это ещё не значит, что они способны вывести её обратно к меньшей сложности. Внешняя область выходит за пределы доступных вычислительных ресурсов. Статичная версия исходной схемы.
Если слишком долго и слишком далеко двигаться вперёд, не поддерживая и не восстанавливая согласованность, то при нынешних тенденциях мы окажемся там, где для сопровождения систем придётся использовать агентов. Системы станут настолько огромными и необозримыми, что сами мы уже не справимся. Но если мы там застрянем и выяснится, что агенты не способны проделать работу по исправлению систем и вывести нас обратно, положение окажется весьма неприятным:
Мы будем заперты в модели разработки, которая медленно разрушает наши системы, сколько бы сил мы ни тратили на их исправление.
Это не значит, что системы вообще никогда не удастся починить. Но на восстановление могут уйти годы или даже десятилетия. А всё это время мы не сможем выпускать новые функции и продвигаться в решении множества других острых общественных проблем.
Это я и называю декогеренционным коллапсом. И боюсь его гораздо сильнее, чем неуправляемого сверхинтеллекта, потому что он уже происходит прямо сейчас, у нас на глазах.
Хочу ещё раз уточнить, что определённая польза от ИИ есть. Просто, на мой взгляд, она скорее во вспомогательных задачах, чем в замене основных рабочих процессов или полностью автономной работе. Мне очень близок анализ «обратного кентавра» Кори Доктороу [31]. Не машина должна управлять нами, а мы — машиной. Подробнее о моём подходе к этому в работе и жизни можно прочитать в моей «Политике и руководстве по использованию ИИ».
Как я неоднократно говорила в этом эссе, декогеренция не новая проблема. Она существует с начала человеческой цивилизации, а возможно, и дольше. Это естественная разновидность распада или деградации, своего рода энтропия, с которой мы всегда имели дело и всегда будем иметь дело. С учётом этого хочу оставить вам две последние мысли.
Первая. Декогеренция меняется только тогда, когда меняются сами системы. Поэтому, как бы плохо всё ни стало, мы всегда можем перестать двигаться дальше и начать выбираться обратно. Если ИИ завёл нас глубоко в ловушку, на полное восстановление могут уйти годы или даже десятилетия, но труднее всего будет в начале. Затем улучшения начнут накапливаться снежным комом, если мы продолжим повышать согласованность и доведём работу до конца. Если улучшить систему лишь настолько, чтобы снова вернуться к старым привычкам, мы просто запустим цикл заново.
Вторая. У нас уже есть процессы, которые, как известно, со временем повышают согласованность. Люди нашли способы создавать более согласованные системы. Во многом именно эти системы и обеспечили размах и масштабы технического прогресса последних нескольких столетий.
В частности, процесс разработки открытого ПО, которому мы обязаны значительной частью согласованности в программировании, настолько успешно её создаёт, что в ряде по‑настоящему поразительных аспектов опередил корпоративную разработку. Но подробнее об этом в следующем эссе.
Источники
Нумерация и состав библиографии сохранены по оригиналу. Названия работ оставлены на языке публикации, чтобы их было проще найти.
-
Ship of Theseus. Wikipedia.
-
Being picky with the plumbing work in my new house. r/Plumbing, Reddit.
-
Space‑based data center. Wikipedia.
-
Fiona Chen and James Stratton. Artificial Intelligence in the Firm: Bottlenecks in Software Production. Working paper, Harvard University, August 4, 2026.
-
Hao He, Courtney Miller, Shyam Agarwal, Christian Kästner, and Bogdan Vasilescu. Speed at the Cost of Quality: How Cursor AI Increases Short‑Term Velocity and Long‑Term Complexity in Open‑Source Projects. 23 rd International Conference on Mining Software Repositories (MSR ’26), 2026.
-
Yue Liu, Ratnadira Widyasari, Yanjie Zhao, Ivana Clairine Irsan, Junkai Chen, and David Lo. Debt Behind the AI Boom: A Large‑Scale Empirical Study of AI‑Generated Code in the Wild. arXiv:2603.28592, 2026.
-
Cory Doctorow. AI turns Amazon coders into Amazon warehouse workers. Pluralistic, May 27, 2025.
-
Clive Thompson. When Robots Take All of Our Jobs, Remember the Luddites. Smithsonian Magazine, January 2017.
-
Robert C. Allen. Engels’ pause: Technical change, capital accumulation, and inequality in the British industrial revolution. Explorations in Economic History, 2009.
-
Technological singularity. Wikipedia.
-
Tom Reed. The Goodhart Singularity. Meagre Protestant History, May 7, 2026.
-
Goodhart’s law. Wikipedia.
-
Tom Davidson. Forethought.
-
Tom Davidson. Data bottlenecks won’t prevent an intelligence explosion (but they will slow it down). Forethought, September 8, 2026.
-
Daniel Kokotajlo and Eli Lifland. Takeoff Forecast. AI 2027, April 2025.
-
Daniel Eth and Tom Davidson. Will AI R&D Automation Cause a Software Intelligence Explosion?. Forethought, March 26, 2025.
-
Reinforcement learning. Wikipedia.
-
AlphaZero. Wikipedia.
-
AlphaStar (software). Wikipedia.
-
OpenAI Five. Wikipedia.
-
Vyacheslav Egorov. What’s up with monomorphism?. mrale.ph, January 11, 2015.
-
Futures and promises. Wikipedia.
-
Melanie Bayley. Alice’s adventures in algebra: Wonderland solved. New Scientist, December 16, 2009.
-
Boolean algebra. Wikipedia.
-
Jimmy Soni and Rob Goodman. A Mind at Play: How Claude Shannon Invented the Information Age. Simon & Schuster, 2017.
-
Claude E. Shannon. A Symbolic Analysis of Relay and Switching Circuits. Master’s thesis, Massachusetts Institute of Technology, 1937.
-
Terence Tao and 24 other Fields Medalists. A Severe Misalignment of AI in Mathematics. What’s new, September 11, 2026.
-
Omarchy. Wikipedia.
-
Bobby Borisov. Arch‑Based Omarchy 4.0.4 Makes Its Custom Linux Kernel the Default. Linuxiac, September 16, 2026.
-
Unix wars. Wikipedia.
-
Cory Doctorow. The Reverse‑Centaur’s Guide to Criticizing AI. Pluralistic, December 5, 2025.
Автор: let_5_go

